
情報リテラシー論03検索エンジンの変遷と進化’26長岡造形大学
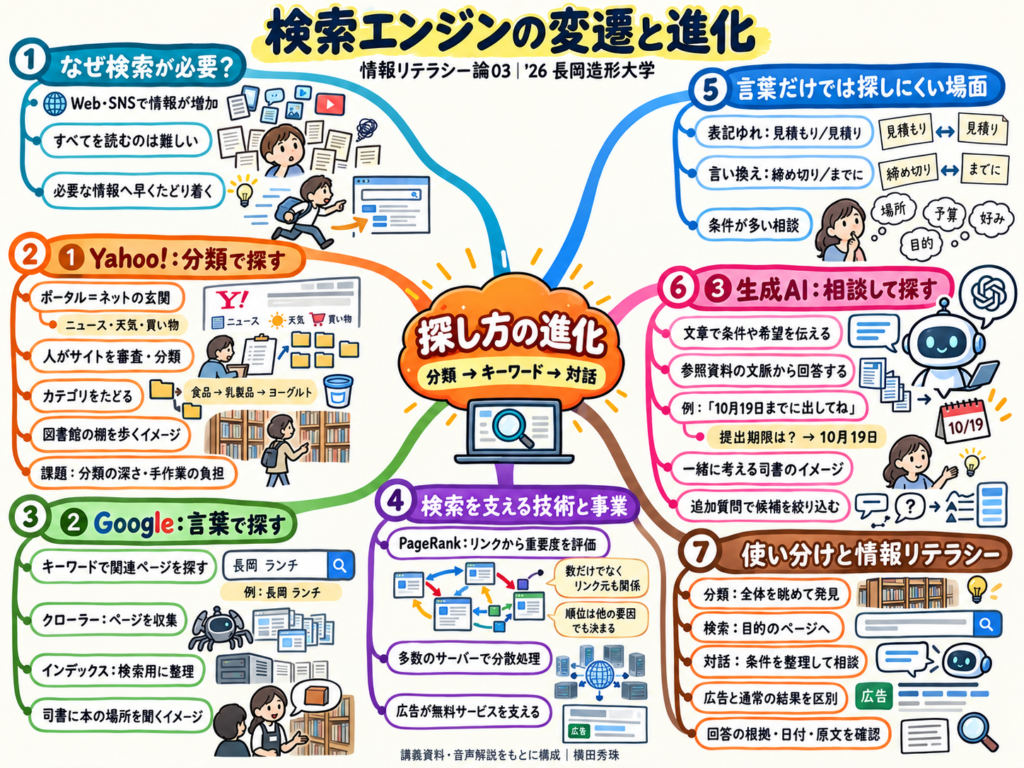
第3回は検索エンジンの変遷。初期は人がサイトを分類するYahoo!のカテゴリー検索が主流でした。分類の限界とされる約82万サイト(7の7乗)を世界のサイト数が超えた翌年の1998年、ページランクを武器にGoogleのキーワード検索が登場し、主役が交代します。今はYahooもGoogleと同じ検索結果を使っており、Googleは広告で稼ぐ会社です。そこへ検索意図を理解する生成AIが現れ、ChatGPTは検索シェア2位に入りました。探し方は「図書館の棚」「店員の案内」「AIの提案」へと進化しています。
詳しくは15分の動画で解説しました。
https://www.youtube.com/watch?v=X5k89sMZbhk
0:00 👋 導入・今日のテーマ紹介 1:07 📊 AIが作った28枚のスライド 1:40 🎵 鼻歌からAIで1曲を作る過程 2:11 💡 ひらめきの材料は蓄積したインプット 2:40 🌐 デジタル情報量の爆発的増加 3:15 🤖 AI生成記事が公開記事の半分に 3:50 🕸️ ワールドワイドウェブと検索の仕組み 4:17 🏆 日本でYahoo!がトップを取った理由 4:45 🍱 幕の内弁当とポータルサイト 4:55 🗄️ インターネットアーカイブでデザインを学ぶ 5:05 🔢 選択肢は5〜7個が理想 5:50 📂 カテゴリー検索とキーワード検索の違い 6:10 👥 人が審査するYahoo!カテゴリーの限界 6:35 💴 カテゴリー登録の審査料と終了 7:05 🔄 自社開発か他社から借りるか 7:34 🤝 YahooとGoogleの検索結果が同じ理由 7:50 💰 検索の初期設定にお金を払う理由 8:10 🔍 BingとChatGPTの関係 8:35 📅 Yahoo!の検索技術契約の行方 8:55 📢 Yahoo!の自社サービス出しすぎ問題 9:05 🧰 ツールバーからアドレスバーへ 9:55 🖥️ 検索とAI競争を支える計算資源 10:15 🔗 ページランクとバックリンク 10:35 📣 Googleは広告収入で成り立つ会社 10:50 📈 SEOとキーワード検索の基本 11:15 📱 SNSの台頭とリンク共有の多様化 11:36 🎬 Google検索の歴史(1997〜2023) 11:55 🧠 検索で人の記憶の仕方が変わる 12:20 🥈 ChatGPTが検索シェア2位に 12:42 ⚔️ ChatGPTサーチとGoogleの本気対決 12:55 ⏱️ 検索の速さと回答の作り方の違い 13:15 💬 自然言語理解と検索意図 13:35 🚀 選ぶ→探す→聞く、3つ目の検索革命 14:05 🖱️ UIの大きな変化とChatGPTの伸び 14:45 🙏 まとめ・エンディング
情報リテラシー論03検索エンジンの変遷と進化’26長岡造形大学
昨日に長岡造形大学で講義したのは
情報リテラシー論の第3回目でした
イーンスパイアの横田です。
https://www.enspire.co.jp
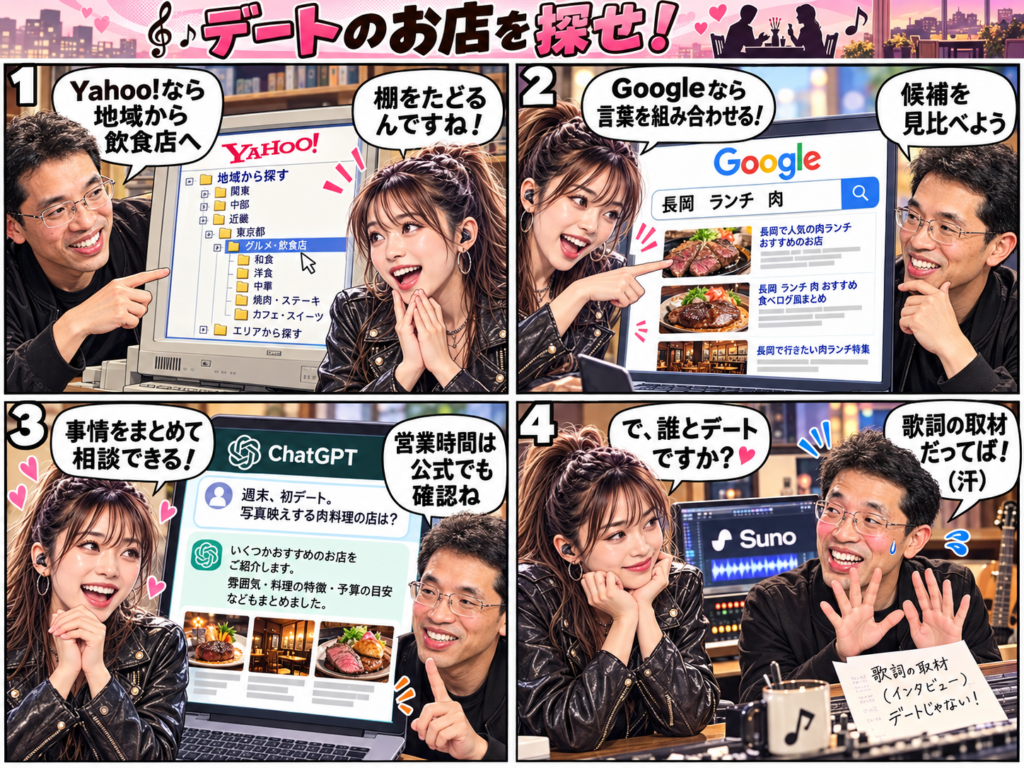
「検索エンジンの変遷と進化」について
曲にしたらMiliaさんが面白いツッコミを
入れてきた件(笑)ウケるんだけど(汗)
探し方が変わっていく / Milia
https://www.youtube.com/watch?v=lUfXXWOKI_I
第3世代の探し方
https://www.youtube.com/watch?v=8cqAVJdCs7c
さて、本題です。
恒例の長岡造形大学で行う
情報リテラシー論の講義が
今年も後期から始まりました。
https://www.nagaoka-id.ac.jp/about/academics/curriculum/liberal-arts/
検索エンジンの変遷と進化として
第3回目の講義を行いました。
情報リテラシー論がある長岡造形大学
情報リテラシー論03検索エンジンの変遷と進化’26長岡造形大学
情報リテラシー論 第3回カテゴリ→キーワード→対話へ、検索エンジン30年の進化
1🎸復習ソング:鼻歌ワンフレーズからAIで一曲
前回「インターネット概論と歴史」の復習として、Miliaの「World Wide Web」を流しながら出席確認。サビは横田が口ずさんだメロディから作曲。
🎙 口ずさむ「世界に張り巡らせたクモの巣を」をサビに
➜
🎸 リフ化同じメロディーをギターリフに変換
➜
🤖 AIが補完前後の展開は全部AIが膨らませる
💡 ひらめき=イーンスパイア
きっかけ(インスピレーション)は人間が持つもの。そこをAIに投げると「自分が作った感じがしない」。去年までの“キーワードでガチャ”ではトップが取れない。🧠 ラージランゲージ“メロディ”
LLMが言葉を組み合わせるように、聴いてきた大量の曲のメロディがくっついてピンと生まれる。インプットがないと出てこない。約3ヶ月で浮かぶようになった。横田秀珠
ちょっとしたフレーズを思いつくだけで、あとはAIが補完してくれるのが面白い
🎵 例:「塩水にくぐらせた恋」もサビだけ自分で考えた曲
2🎬堀江貴文さんが語るGoogle成功の3要因
🔗 ページランク
「引用の多い論文が良い論文」の考え方をWebへ。たくさんリンクされるページ=良いページとして順位付け。🖥 力技の並列処理
エレガントなコードより、安いPCサーバーを大量発注。モニターも箱も不要。待ち行列をなくした。📢 広告の自動化
2000年代初頭に広告の受発注をオンライン化。代理店を介さず誰でも出稿。検索・YouTube・Androidも結局は広告。サブスクは得意じゃない
🔁 今のAIも同じ構図
勝敗を分けるのはハードウェア=半導体(チップ)を買い占めて計算させたか。「結局アナログが強い」
勝敗を分けるのはハードウェア=半導体(チップ)を買い占めて計算させたか。「結局アナログが強い」
3🌊情報爆発:処理しきれない時代へ
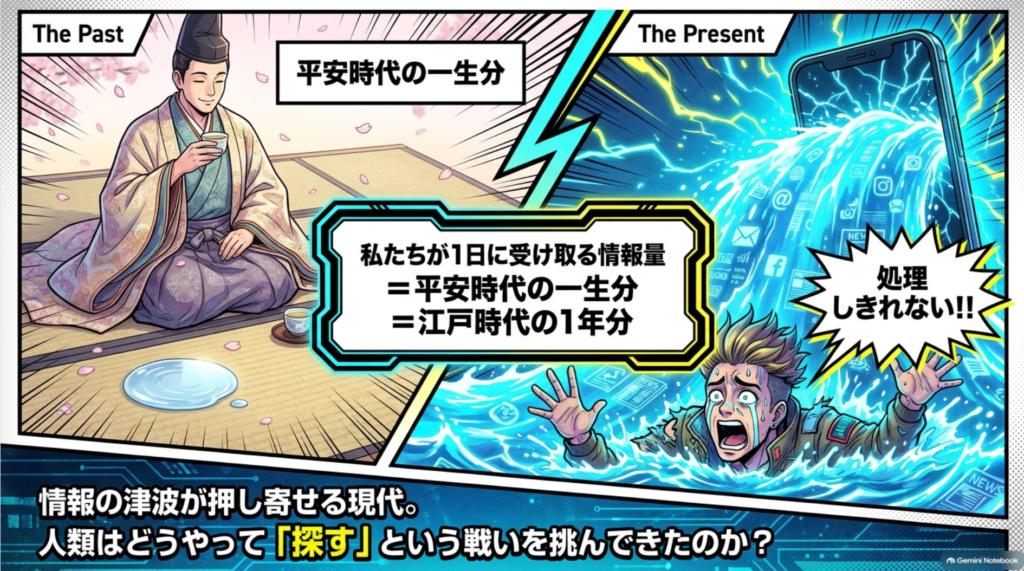
私たちが1日に受け取る情報量は
平安時代の一生分
同じく
江戸時代の1年分
50年前と比べて
5倍
1996→2006年の伸び(IDC資料より)
横田秀珠
フォローしてる人全員の投稿を読んでから寝るなんて、もう無理。アルゴリズムで選ばれたものしか見れない
4📈Webサイト数の爆発と検索の必要性
※対数目盛のイメージ。2018年まではInternet Live Stats、2019年以降はNetcraftと出典が異なる
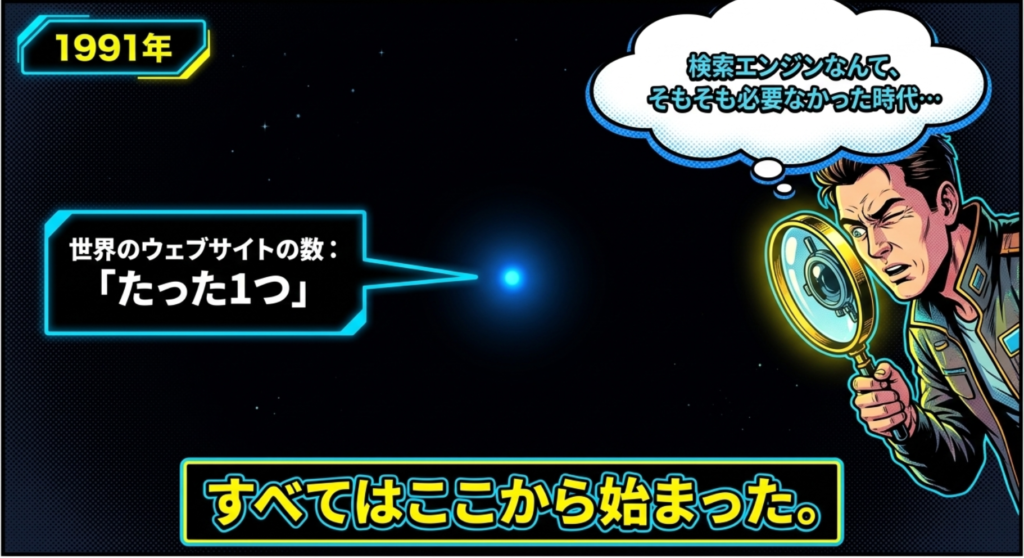
1サイト検索は不要
➜
10サイトリンクを並べればOK
➜
130サイトカテゴリ分けで対応
➜
数千〜分類の中に分類が必要
5✍️AIが書く記事は「まだ14%」か「すでに14%」か
2020.1グルメ口コミのRettyが1年で約2万ページをAIに作成させ、2年でアクセス285倍・570万MAUに。「AIに書かせるのはお高いんでしょ?」の時代
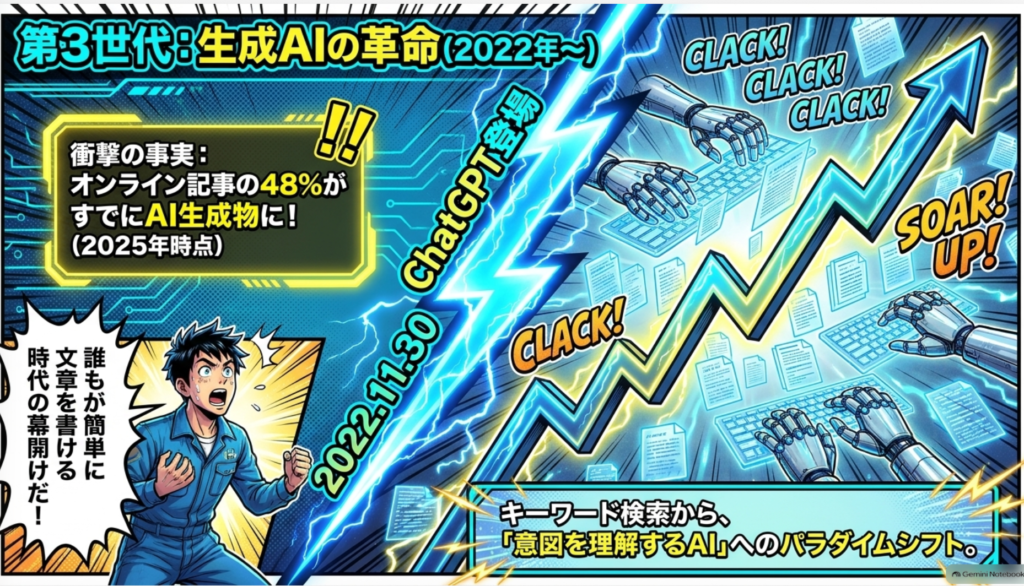
2022.11.30ChatGPT登場=誰でも文章を書ける革命。それ以前のレポートは手打ちかコピペ
2025オンライン公開記事の48%がAI生成に(2026年には9割という予測も)
🔍 Google検索上位の記事
🤖 AIチャットの引用元
横田秀珠
2022年より前はゼロ。14%で止まることはない。問題はどのペースで増えるか
6👑Yahoo!の天下からGoogle一強へ
🌐 サイトの人気(アクセス数)
初期AOLが1位、Yahoo!が2位、MSNが3位
2001Yahoo!が世界で最も人気のサイトに
2006Googleが逆転し一強体制へ
🔎 検索エンジンのシェア
1994Yahoo!誕生(Googleより4年早い)
1998Google誕生。当時はYahoo!かAltaVista
1999Yahoo!がAltaVistaを抜き世界トップ
2002Googleが抜き、以降ずっと1強
🇯🇵 日本では横田が起業した2007年ごろ「Yahoo!7:Google3」と言われるほどYahoo!優勢だった。
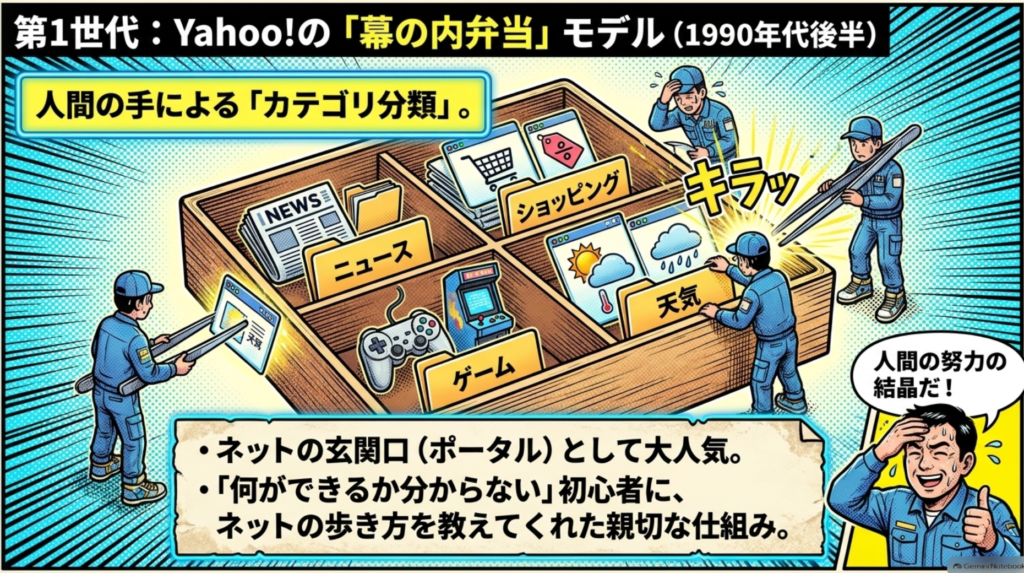
7🍱ポータルサイトは「幕の内弁当」
🚪 玄関口(ポータル)としてのYahoo!
ブラウザのホームをYahoo!に設定するのが流行。ショッピング・天気・ニュース・ゲーム・占い…ネットで何ができるか分からない人に親切。何でも入った幕の内弁当が日本人好み。🔲 Googleは窓だけ
開いた瞬間に検索窓があるだけで、何ができるか分からない。でも皆が賢くなると、Yahoo!のメニューは「余計なお世話」「ガチャガチャして見にくい」に。1997年カテゴリが並ぶだけのシンプルなトップ
➜
2001〜07年カテゴリ枠が中央→下へ
➜
2008年右上の「カテゴリ一覧」へ追いやられる
➜
現在カテゴリは消滅
🗂 Internet Archive(Wayback Machine)でURLを入れれば、過去のサイトデザインを遡って見られる。デザインの進化を学ぶ教材に。
8✋選択肢は5が理想、7が限界
5
理想の数スマホの下部メニュー(Instagram・X・TikTok)は5つ
7
日本人の限界PCなら7でもOK
11
海外の人日本人はたくさんから選ぶのが苦手
👕 服屋の店員も一度に5着程度しか見せない。楽天市場のカテゴリも横の数×縦の深さに配慮が必要。
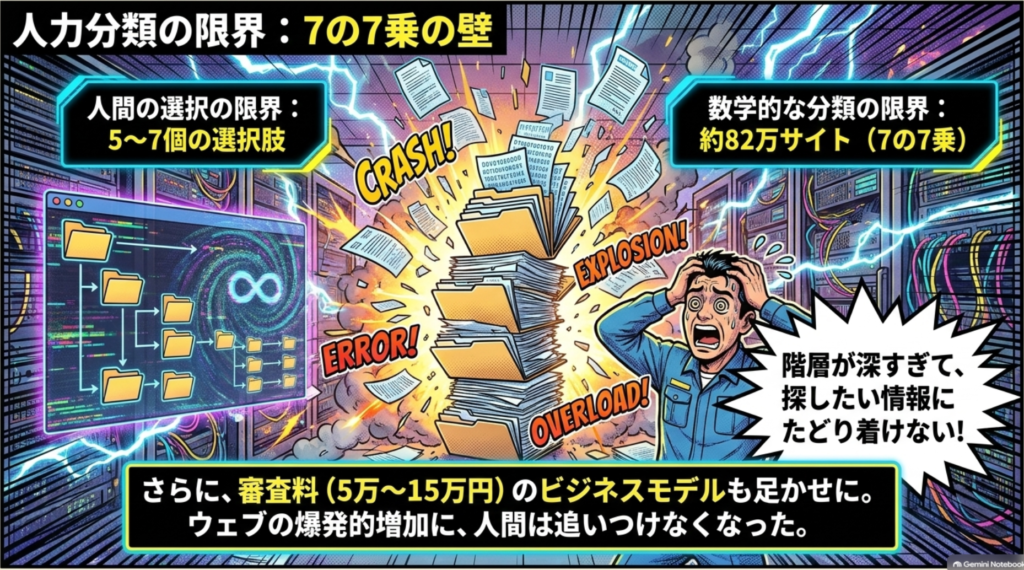
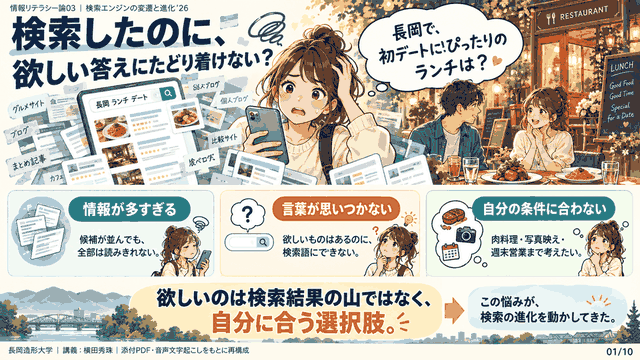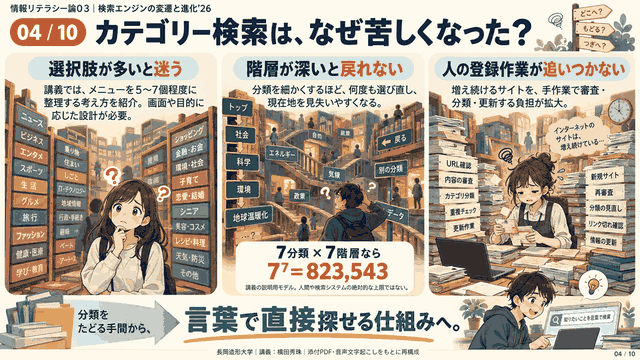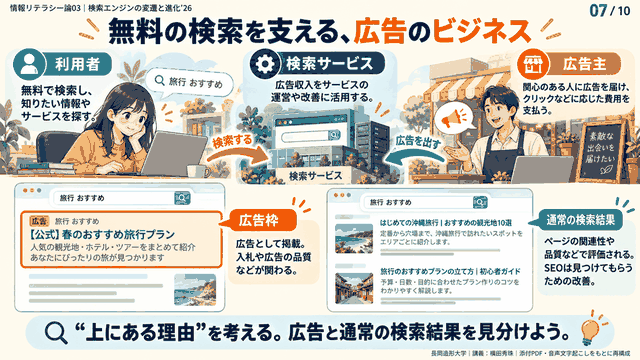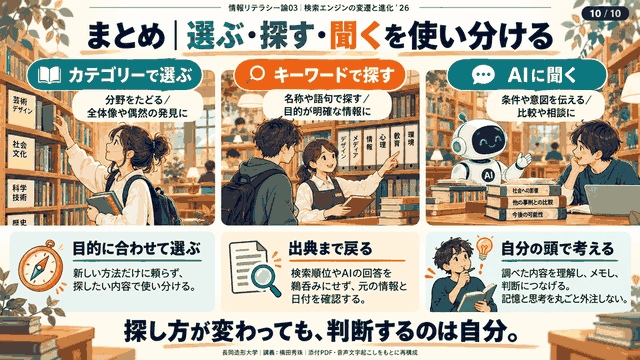
🧮 7の7乗=823,543サイトがカテゴリ分類の限界
横7×深さ7まで。世界のサイト数が1997年にこの数を超えた翌年(1998年)にGoogleのキーワード検索が誕生。「カテゴリでは探しきれない」タイミングを捉えた。
横7×深さ7まで。世界のサイト数が1997年にこの数を超えた翌年(1998年)にGoogleのキーワード検索が誕生。「カテゴリでは探しきれない」タイミングを捉えた。
例:Yahoo!カテゴリ › ショッピング › BtoC › グルメ › 乳製品 › ヨーグルト › アロエヨーグルト
9💴Yahoo!カテゴリのビジネスと終わり
📝 審査料ビジネス
人が選んだ登録サイトが検索上位に出る仕組み(〜2005年)。登録申請には審査料5万〜15万円。登録料ではないので落ちても返金なし。広告ではなくこの収入で回していた。📅 終了の年表
2005カテゴリ登録サイトの優先表示が終了
2014米国でYahoo! Directory終了(日本は継続宣言)
2018Yahoo! JAPANもカテゴリ終了
2026.12.4Yahoo!きっずも終了
🧒 Yahoo!きっずも2004年頃はカテゴリが主役 → 2016年頃は検索窓+カテゴリ → 今はカテゴリではなくタグに。キーワードを考えて検索するのは、実は技術が必要。
10🕵️検索の入口をめぐる裏側
🤝 Yahoo!とGoogleの結果は同じ
2010年12月からYahoo! JAPANはGoogleの検索技術を借用。本来2年契約を延長し続けて16年。「Yahoo!派」「Google派」に違いはない。💰 違いは提携枠
Yahoo!では提携先(例:メディカルノート)が「スポンサー」表示なしで最上位に。それ以外の順位はGoogleと同じ。Googleは公平。🍎 Google→Appleへ支払い
iPhoneのSafariの標準検索にしてもらうため毎年巨額を支払う。検索されれば広告収入の方が大きいから。🔄 揺らぐ1強
サムスンがBingへの変更を検討→見送り。Yahoo!も2025年3月末の満了で変更を検討→見送り。原因はAI。🧰 ツールバー合戦IEに自社検索窓を入れてもらう(今は楽天くらい)
➜
🌐 Chromeのアドレス欄どこでも打てばGoogle検索。Googleの天下
11🔗ページランクの仕組み(テストに出た!)
リンクを貼る=点数を分け与える行為。点数のやり取りを何周も計算し、ある瞬間で止めた値がそのサイトの点数。
横田秀珠
レポートに僕のブログのリンクを貼ってね、と言うのは点数がもらえるから。逆に僕からリンクをあげれば、皆さんの点数も上がる
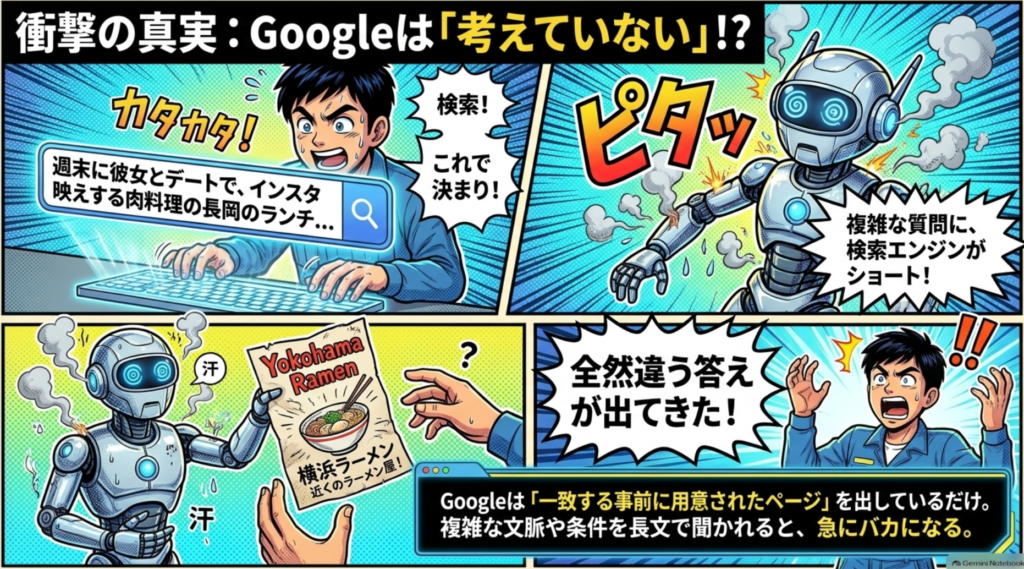
12⚡Googleは速いけど「考えていない」
🔍 Google:用意された答え
よく検索されるキーワードの結果ページを事前に作ってあるから速い。「長岡 ランチ」を夜に検索しても、今日のランチを出してくる。🤖 ChatGPT search:今考える
遅いが、打った瞬間に意図を考える。夜なら明日開いている店を出す。
💬 長文で試すと差が歴然
「今週末初めて彼女とデート。インスタ映え&肉料理好き。長岡市でランチのおすすめを10件」
→ Googleは横浜やラーメン巡りなど的外れ(合うページがない)/ChatGPTは週末の日付も理解して条件に合う店を提示
「今週末初めて彼女とデート。インスタ映え&肉料理好き。長岡市でランチのおすすめを10件」
→ Googleは横浜やラーメン巡りなど的外れ(合うページがない)/ChatGPTは週末の日付も理解して条件に合う店を提示
🔤 キーワード検索の限界
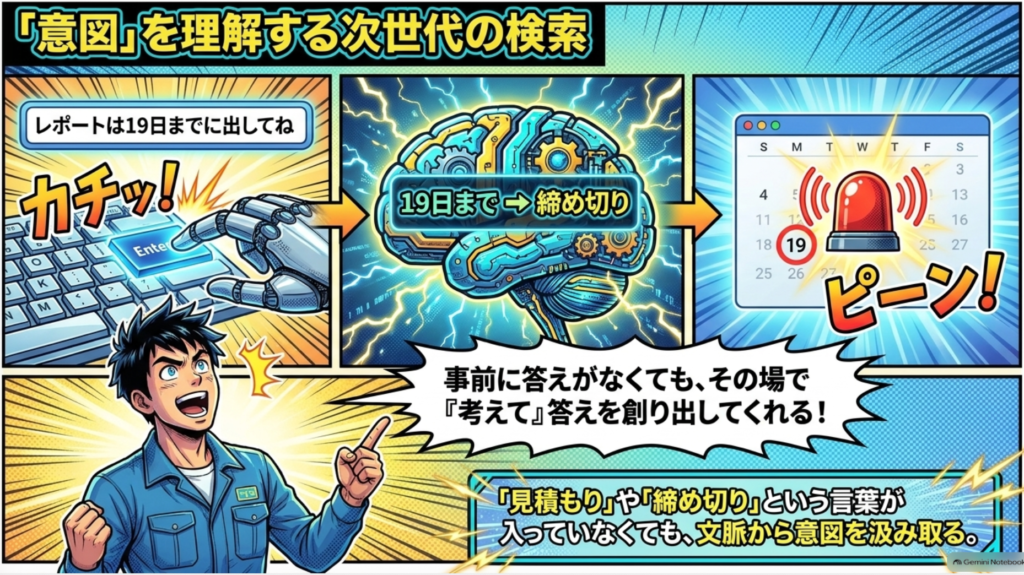
「見積もり/見積り/みつもり/み積もり」「〆切/締め切り/しめきり」…表記が完全一致しないと出ない。🧭 生成AIは意図を理解
「10月19日までに出してね」しか書かれていなくても「締め切りいつ?」で答えられる。➡ 危機感を持ったGoogleはAIモードを追加し、2社が並んだ。
13🧠ググる代償と、Googleの限界
📵 記憶を犠牲にした
検索回数は年々増加。スマホに答えがあると思うと覚えない。昔は友達の電話番号を10件ほど覚えていたのに今は自宅くらい。「ググって出ない情報をテストに出す」=話した内容をメモする力が大事。
🏢 売上構成で見る会社の正体
Googleは広告の会社。Amazonは通販+クラウド。Microsoftはバランス型
2005Google「あと300年で世界中の全情報をインデックスできる」
2008「あと200年」(3年で100年短縮)
2010「無理です」と断念 ← ログインしないと見られないFacebookなどSNS・会員制サイト・クラウドが増加
14📊2026年の検索勢力図に異変
世界の検索・質問クエリ数(1時間あたり/2026年)
🚀 ChatGPTが2位に
2022年の登場から約4年で、他の検索エンジンをすべて抜いた。Googleが慌てる理由。
2022年の登場から約4年で、他の検索エンジンをすべて抜いた。Googleが慌てる理由。
🇯🇵 日本のPC検索シェアで逆転?
横田の感覚では「ありえない」。何が起きているか調べてみよう
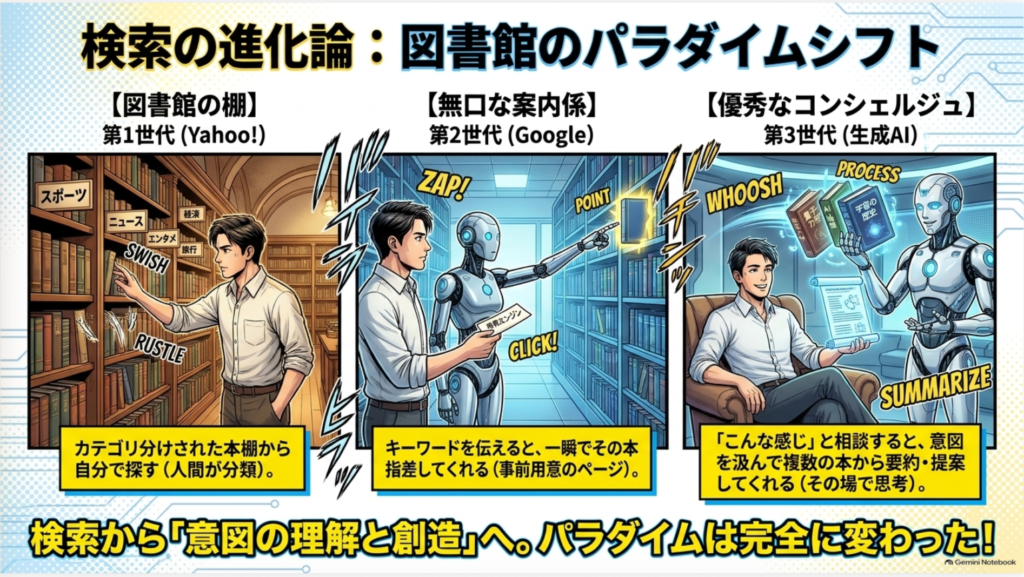
15📌まとめ:探し方は3パターン目へ
📚選ぶ
Yahoo!時代:カテゴリ検索
図書館や百貨店でコーナーをたどる。途中で別のいい本に出会えることも。🧑💼探す
Google時代:キーワード検索
店員に「この本欲しい」と言えば、その場所へ連れて行って指差してくれる。🤖聞く
生成AI時代:対話・相談
「その本はないけど、似たものならこれも」と意図をくんで提案してくれる。横田秀珠
来年の同じ時期に、ChatGPTのシェアがどこまで増えているか楽しみ
情報リテラシー論03検索エンジンの変遷と進化’26長岡造形大学
- はじめに ― 「ググる」が当たり前になった私たちへ
- 音楽で前回を振り返り、Google誕生の「力技」を知る
- あふれる情報と増え続けるウェブサイト、そしてAIが書く記事の時代
- Yahoo!のカテゴリー検索はなぜ主役の座を降りたのか
- 「考えない」キーワード検索から「意図を理解する」生成AIへ
- おわりに ― 探し方の3つ目の時代を、どう生きるか
- まとめ
- よくある質問(Q&A)
はじめに ― 「ググる」が当たり前になった私たちへ
皆さん、こんにちは。横田です。突然ですが、今日一日で何回「検索」をしましたか? 朝起きて天気を調べ、電車の時間を調べ、お昼にランチのお店を調べ、夜には気になった言葉の意味を調べる。数えてみると、もう数え切れないくらい検索していると思うんですね。でも、その検索窓の向こう側で何が起きているのか、そしてなぜYahoo!やGoogleがそれを無料で提供してくれているのかを考えたことは、意外と少ないのではないでしょうか。
この記事は、僕が大学で担当している「情報リテラシー論」の第3回の講義をブログとしてまとめ直したものです。テーマは「検索エンジンの変遷と進化」。人間がカテゴリーを手作業で分けていたYahoo!の時代から、ロボットが世界中を巡回して答えを用意しておくGoogleの時代、そして今、質問の意図を理解して考えて答えてくれる生成AIの時代へ。探し方がどう変わってきたのかを、当時の画面やデータ、そして僕自身の体験談を交えながら、できるだけ分かりやすくお話ししていきます。肩の力を抜いて、昔のインターネットを一緒にタイムトラベルするような気持ちで読んでもらえたら嬉しいです。
音楽で前回を振り返り、Google誕生の「力技」を知る
ステップ1:今回も音楽で前回の講義を振り返る
今回は全15回の講義のうちの3回目です。前回は「インターネット概論と歴史」というお話をいたしました。そこで今回も、まずは音楽で前回の内容を振り返りながら、その間に出席を取るというスタイルで始めました。
使ったのは、AIシンガーのMilia(ミリア)が歌う「World Wide Web」という曲です。タイトルはそのままですね(笑)。前回の講義内容、つまりインターネットの誕生からブラウザの移り変わり、ドメインやIPアドレスの仕組みまでを、1曲にぎゅっと詰め込んだ曲になっています。
この曲の歌詞には、前回お話しした内容がそのまま入っています。たとえば次のようなフレーズです。
軍の技術だった インターネット 扉ひらいた翌年 Yahoo!とAmazonが 生まれた Windows95 はじめから入ってた 「e」のアイコン 押すだけで誰でも繋がる 大地が揺れ 心が揺れ 業界が揺れた1995 失われた30年も そこから始まった
インターネットはもともと軍の技術だったこと、扉が開いた翌年にYahoo!とAmazonが生まれたこと、Windows95には最初から「e」のアイコン(Internet Explorer)が入っていて押すだけで誰でもつながれたこと。そして1995年は阪神・淡路大震災で大地が揺れ、人の心が揺れ、インターネットの登場で業界も揺れた年であり、「失われた30年」もそこから始まった、という内容です。
続くブロックでは、こんな情景を歌っています。
色もない 写真もない 文字だけのページ 青い文字に アンダーライン それがリンク 検索のない時代は たどるしかない リンク集を 思いついたのがYahoo!
最初のウェブページは色も写真もなく、文字だけでした。青い文字にアンダーラインが引いてあって、それがリンク。検索というものがない時代は、リンクをたどっていくしかなかったんですね。そこで「リンク集」を思いついたのがYahoo!だったわけです。これは今回の講義のテーマにそのままつながる話なので、ぜひ覚えておいてください。
そしてサビです。
世界に張り巡らせた クモの巣を World Wide Web www インターネットの糸は リンク 数字はIP(アドレス) 名前はドメイン ふたつを結ぶ DNS
World Wide Webとは「世界に張り巡らされたクモの巣」という意味です。インターネットの糸にあたるのがリンク。住所の数字がIPアドレスで、名前がドメイン、その2つを結びつけるのがDNSです。
ほかにも、ドメインは英数字とハイフンだけで世界に一つしかなく早い者勝ちの陣取りゲームであること、「i」で始まる名前はもう誰かのものだったので「e」から始めて「イーンスパイア」にしたという僕の会社の社名の由来、更新料を忘れるとある日他人のサイトになってしまうこと、人工知能(AI)から超知能(SI)へという流れの中で、ドットの後ろの国別ドメインもアンギラ(.ai)からスロベニア(.si)へ、という話も歌詞に入っています。
さらに、
通信の半分を ついにボットが超えた 人がひとつ開く間に AIは100のサイトを巡る 見ているのは デザインじゃなく 裏のソース 文字だけを読む あの最初の ページのように
という、インターネットの通信の半分をついにボットが超えたという現在の話。人間が1つのページを開いている間に、AIは100のサイトを巡っている。しかもAIが見ているのはデザインではなく裏側のソースで、文字だけを読んでいる。まるで、あの最初の文字だけのウェブページのように、という対比です。
2回目のサビでは「インターネットの糸はリンク、いいドメインは高く売買される、.si(ドットエスアイ)バブルは来るのか?」と問いかけています。
その後は通信速度の歴史です。「ピポパポ」と電話をかけてつないだ夜、「終わったら切ってね」と言われたダイヤルアップの時代。つないだ分だけ料金がかかりました。通信速度は初めはノロノロでも、ある線を越えると一気に広がる。自転車、バイク、車、スーパーカー、そして今の5Gは飛行機。ところがミリ波のアンテナが足りずに「なんちゃって5G」になっている。そうしているうちに敵は空からやってきた、地球を囲むスターリンク、というわけです。
ブラウザについても、モザイク、ネットスケープ、IE(Internet Explorer)、Chromeと、ブラウザの王者は4回も入れ替わってきた。次はAIブラウザかと思えば、AIはもうパソコンごと動かしている。3回目のサビは「ネットはスピードが命だし、つながらないと話にならない」。そして最後は「善玉菌のウイルスみたいなAIエージェント、どこまで見せるか教えるのは人の役目」で締めくくっています。
皆さん、復習になりましたか? なんとなく思い出しましたか?
| 歌詞のテーマ | 前回の講義で扱った内容 |
|---|---|
| 軍の技術だったインターネット、1995年 | インターネットの起源とWindows95、Yahoo!とAmazonの誕生 |
| 文字だけのページ、青い文字のリンク | 最初のウェブサイトとハイパーリンク、リンク集としてのYahoo! |
| IP・ドメイン・DNS | インターネットの住所と名前の仕組み |
| ドメインは早い者勝ち | ドメイン取得と更新、社名「イーンスパイア」の由来、.aiと.si |
| ボットが通信の半分を超えた | AIがウェブを巡回し、ソースの文字を読む時代 |
| ピポパポの電話回線から5G・スターリンクへ | 通信速度の歴史 |
| モザイク→ネットスケープ→IE→Chrome | ブラウザの覇権交代とAIブラウザ、AIエージェント |
ステップ2:鼻歌のワンフレーズから、AIで一曲を作る
この曲にはサビの部分があったと思うんですけど、実はサビは僕が作曲しているんです。どうやって作曲しているかと言うと、口で口ずさんでいるだけなんですね。
口ずさんだ内容をAIに歌わせると、あんなに上手に歌ってくれます。僕の生歌を聞きたいという方は、コメントで「聞きたい」が10人集まったら聞かせてあげます(笑)。
作り方は2つあって、1つは自分が思ったことをそのまま歌っているだけです。たとえば「世界に張り巡らせたクモの巣を」というサビの部分だけ、「ダブル、ダブル、ダブル」の部分だけを口ずさんで録音し、それをAIに入れて「ここをサビにして」と指示します。そして、このサビの部分から、あとは全部膨らませて「AIに考えて」と作らせているので、あそこだけはちゃんといい感じになっていると思います。
ただ、これをそのままやるとサビに鼻歌のメロディーが入るのですが、それだけだと少し弱い。そこで次にどうするかと言うと、このメロディーをギターのリフに変えてもらうんですね。ギターのリフに変えると、また違った印象になります。そして、この2つ、つまり鼻歌のサビとギターのリフを元にして、さっきの曲を作っているわけです。
| 工程 | 誰がやるか | 内容 |
|---|---|---|
| ① 自分でサビを口ずさむ | 人間(僕) | 「世界に張り巡らせたクモの巣を」などの短いメロディーを録音 |
| ② サビの位置を指定する | 人間(僕) | 録音した音声をAIに渡し、「ここをサビにして」と指示 |
| ③ 同じメロディーをギターのリフに | AI | 鼻歌のメロディーを楽器のフレーズに変換 |
| ④ サビとリフから曲全体を広げる | AI | イントロ、Aメロ、間奏、伴奏などを補完して一曲にする |
今までであれば、こういうワンフレーズぐらいを思いついて「あ、いい曲ができそうだ」となっても、結局その前後を自分で考えないと曲は作れませんでした。それが今は、ちょっとしたフレーズを思いつくだけで、あとはAIが補完してくれる。これがやっぱり面白いですね。
自分の気になったフレーズや、面白いことがあったときに、そこをフックにして曲を作れるようになったのも面白いところです。今までであれば、プロデューサーという人が「こんな感じで作って」と作曲家や作詞家に伝えると、その人がピンと来て「なるほど、いいですね。じゃあそれで作りますよ」と作っていました。今はそれをAIに頼めば作れる。だからこそ、ちょっとしたひらめきが大切なんです。それを英語でインスピレーションと言いますが、僕の会社名「イーンスパイア」もここから来ています。ひらめきさえあれば、形になる時代なんですね。
ステップ3:AI任せの「ガチャ」から、自分の着想を起点にする
皆さんが作品を作るときも、たぶん同じだと思うんです。最初のきっかけというか、何かピンとくるものがあるじゃないですか。そこがないと始まらないんですよね。だから、そこはやっぱり人間が持っていてほしいものですし、そこをAIに丸投げしても、自分が作った感じが全然しないですよね。
最初の自分のスタートが自分の着想でないと、自分の作品という感覚が持てない。だから最近はそこを意識するようになっています。去年までは、いわゆる「ガチャ」で、キーワードだけを入れてAIに書かせていました。でも、それだとトップが取れないんですね。
上のほうには、やっぱりそういう工夫をしている人たちがいっぱいいるので、僕の作り方もだんだんと、なんと言うのかな、アナログになっていっているというか。そうですね、「インスピレーションがどこから出ているか」が大事になってきているんです。
| 比較項目 | 以前の作り方(ガチャ) | 今、意識している作り方 |
|---|---|---|
| スタート地点 | AIにキーワードを渡す | 自分の鼻歌・ふと聞いた言葉・日常で引っかかった出来事 |
| AIの役割 | 案を出してもらい、良さそうな曲を選ぶ | 人間の核となる着想を膨らませ、補完する |
| 自分が作った感覚 | 薄い | ある |
| ランキングでの結果 | 上位の作品に勝ちにくい | 着想の独自性で勝負できる |
ステップ4:ひらめきの材料は、蓄積したインプット ―「ラージランゲージメロディ」
インスピレーションの話は今日の講義の中でもしますが、ラージランゲージモデル(大規模言語モデル)、つまり今のChatGPTのようなものは、言葉と言葉を組み合わせて文章を書いてきます。それに対して僕の場合は、言わば「ラージランゲージメロディ」なんですね。今まで僕が聞いてきた音楽の曲数がめちゃくちゃ多くて、おそらくその曲のメロディーが頭の中でガチャガチャとくっついて、ピンと生まれてくるんだと思います。
これは、おそらくほとんどのミュージシャンもほぼ同じだと思います。だから、誰かのメロディーに似通うこともあるかもしれませんが、何かと何かがピッとくっついてひらめく、というようなものではないかと思っています。
そのためには、たくさんインプットしないと外には出てこない。でもこれは経験上の話で、僕もこの半年、いや半年は言いすぎかな、3ヶ月ぐらいですよ。それまでは「曲なんて、メロディーなんて浮かばねえよ」と思っていたのに、全然浮かぶようになるんです。
講義ではもう1曲、「塩水にくぐらせた恋」という曲も流しました。この曲もサビのところだけ僕が考えています。こういうふうにフレーズを考えて、それを曲にするというのが結構面白いんです。余談はそのぐらいにしておきましょう。
| ステップ | 内容 |
|---|---|
| ① たくさんの音楽を聴く | 過去に聴いた曲やメロディーが、着想の材料として残る |
| ② 頭の中で組み合わせが変わる | 異なるフレーズの記憶が結びつき、新しいメロディーが浮かぶ |
| ③ 浮かんだフレーズを形にする | 鼻歌で残し、AIと一緒に曲へ膨らませる |
| 僕の体験 | 以前は「メロディーなんて浮かばない」と思っていたが、3ヶ月ほどで浮かぶようになった |
ステップ5:堀江貴文さんが語る、Google誕生の秘密
さて、今日は検索エンジンの話をしなければいけないので、まずは堀江貴文さんがGoogleについて解説している動画を見てもらいました。毎年この動画を見てもらっているのですが、とても示唆に富んだ内容なので、ポイントを詳しくご紹介します。
堀江さんによると、Googleは1998年に、ラリー・ペイジとセルゲイ・ブリンという2人がアメリカで作った会社です。堀江さんいわく、2人は堀江さんと同い年で、インターネット黎明期に彼らの世代がみんなインターネットの会社を作り始めた、その流れの中で生まれたのがGoogleだそうです。
そもそも検索エンジンは、インターネット黎明期から必要だと言われていました。その中には、いわゆるインデックス型というか、サイトをカテゴリーに分けたりする検索エンジンがありました。それがYahoo!で、アメリカで創業してわっと注目を浴び、ソフトバンクが投資をしてYahoo! JAPANができた、という流れがありました。
もう1つが、キーワード型の検索エンジンです。こちらは「クローラー」と呼ばれるロボットが、世界中のウェブサイトを自動的に見て回り、その情報を中央のサーバーに貯めて、そこでキーワード検索ができるようにする、というアプローチです。
論文の引用数をウェブに持ち込んだ「ページランク」
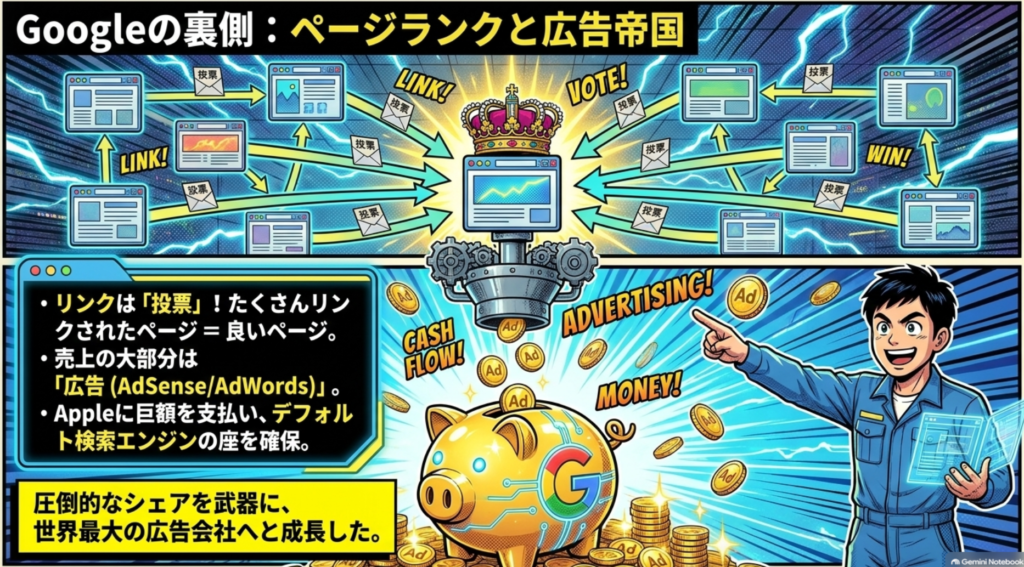
Googleが優れていたのは、そのランキングの考え方です。論文の世界では、たくさん参考にされた論文、つまり引用回数が多い論文が良い論文だと言われています。同じ考え方をウェブページに持ち込んだんですね。
たくさんリンクされているページは、良いページに違いない。それ以外にもアクセス数などいくつかの要素があるのですが、それらを総合的に判断して「ページランク」というものをつけた。そして検索結果の上位に、ページランクの上位のページが来るようにした。そのページランクの出来が良かったらしい、と堀江さんは話しています。堀江さん自身も同じようなサービスを作っていたので、そのあたりはよく知っていて、自分たちも同じようなことをやっていた、まったく同じことを、とも言っていました。
Google以前にも全文検索エンジンはあった
実はGoogle以前にも、全文検索エンジンを作っていた会社はいくつもありました。当時いちばん有名だったのは「AltaVista(アルタビスタ)」というサービスで、確かDEC(デック)という会社が作っていたものです。AltaVistaはすごい人気で、当時は「Yahoo!かAltaVistaか」という感じでした。そこへ一気にGoogleがわっと来たわけです。
もう1つのポイントは、PCサーバーを山のように並べた「力技」
Googleのもう1つのポイントは何だったかと言うと、データセンターにPCサーバーを山のように入れて、並列処理をさせたことです。つまり、実は力技だったんですね。
たくさんの人、たとえば1億人が同時に検索しているとします。Googleがすごいと思ったのは、言わば1億台を準備してしまうという発想です。そうすると待ち行列がなくなります。1つのサーバーが1人に対応していたら、それは速いですよね。
それまでのみんなの考え方は、エレガントで処理の速いプログラムを書き、それを処理速度の速い高価なマシンで動かして、1台のサーバーで同時に1万人が検索できるようにする、という方向に向かっていました。ところがGoogleは安いPCを大量に発注した。しかもすごいのは、検索エンジン専用だから余計なものはいらない、モニターもいらないし箱(筐体)もいらない、という割り切り方です。
堀江さんは計算の例として、こう話しています。100億円をかけるとして、1台200ドルだとしたら50万台買っても100億円で済む。そうしたら50万人が同時にアクセスしても、1人あたりサーバー1台で対応できる。100万人来ても、サーバー1台あたり2人しか処理しなくていい。そういうことをGoogleはやったんだそうです。
だから、そんなにエレガントなプログラムを書かなくてもよかった。力技でよかったんだ、と堀江さんも1年後に気づいたそうです。堀江さん自身も力技でやろうとはしていたけれど、中途半端な力技だったと振り返っています。プログラマーとしてのコンプレックスがあって、もっとエレガントなコードを書きたいと思ってしまった。でも、それは違っていた。下手なコードでもよくて、サーバーの台数を増やせばよかったんだ、と。
さらに、10万台も発注すればディスカウントが効きます。1台あたり100ドルぐらいまで下がったりするわけで、それを世界中のデータセンターでやり出して、うまく軌道に乗ったそうです。
広告の受発注を自動化したことが、もう1つの転機
Googleのもう1つのきっかけは、広告の受発注を自動化したことです。たとえば求人の広告を出したければ、AdWords(アドワーズ)やAdSense(アドセンス)にログインして、IDとパスワードをもらい、許可されれば広告を入れられるようになっています。個人営業のような担当者がつくこともありますが、基本的にオペレーションはすべてネット上、ウェブサイトでできるようになっている。
これは言ってみればかなり画期的なことでした。それまでは間に広告代理店が入って、打ち合わせをして、「この枠にこれだけですね」と決めて、請求書をやり取りして……ということをやっていたわけです。それをすべてオンラインで自動的にできるようにした。今では当たり前ですが、それを2000年代初頭にやった。それで売上がばっと伸びたそうです。
Googleは「広告の会社」である
結局Googleは、今でもAdSenseやAdWordsといった広告が売上の大半を占めています。YouTubeの広告も同じ仕組みです。あの会社は売上の9割以上が広告で、広告ビジネスの会社なんだ、と堀江さんは言います。
いろいろなことに手を出しているけれど、意外と収益化できているのは、結局Googleの検索エンジンとYouTubeだけ。AndroidもGoogleが開発していますが、あれも結局は広告枠なんです。Androidでは「Googleの検索エンジンを使いなさい」というルールになっていて、そこにAdWordsやAdSenseの広告が出ているだけ。検索エンジン事業もYouTube事業もAndroidも、主要な事業は全部広告なんです。
だからあの会社は、有料サブスクリプションのビジネスはあまり得意ではない。堀江さんの規模からすれば数十億、数百億の事業は結構な話だと思うけれど、Googleの広告売上からすれば微々たるものなので、すぐやめてしまう、という話でした。
| Google成功の要因 | 内容 |
|---|---|
| ページランク | 論文の引用数の考え方をウェブに応用し、多くリンクされたページを上位に |
| 力技のサーバー投資 | 安いPCを大量に並べて並列処理。モニターも箱も省き、待ち行列をなくす |
| スケールメリット | 10万台単位の発注で1台あたり100ドル程度まで下がることも |
| 広告の自動化 | 広告の受発注をすべてオンライン化(2000年代初頭) |
| 収益構造 | 検索・YouTube・Androidのいずれも広告が柱。売上の9割以上が広告 |
ステップ6:Googleの「力技」は、今のAI競争とまったく同じ
毎年この動画を見てもらっているのですが、振り返ってみると結構面白くて、これって今のAIと同じなんですよね。今のAIも、頭のいい会社と頭の悪い会社、まあ成績のいい会社と成績の悪い会社の違いは、ハードウェアを突っ込めたかどうかという話なんです。
今で言えばチップ、つまり半導体です。半導体をたくさん買い占めて、たくさん計算させたところが勝っている。優秀なプログラムを書いたとか、優秀な仕組みを作ったから成功しているのではなく、結局アナログ、つまり物理的な設備が強いという話なんです。検索エンジンも同じ話なんですね。
| 観点 | 検索エンジンの競争(1990年代末〜) | AIの競争(2020年代) |
|---|---|---|
| 勝敗を分けたもの | PCサーバーを大量に投入できたか | 半導体(チップ)を大量に確保できたか |
| 共通する基盤 | 計算を実行する物理的な設備 | 計算を実行する物理的な設備 |
| 必要なもの | 調達・設備・資金 | 調達・設備・資金 |
| 教訓 | エレガントなプログラムより台数 | 優秀な仕組みだけでなく計算資源への投資 |
画面上のサービスの裏側には、機械・設備・調達の競争があります。プログラムや仕組みの工夫と、設備への投資の両方を見ることが大切だということですね。今日はこの話をもう少し掘り下げていきたいと思います。
あふれる情報と増え続けるウェブサイト、そしてAIが書く記事の時代
ステップ1:1日に受け取る情報量は「平安時代の一生分、江戸時代の1年分」
では、ここから本題の「検索エンジンの変遷と進化」に入っていきます。最初のスライドにはいろいろ書いていますが、重要なのは左上に書いた一文です。
「私たちが1日に受け取る情報量は、平安時代の一生分、江戸時代の1年分」と言われています。
当たり前ですよね。平安時代の人が情報を得ようと思っても、スマホはないし、テレビもないし、今日のニュースが入ってくる場所もない。何か情報を知ろうと思っても検索できないし、インターネットもない。であれば、集められる情報はめちゃくちゃ少ないですよね。
それが平安時代では一生分で、江戸時代には1年かけて集めていた量です。それを皆さんは1日で集めている。50年前と比べても5倍になったという話がスライドに出ていますが、すごい勢いで情報が増えているんです。
情報の受け取り方の変化を、朝一番の行動で比べると分かりやすいです。19世紀は新聞をポストまで取りに行く。20世紀はテレビのスイッチを入れる。そして21世紀は、SNSをベッドからスマホで見る。スライドには新聞、ラジカセ、テレビ、1976年・1995年・2007年のパソコンやインターネット、iPhoneの写真も並べました。
| 時代 | 朝一番の行動 | 情報量のイメージ |
|---|---|---|
| 平安時代 | ― | 現代人の1日分の情報が一生分 |
| 江戸時代 | ― | 現代人の1日分の情報が1年分 |
| 19世紀 | 新聞をポストまで取りに行く | 紙の情報が中心 |
| 20世紀 | テレビのスイッチを入れる | 放送の情報が中心 |
| 21世紀 | SNSをベッドからスマホで見る | 50年前の5倍、処理しきれない量に |
ステップ2:選択可能な情報量と、処理できる情報量のギャップ
その増えた情報を処理しなければいけないので、私たちはいいパソコンを買ったり、いいスマホを買ったりして処理しているのですが、もう処理しきれないぐらいになっています。
スライドのグラフ(IDCの「The Digital Universe in 2020」などのデータ)では、「選択可能な情報量」がぐわっと増えています。1996年から2006年にかけて、選択可能な情報量は532倍になっているのに、実際に消費できた情報量は65倍にとどまっています。2002年ぐらいから急に増え始めていて、ここから先のデータはないのですが、おそらく右肩上がりどころか二次曲線的に増えていると思います。
一方、下の線が情報を処理する能力で、こちらはこのぐらいしか上がっていません。いいパソコンを買ったり、皆さんの情報処理する力が上がったりすることで処理能力自体は上がっているのですが、それ以上に情報が増えているので、情報があふれる状態になっているわけです。
ステップ3:SNSを全部読み切れなくなった理由
もう処理しきれない状態になっていますよね。皆さん、自分の好きなSNSのアカウントの情報を毎日全部受け取ってから寝る、ということはできていないし、全員のストーリーを全部読んでから寝る、ということもできていないと思います。
結局、今はアルゴリズムで選ばれたものしか見られなくなっていて、全員の投稿を全部見るのはもう無理じゃないですか。でも昔はやっていたはずです。フォローしている人も少なかったし、見ている人も少なかったからできた。今はあれもこれも見ていたら、結局全部は見られていない、となっています。
みんな一生懸命処理しようと頑張ってきたのですが、もういい加減みんなも諦めてきた、というのが今ではないかと思います。
| 比較 | 以前 | 今 |
|---|---|---|
| フォロー先 | 少なく、ひと通り読めた | 見たい相手も投稿も増え、すべては追い切れない |
| 情報の流入 | 投稿・動画・ストーリーズが少量 | 大量に流れ込み、未読が積み上がる |
| 人の処理容量 | 端末の性能・読む速さ・使える時間 | 良い端末に替えても、読む時間には限りがある |
| 見ているもの | 全員の投稿 | アルゴリズムで選ばれた情報が中心 |
ステップ4:世界のウェブサイト数の推移(1991〜2026年)
もう1つ、今日調べたデータがあります。ウェブサイトの数の推移です。これ、すごいですよね。1991年、世界のウェブサイトの数は1個しかありませんでした。前回紹介した、いちばん最初のウェブサイトです。ウェブサイトが1個しかないときは、当たり前ですけど検索エンジンはいりませんよね。
1992年には10個あります。10個ぐらいなら、10個のリンクを載せておけばいいから、検索エンジンはいりません。1993年の130個は、ちょっと大変ですね。130行になりますから。でも、カテゴリー分けすればいいじゃないですか。たとえば日本語用が10個、英語が30個というように分ければ、日本語の人は最初から日本語のところだけ見に行けばいい。
1994年になると2,738個。2,700ぐらいと聞くと多いようですが、日本語の中のビジネス用、趣味用というように分けていけば、まだ何とかなりそうですよね。
ところが、ここからどんどん増えていきます。2000年には1,700万サイト(17,087,182)になりました。そこからさらにどんどん増えていって、2014年には9億6,888万2,453、2017年には17億6,692万6,408、2020年には12億2,477万416、そして2026年には14億8,939万6,284(2026年6月値)になっています。
なお、2018年ぐらいまではInternet Live Statsというサイトでデータが出ていたのですが、そこからデータが出なくなったので、2019年以降はNetcraftのWeb Server Surveyという別のデータ元を使っています。カウントの仕方はおそらく違うので、グラフ上はなめらかにつながっているように見えますが、実際はそうではないと思います。ここで言う「ウェブサイト」はユニークなホスト名の数で、調査手法や休眠サイト数の影響で年によって増減があります。
| 年 | 世界のウェブサイト数 | 検索の必要性 |
|---|---|---|
| 1991年 | 1 | 場所を知っていればよい。検索は不要 |
| 1992年 | 10 | リンクを並べればよい |
| 1993年 | 130 | 言語や分野でカテゴリー分けすれば探せる |
| 1994年 | 2,738 | 分類の中をさらに分類すれば何とかなる |
| 1995年 | 23,500 | 階層が深くなり始める |
| 1996年 | 257,601 | 手作業の分類が苦しくなる |
| 1997年 | 1,117,255 | カテゴリー検索の限界に近づく |
| 1998年 | 2,410,067 | Googleが誕生 |
| 1999年 | 3,177,453 | ― |
| 2000年 | 17,087,182 | 一覧で探すのは不可能に |
| 2014年 | 968,882,453 | ― |
| 2017年 | 1,766,926,408 | ― |
| 2020年 | 1,224,770,416 | ― |
| 2026年 | 1,489,396,284 | ― |
情報の規模が変わると、便利な探し方も変わります。1サイトなら探し分ける必要がない段階、10サイトならリンク一覧が役立つ段階、130サイトならカテゴリーで絞る段階、そしてさらに増えると階層をたどる負担が増える段階へ。この流れが、今日の話の大きな軸になります。
ステップ5:RettyはAIに記事を書かせて、アクセスを285倍に(2020年)
次はこちらです。これは何年か前のテストに出した問題なのですが、2020年1月8日にこんな記事が出ました。「Retty(レッティ)」って皆さん知っていますか?
食べログやぐるなびのように、飲食店の口コミを投稿するサービスにRettyというものがあります。食べログやぐるなびは匿名で口コミを書いていたのですが、やらせの問題や、お金を出して何とかするという問題があったりしました。そこでRettyは実名で名前を出して口コミを書くというやり方で、「信用できるね」ということで人気が出たサービスです。今もまだあります。
このRettyが食べログやぐるなびに勝つために、AIに記事を書かせて、たくさん露出をしたんですね。スライドに書いていますが、1年間で2万ページぐらいをAIに作らせて、2年間でアクセスを285倍に増やすことに成功し、570万MAU(月間アクティブユーザー数)まで増えた、というのがニュース記事になりました。AIで作ったページがSNSで拡散され、Google検索にも乗る、という流れです。
この記事は1月8日で、2020年の1月の月末にテストがあったので、その年のテストに出した問題です。そのとき僕は「いいな」と思ったわけです。AIにこんな記事を書かせてもらっていいな、と。理屈的にはできることは分かっていたけれど、「AIに記事を書かせたらお高いんでしょ?」と思っていました。なぜかと言うと、2020年だからです。2020年にはChatGPTがありません。
つまり、私たちが簡単に文章を生成することはできなかったわけです。
| 項目 | Rettyの事例(2020年1月8日の記事) |
|---|---|
| サービス | 実名で口コミを投稿する飲食店情報サービス |
| 競合 | 食べログ、ぐるなび(匿名口コミ) |
| 施策 | AIに記事を書かせ、1年間で約2万ページを作成 |
| 成果 | 2年間でアクセス285倍、570万MAU |
| 当時の僕の感想 | 「いいな」。でも「AIに記事を書かせたらお高いんでしょ?」 |
ステップ6:ChatGPTが「誰でも文章を書ける」道具に変えた
皆さんにはもう当たり前になっていますが、前回お話ししたように、僕の息子は今年社会人になりました。息子が大学に入学したとき、4月から10月まではChatGPTがなかったんです。
ChatGPTが出たのは2022年11月30日です。ということは、最初の半年間はレポートを書くのも課題をするのも、全部手打ちしかなかったわけです。手打ちが嫌な場合は、誰かの論文か何かをコピーしてペーストするしかなかった。
皆さん、思い出してください。今は文章を書いてと頼めば、ダーンと出てくるのが当たり前になっていますが、ほんの3年、4年前にはそれができなかったんです。カチャカチャ打つしかなかったんですね。
そうなると、課題をするのも論文を書くのもめっちゃ楽になった。だからこそ、文章を書く力が落ちるという話も分かりますよね。でも、ChatGPTがない時代には、自分で書かないことには書けなかったわけです。
| 時期 | 文章作成の状況 |
|---|---|
| 2020年 | 企業がAIに記事を書かせるのは珍しく、「お高いんでしょ?」と感じる存在 |
| 2022年春 | 大学入学時はまだChatGPTがなく、レポートは手打ちかコピー&ペースト |
| 2022年11月30日 | ChatGPT登場 |
| ChatGPT登場後 | 一般の学生にも文章生成が身近に。作業は楽になる一方、書く力への問いも |
ステップ7:オンライン記事の48%がAI生成、それでも検索上位は人間が86%
ChatGPTが出てどうなったか。これは衝撃の事実です。オンラインで公開されている記事の48%が、現時点でAIの生成物になっています。 2026年までには9割になるという予測も出ていました。今年がその2026年なので本当かどうかは分かりませんが、それはちょっと置いておいて、これが出たのは2025年、去年の記事です。去年の時点で約5割がAIの記事になっていた、ということです。
グラフ(英語記事6万5,000本のサンプルを2020年1月〜2025年5月まで月ごとに調べたもの)を見ると、2022年11月のChatGPT公開を境に、AIが生成した記事の割合がぐんと伸び、2024年ごろには人間が書いた記事とほぼ並び、一時は逆転しています。最新の値では人間52%、AI48%です。
皆さんが普通にネットで検索して見ている記事の半分がAIなのかな、と思うかもしれませんが、大事なのはその下の赤で書いたところです。
Googleの検索結果では、人間が書いた記事が86%です。 つまり、AIが書いた記事は14%しかヒットしていない、上位に来ていない。だから「やっぱり人間の記事のほうが素晴らしいんだね、AIは大したことないんだね」とも言えます。
でも一方で、14%は評価されたとも言えます。2022年より前はゼロだったわけです。さっきのRettyのような、ちょっとお金持ちの会社がAIで書いた記事がヒットしているぐらいで、一般的ではなかったので、ほぼゼロでした。それが2022年からグイッと増えている。これを革命と言うわけです。誰でも簡単に文章を書ける仕組みができたから、革命と言うんですね。それは2022年11月30日にChatGPTが起こした革命です。
これによってAIの生成物が増えて14%まで来たことは確かです。このまま14%にとどまり続けるのであれば大したことはありません。でも普通、14%まで増えたら、このまま増えますよね。止まることはないし、ここからまた減るということも考えにくい。そうなると、どのぐらいのペースで増えるかが問題です。来年に5割になるのか、10年経っても2割しかいかないのかは分かりませんが、人間の記事は現時点で86%まで落ちてきています。
もう1つ、青字で書いたデータがあります。ChatGPTやPerplexityのようなAIに何か質問したとき、答えの引用元として人間の記事が引用されたのが82%、AIがAIの記事を引用しているのが18%です。これも18%にとどまるのか、減るのか。まあ、増えるよね、という話です。
当然AIも賢くなってくるので、もっといい記事を書けるようになれば、どんどんヒットする可能性もあります。どうなるの?という話ですよね。
| 指標(2025年の調査) | 人間 | AI | 読み取れること |
|---|---|---|---|
| オンラインで公開されている記事 | 52% | 48% | 公開記事のほぼ半分がAI生成に |
| Google検索上位の記事 | 86% | 14% | 「まだ14%」とも「すでに14%」とも言える |
| AIチャットボットの引用元 | 82% | 18% | AIがAIの記事を引用するケースも |
ただし注意点として、これらの数字はそれぞれ調査対象や分母が異なります。14%という数字は、すべてのウェブ記事の割合や検索の市場シェアを示しているわけではありません。構成比は現在の数字であり、将来の増加速度は別の問題で、増え続けるかどうかは僕の予測です。
ステップ8:検索エンジンのロボットはリンクをたどって世界を巡る
ここまで来た、という話はいいですか? ここからは、ウェブサイトがこれだけ大容量に増え続けている中で、どうやって探すのかという話をしていきたいと思います。
話を戻します。前回お話ししましたが、インターネットはWorld Wide Webと言って、世界中のホームページとホームページがリンクで張り巡らされているところから始まっています。ということは、YahooやGoogleといった検索エンジンのロボットさん、ボット(bot)と言いますが、これも同じようにホームページからホームページへとリンクをたどって、世界中のホームページを見に行くわけです。
見に行って、どんなページがあるかが分かったら、その情報を持って自分の会社に戻ります。戻って「こんな会社のページがありましたよ」「こんなページもありましたよ」と記録していく。それを一生懸命集めているわけです。
Googleはこれを機械、ロボット、今風に言えばAIがやったわけですが、Yahoo!という会社は、これを人力で登録していったんですね。
| 方式 | 情報の集め方 | 代表 |
|---|---|---|
| ロボット型(キーワード型) | クローラー(ボット)がリンクをたどって自動で巡回し、中央のサーバーに記録 | Google、AltaVista |
| ディレクトリ型(カテゴリー型) | 人がサイトを見て判断し、カテゴリーに手作業で登録 | Yahoo! |
ステップ9:2001年、Yahoo!は世界で最も人気のあるウェブサイトだった
人力で登録していったYahoo!は、2001年に世界で最も人気のあるウェブサイトになりました。講義では「Most Popular Websites 1996 – 2019」という、ウェブサイトのアクセス数の推移をバーチャートで見せる動画を見てもらいました。皆さんの知らないサイトもいっぱい出てくると思います。
最初はAOLというサイトがアクセス数でいちばん人気でした。2位がYahoo!、3位がMicrosoftのMSN。ほかにもExciteやGeoCities(ジオシティーズ)など、いろいろあります。その中でYahoo!がどんどん頑張っていきます。ここで言うYahoo!は日本のYahoo! JAPANではなく、アメリカのYahoo!という会社です。それがどんどん伸びて、2001年にトップに立ちます。
2001年4月時点のデータでは、Yahoo!が9億632万957、AOLが8億6,503万1,557、MSNが4億6,012万4,848、eBayが2億76万1,889、Lycosが1億3,703万8,117、Amazonが1億3,287万7,768、そしてGoogleは1億3,022万8,182でした。Googleはこの時点ではまだこんな位置だったんです。ここからGoogleのアクセス数、人気がどんどん出てくるのですが、まだまだでした。
| 順位(2001年4月) | サイト | 数値 |
|---|---|---|
| 1 | Yahoo! | 906,320,957 |
| 2 | AOL | 865,031,557 |
| 3 | MSN | 460,124,848 |
| 4 | eBay | 200,761,889 |
| 5 | Lycos | 137,038,117 |
| 6 | Amazon | 132,877,768 |
| 7 | 130,228,182 | |
| 8 | About.com | 122,575,194 |
| 9 | CNET | 81,182,830 |
| 10 | Ask.com | 73,233,277 |
つまり、ダントツでYahoo!の時代があったわけです。何度も言いますが、これは検索エンジンではなく、ウェブサイトのアクセス数なので、検索に限った話ではありません。Yahoo!というサイトそのものに人気があったのですが、2005年、2006年、2007年あたりで変化が起きます。2006年にGoogleが逆転して、そこからはGoogleの一強体制になります。皆さんのイメージ通り、YouTubeなども上がってきますし、その後はFacebookなども出てきますが、SNSについてはSNSの回にお話しします。
では、なぜYahoo!はあれほど人気があったのに、今では人気がなくなったのか。その話をしていきます。
ステップ10:なぜ検索エンジンは無料なのか ― ビジネスモデルの問い
日本では、Yahoo!、Google、そしてMicrosoftのBingという3つの大手の検索エンジンがあります。前回お話ししたように、「スマホ新法」ができて、スマホでどの検索エンジンを使うかを選ぶ画面が出るようになりました。DuckDuckGoなどいろいろありますが、大手ではGoogle、Yahoo!、Bingの3つです。
ここで考えてみてほしいのですが、そもそもなぜこれらの会社は、無料でこんなサービスを提供しているのでしょうか。皆さんは無料で使えて便利だと思っていますよね。たとえばChatGPTだって、無料で使えて便利だと思います。
でも、無料でやっているから、ChatGPTのOpenAIという会社は大赤字で大変なことになっています。だから広告を入れようとしていましたよね。今は実際に広告が入りました。
では、Yahoo!とGoogleとBingは、それぞれ何のために検索エンジンを無料で提供しているのか。実はその目的が違うんです。これをビジネスモデルと言います。何のために検索エンジンをやっているのかという理由が、実は会社によって違う。これをちょっと頭の片隅に置いて、「なんでなんだろう」と考えながら、話の続きを聞いてください。
| 検索エンジン | 運営会社 | 考えてほしい問い |
|---|---|---|
| Google(Alphabet) | 何で収益を上げているのか? | |
| Yahoo! | LINEヤフー(日本) | 検索エンジンは何のための「入口」なのか? |
| Bing | Microsoft | 自社の他の事業とどうつながっているのか? |
| ChatGPT | OpenAI | 無料提供の赤字をどう埋めるのか?(広告の導入) |
ステップ11:検索エンジンのシェア ― 世界のGoogle、かつての日本のYahoo!
検索エンジンのシェアは、世界ではGoogleが圧倒的に強いのですが、日本はちょっと前までYahoo!でした。いつ頃までYahoo!だったかというと、正確には覚えていないのですが、僕が会社を起業した2007年ぐらいは「Yahoo!が7でGoogleが3」などと言われていたぐらい、Yahoo!が前提でした。
今は完全に逆転していますが、そのぐらいYahoo!が強い時期があったんですね。世界地図でシェアを色分けしたスライドを見ると、ほとんどの国がGoogleなのに、ロシアはYandex(ヤンデックス)、中国はBaidu(バイドゥ、百度)、韓国はNaver(ネイバー)、そして日本はYahoo!と、それぞれの国で独自の検索エンジンが強かった時期がありました。
| 検索エンジン | 開発年・国 |
|---|---|
| 1998年 アメリカ | |
| Baidu | 2000年 中国 |
| Yahoo! | 1994年 アメリカ |
| Yandex | 1997年 ロシア |
| Microsoft(Bing) | 1998年 アメリカ |
| NAVER | 1999年 韓国(日本の検索事業は終了) |
ステップ12:1999年、Yahoo!は検索エンジンでも世界トップに
検索エンジンのシェアでYahoo!が世界のトップになったのは1999年です。さっき堀江さんの動画でもAltaVistaの話が出てきましたが、講義ではこれも「Most Popular Search Engines 1994 – 2019」という動画を早送りで見てもらいました。
1995年、皆さんはまだ生まれていませんね。ここでYahoo!という会社が出てきて、トップだったAltaVistaを抜きます。Googleも出てきますが、Googleの誕生は1998年、Yahoo!の誕生は1994年で、Yahoo!のほうが4年早い。1999年第3四半期の時点では、Yahoo!が18.32%、AltaVistaが17.69%、Lycosが15.93%、MSN Searchが10.12%、Googleが9.10%、AOL Searchが8.09%、Ask Jeevesが5.66%でした。
Googleがようやく抜いたのは2002年です。僕が結婚した年ですね。結婚した年にGoogleがようやくYahoo!を抜いて、そこからはずっとGoogleの一強です。ずっと一強で、Googleはただ伸びるだけです。
| 検索エンジン(1999年第3四半期) | シェア | 誕生年 |
|---|---|---|
| Yahoo! | 18.32% | 1994年 |
| AltaVista | 17.69% | ― |
| Lycos | 15.93% | ― |
| MSN Search | 10.12% | ― |
| 9.10% | 1998年 | |
| AOL Search | 8.09% | ― |
| Ask Jeeves | 5.66% | ― |
ところが、このまま上がり続けているように見えて、実はこれに異変が起きていたんです。これは講義の準備で僕も調べてみて分かったことなので、最後のほうでお話しします。
ちょうどこのタイミングで、コメント欄に「小学生の時、学校のPCの検索はYahoo!でした」という書き込みがありました。いいヒントです。その話もこのあと出てきます。
ステップ13:【考察】AIが書いた記事は「悪」なのか ― 両方の見方で考える
ここで少し立ち止まって、僕なりの考察を加えておきたいと思います。「オンライン記事の48%がAI生成」と聞くと、「ネットがAIのゴミ記事で埋め尽くされる」と心配になる人もいれば、「便利になってよかった」と感じる人もいると思います。どちらか一方だけが正しいわけではないので、両方の見方を並べてみます。
まず心配する側の見方です。AIは、すでにネット上にある情報を学習して文章を作ります。そのAIが書いた記事がネット上に増え、さらにそれを別のAIが学習したり引用したりするようになると、元の情報がどこから来たのか分からなくなっていきます。さっきの「AIがAIの記事を引用している18%」という数字は、まさにその入口だと言えます。間違った情報が、AIからAIへと伝言ゲームのように広がっていく可能性もあります。また、誰でも大量に記事を作れるようになったことで、検索結果を自分のサイトで埋め尽くそうとする人も出てきます。Rettyが2020年にお金をかけてやっていたことが、今は誰でも無料に近い形でできてしまうわけです。
一方で、前向きに捉える側の見方もあります。文章を書くのが苦手だった人、時間がなかった人、日本語以外の言語で発信したかった人が、AIの助けを借りて情報を発信できるようになりました。小さなお店や個人が、大企業と同じように情報を届けられるチャンスが生まれたとも言えます。そして、Googleの検索上位に入っているのは、AIが書いたかどうかではなく、読者の役に立つかどうかで評価された結果のはずです。「14%も評価された」ということは、AIを上手に使って、人の役に立つ記事を作っている人がいるということでもあります。
僕自身は、AIで音楽を作り、AIを使って講義のスライドやブログも作っています。だからこそ実感するのは、「AIが作ったかどうか」よりも「誰の着想から始まったか」「誰が責任を持って確認したか」が大事だということです。これは「起」でお話しした、鼻歌のワンフレーズから曲を作る話とまったく同じなんですね。AIに丸投げした記事は「ガチャ」と同じで、上位には行けない。自分の体験や視点を起点にして、AIに補完してもらった記事は、ちゃんと評価される。僕はそう考えています。
| 見方 | 主な主張 | 根拠になりそうな事実 |
|---|---|---|
| 心配する側 | AI記事が増えると、情報の出どころが分からなくなる | AIの引用元の18%がAI記事 |
| 心配する側 | 大量の記事で検索結果が埋め尽くされる | Rettyは1年で約2万ページを作成 |
| 前向きな側 | 誰でも発信できるようになった | ChatGPT以降、一般の学生も文章生成が可能に |
| 前向きな側 | 役に立つ記事は、AI製でも評価される | 検索上位の14%がAI記事 |
| 僕の考え | 大事なのは「誰の着想から始まり、誰が確認したか」 | 鼻歌のサビから作った曲は上位を狙える |
皆さんがレポートを書くときも同じです。AIに書かせること自体を禁止するのではなく、自分が何を考えたのか、どこを自分で確かめたのかを、自分の言葉で説明できるようにしておいてください。それが、AIの時代に「書く力」を失わないための一番の方法だと思います。
Yahoo!のカテゴリー検索はなぜ主役の座を降りたのか
ステップ1:Yahoo!は「ポータルサイト」だった ― ホームページに設定する文化
では、なぜ日本ではYahoo!の検索エンジンのシェアが高かったのか、という話をします。
Yahoo!は「ポータルサイト」という考え方を持っていました。そしてYahoo!のトップページを、ブラウザの「ホーム」に設定するのが流行ったんです。
前回お話ししたように、ブラウザのInternet Explorerを立ち上げたときに最初に表示されるページをYahoo!にしておくと、Yahoo!のトップページがボーンと出てくる。お父さんお母さんのパソコンがそうなっていませんでしたか? 当時のYahoo! JAPANには「ホームページに設定する」というボタンがトップページの目立つ位置にあって、「Yahoo! JAPANトップページをホームページに設定しよう」というキャンペーンページまで用意されていました。
なぜホームに設定していたのか。ポータルサイトの「ポータル」とは「玄関口」という意味です。インターネットというものが出てきたけれど、みんなインターネットで何ができるのかが分からなかったんですね。
インターネットがあることは知っている。でも、何ができるの?となる。そこでYahoo!のトップページを見ると、ここからショッピングができますよ、スポーツが見られますよ、天気が見られますよ、ニュースがありますよ、ゲームができますよ、占いができますよ、というメニューが並んでいる。とりあえずYahoo!のトップページをホームにしておけば、そこからゲームに行ったり、ニュースに行ったり、地図を見たり、いろんなことができる。そうすると「あ、インターネットって便利だね」となるわけです。
それに対してGoogleは、開いた瞬間に検索窓がボーンとあるだけです。だから、何ができるのか分からない。
日本人にとって、Yahoo!のような親切なサイトがあったことで人気が出ました。これは世界でも同じで、Yahoo!が人気だったのはこういう考え方をしたからです。インターネットをみんなが知らない初期にはこれでよかったのですが、みんなが知ってしまったら、それぞれ「ググればいいじゃん」という話になります。でも当時は、皆さんまだそれを知らなかったんですね。
だからYahoo!は、ポータルサイトとしての位置づけの1つとして、「検索もできたら便利だよね」ということで検索エンジンを提供していました。あくまでもインターネットのいろいろなサービスの1つとして、検索エンジンも置いていたわけです。それに対してGoogleは、検索エンジンに特化した会社を後から作りました。後発だったからです。
| 比較項目 | Yahoo!(ポータル型) | Google(検索特化型) |
|---|---|---|
| トップページ | ショッピング・ニュース・天気・ゲーム・占い・地図などのメニューが並ぶ | 検索窓がボーンとあるだけ |
| 初心者にとって | 何ができるかが一目で分かり安心 | 何ができるのか分からない |
| 検索の位置づけ | たくさんあるサービスの1つ | 会社の中心そのもの |
| 誕生 | 1994年(先発) | 1998年(後発) |
ステップ2:親切なメニューが「余計なお世話」になるとき
インターネットの初期には、これでよかったんです。でも考えてみてください。Yahoo!のトップページからショッピングに行くこともできますが、皆さんはそこからショッピングに行くのではなく、最初からAmazonを開けばいいじゃん、と思いますよね。
それは皆さんがAmazonを知っているからAmazonを開けるのであって、知らないときは、ショッピングができるということすら分からない。だから、とりあえずYahoo!に行ってから、そこを経由してショッピングに行くしかなかったんです。これがカテゴリー検索のスタートです。
つまり、世の中で何ができるのか分からないときに、それをまとめてあげるという親切な人がいたから、みんな便利に使えた。でも、だんだんみんなが賢くなってくると、こういうことが余計なお世話になってくるわけです。
「そんなの言われなくても知ってるよ」「こんなガチャガチャしていて見にくいよ」という話になって、みんな使わなくなるんですね。このやり方で成功したのがYahoo!という会社で、世界でもうまくいきましたが、日本では特にうまくいきました。
| 利用者の状態 | Yahoo!のメニューの評価 |
|---|---|
| ネットで何ができるか知らない初心者 | 入口に選択肢があるから、できることに気づける。案内があって安心 |
| 目的のサービスを知っている人 | 行き先を知っているので、途中の案内が回り道に感じる。情報が多くて見にくい |
| 結論 | 使いやすさは、情報量だけでなく利用者の経験によって変わる |
ステップ3:日本人は「幕の内弁当」が好き?
日本でYahoo!が特にうまくいった背景には、日本独特の考え方があるらしいんです。たとえば幕の内弁当のように、1つのお弁当に何でもぎゅっと入っているものが日本人は好きらしい。
それと同じように、1つ見れば何でも分かる、というものが日本人は好きらしいんですね。だからYahoo!のポータル型のデザインと相性がよかったと言われています。なぜYahoo!が日本で人気だったのか、皆さんもぜひこのあたりを調べてみるといいと思います。
ステップ4:Internet Archiveで昔のウェブサイトをのぞいてみる
Yahoo!とGoogleでは、トップページのデザインが全然違いますよね。実は、そのデザインを過去にさかのぼって見ることができるサイトがあります。リンクを貼っておくので、皆さんもぜひ調べてみてください。
それが「Internet Archive(インターネット・アーカイブ)」というサイトの「Wayback Machine(ウェイバックマシン)」です。講義ではこのサイトに実際にアクセスしてみました。皆さんの好きな芸能人でも、好きなアーティストでも誰でもいいのですが、誰かのページをここで開きます。
今はYahoo!の話をしているので、Yahoo!にします。URLを入力する欄にYahoo!のURLを入れて、エンターを押すだけです。そうすると、このサイトは過去のウェブサイトのアーカイブを全部取っているので、その年のウェブサイトを見に行くことができます。ウェブサイトをリニューアルしても、前のデザインをさかのぼって見られるんですね。デザインをやっている方は、ホームページのデザインがどのように進化してきたかという過程が分かるので、とても勉強になります。
ちなみにInternet Archiveに保存されているウェブページの数は、スライドに載せたように2020年10月12日時点で「4,770億ページ以上」、2021年10月10日時点で「6,160億ページ以上」と表示されていました。1年で1,000億ページ以上も増えているわけです。
| 手順 | やること |
|---|---|
| ① URLを入力する | Internet ArchiveのWayback Machineにアクセスし、見たいサイトのURLを入れる |
| ② 見たい年を選ぶ | 上の年表から年を選ぶ(Yahoo!なら1997年あたりから記録がある) |
| ③ 保存された日時を開く | カレンダーで、丸印がついている保存日をクリック |
| ④ 過去と今の画面を見比べる | デザインや情報の見せ方の変化を観察する |
ステップ5:1997年4月14日、僕の誕生日のYahoo!
今は2026年です。年表をずっと見ていくと、Yahoo!は1997年から記録がありますよね。1997年を選んでみます。この頃は全部が取られているわけではないのですが、この日はスクリーンショットが残っているので、どれか1つを押してみます。
そうすると、1997年4月14日。あ、僕の誕生日ですね。僕の誕生日のYahoo!は、こんなページだったんです。さっきの動画の中にもあったと思いますが、こんな感じでした。Yahoo!のトップページです。
「ビジネスと経済」ですか、「コンピューター」ですか、というようにカテゴリーが並んでいるだけ。これで終わりです。これがトップページでした。これだけで済んでいたのに、今のデザインを見たら、めっちゃガチャガチャになっているじゃないですか。
結局、インターネットでできることがどんどん増えたので、じゃあこれも増やそう、これも増やそう、1列では収まらないから2列にしよう、3列にしよう、とやっていった結果、今のデザインになったわけです。
今のYahoo!のトップページを見ると、ここにいくつあるの?という話ですし、ニュースはいくつ並んでいるの?という話ですよね。あちこちにいろいろなものがあるという状態になっています。
ステップ6:Yahoo! JAPANトップページの変遷(1996〜2008年)
もちろん、その年その年でみんながいちばん使いやすいデザインに変えていっているので、少しずつリニューアルしています。それを少しだけお見せしました。
1996年はこんな感じでした。それが1998年、2001年、2003年、2007年、2008年と、どんどん詰まってきています。2008年あたりからは、ほぼ今と同じような形になっていると思います。
さっきの動画にもあったように、もともとYahoo!という会社はカテゴリー検索の会社なので、カテゴリーが並んでいるサービスでした。もちろんキーワード検索の窓もついていましたが、メインはカテゴリーで探すことで、そのカテゴリーを分けていたのは人間でした。当時はAIによる検索より人間のほうが精度が高かったので、みんなYahoo!を使っていたんです。
ところが、だんだんこのカテゴリーの枠が変わっていきます。最初はページの真ん中、上のほうにあったカテゴリーが、だんだん下に移り、さらに下に移り、2008年からはトップページの真ん中に出すのをやめて、右上の端の「カテゴリ一覧」というリンクに収まってしまいます。
そして今は、なくなりました。
| 年 | Yahoo! JAPANトップページでのカテゴリーの位置 |
|---|---|
| 1996年 | カテゴリーがページの中心。シンプルな一覧 |
| 1998年 | まだカテゴリーが中心。情報が少しずつ増える |
| 2001年 | ニュースやサービスが増え、カテゴリーが下へ |
| 2003年 | さらに情報が詰まり、カテゴリーは下へ |
| 2007年 | カテゴリーは画面下部の一角に |
| 2008年 | トップページ中央から消え、右上の「カテゴリ一覧」へ |
| 現在 | カテゴリーはなくなった |
つまり、もともとは動画にあったように、検索エンジンにはキーワード検索とカテゴリー検索の2つがあって、初期はカテゴリー検索のほうが人気でした。キーワードで探すのは難しく、精度も低かったからです。でも、だんだんこれが入れ替わって、今はみんな検索窓でキーワード検索をするのが当たり前になっています。みんなが、そして検索エンジンがどんどん賢くなって、逆転したわけですね。これによって、Yahoo!の時代からGoogleの時代へと入れ替わっていったことが分かります。
ステップ7:選択肢は「5個が理想、7個が限界」
では、そのあたりを少し考えていきたいと思います。デザインをやっている方は授業で習うかもしれませんが、ぜひ考えてみてください。そもそも選択肢というものは、5個が理想で、多くても7個が限界だと言われています。
たとえば皆さんが服を買いに行ったとします。店員さんが「今日はどんな服が欲しいんですか?」と聞いてきて、皆さんが「こんなのが欲しいです」と答えたとします。そのときに店員さんが「じゃあこれがありますよ。これもいいですよ。これも素敵ですよ。これも可愛いですよ。どれがいいですか?」と、次から次へと出してきたらどうでしょう。そんなことをされたら、結局いっぱいありすぎて分からないので「もういいです」という話になりますよね。
だから店員さんはどうするかと言うと、5個ぐらいしか出さないんです。5個ぐらい並べて、もう1個出そうとするときは「この中でいらないものはどれですか?」と聞いて1個削る。結局、5個ぐらいの中から選ばせるようにすると思うんですね。これが、人間が選択するときの限界の数で、それが5個なんです。
日本人の場合は7個ぐらいが限界と言われています。ところが、海外の人は11個ぐらいいけるらしいんですね。日本人は実は、たくさんの中から選ぶのが苦手らしいんです。
| 選びやすくする3つのステップ(服屋の接客の例) | 内容 |
|---|---|
| ① 候補を提示 | 違いを比較できる数(5着程度)で候補を見せる |
| ② 不要な候補を外す | 「この中でいらないものはどれですか?」と聞いて絞る |
| ③ 新しい候補と入れ替える | 1着足すなら1着減らし、比較する数を保つ |
そうすると、Yahoo!のメニューがあんなふうにずらっと並んでいたら、そもそも見る気がしないじゃないですか。自分が見たいものがどこにあるのかを探すのに、目がうろちょろしてしまう。だから、メニューの数や、各エリアの項目の数は、なるべく7個ぐらいに収まるようにしないといけない。今のデザインはそうなっているはずです。
ステップ8:iPhone・Instagram・X・TikTokに見る「5の法則」
たとえばスマホです。講義では僕のiPhoneの画面をお見せしましたが、縦に2、4、6と、アイコンが6段並んでいて、いちばん下の7段目にドックのアイコンがありますよね。
これは6段が限界で、もしアイコンが縦に12段ぐらい並んでいて、横に6個ぐらい並んでいたら72個です。仮に見えたとしても、「どこだっけ?」と探すのが大変ですよね。横は今4個ですが、5個が限界です。横を5個にして縦を6段も7段も並べると、画面がぎっしりいっぱいになって探すのが大変になるので、これが限界なんですね。
次回か、その先の回でお見せすると思いますが、iPhoneはどんどん大きくなっています。昔はこんなにアイコンが並んでいませんでした。でも、これからスマホがどんどん大きくなっても、縦に並ぶ数が今の7段から8段になるかと言うと、ならないと思います。結局アイコンが大きくなるか、アイコンの隙間が開くか、のどちらかです。それがデザインとしての限界だからです。5個から7個ぐらいが、人間が選ぶときの限界なんだと考えてください。
皆さんがよく使っているInstagramでもいいですよ。Instagramを開いても、下のメニューの数は5個しかないでしょう。ここに12個並んでいたら嫌でしょう? ストーリーズとか何とかが並んでいてもいいけれど、どれを押せばいいの?という話になりますし、アイコンも小さくなります。これも限界なんですね。
X(旧Twitter)でも同じで、下のメニューの数は5個です。もうこういうふうに決まっているんです。TikTokでもそうですよ。下に出ているメニューは5個です。だから5個が理想なんですね。7個は多すぎです。パソコンなら画面が大きいので7個でもいいのですが、スマホだと5個が限界です。
| サービス・画面 | 並んでいる数 | 読み取れること |
|---|---|---|
| iPhoneのホーム画面 | 横4個 × 縦6段 + ドック | 画面が大きくなっても段数は増えず、アイコンか隙間が大きくなる |
| Instagramの下部メニュー | 5個 | 12個並んだら選べない |
| X(旧Twitter)の下部メニュー | 5個 | 主要な操作を少数の入口にまとめる |
| TikTokの下部メニュー | 5個 | スマホでは5が理想 |
| パソコンのメニュー | 7個程度まで | 画面が大きければ7でもよい |
使いやすさに関わる観点としては、①探す負担(項目が多いと探す時間と注意力が必要)、②文字とアイコンの見分けやすさ、③押しやすさ(アイコンが大きく間隔が広いと正確に押しやすい)、④余白(余白があると画面が見やすく項目の区切りが分かりやすい)の4つがあります。画面が大きくても、項目を増やせばよいわけではないんですね。
ステップ9:楽天市場に今も残るカテゴリーの考え方
これを意識したうえで、次の話です。Yahoo!という会社は、さっき紹介したように、世の中にウェブサイトが10個しかないときはカテゴリーで分けなくてもよかった。でも100個になったら分けなければいけないので、まず大きく7つに分けましょう、あるいは5つに分けましょう、となります。7つに分けた1個目の下をさらに7つに分けて、その下をさらに7つに分けて……という感じで分類していかなければいけなくなりますよね。
分かりますか? これは今でも残っているんです。皆さん、楽天市場がありますよね。楽天市場も左側にカテゴリーが並んでいます。たとえばここで「ファッション」に行ったとします。ファッション・インナーに行くと、その中がレディース、メンズなどに分かれていて、やっぱり4つぐらいが並んでいます。
ここでレディースに行くと、トップス、パンツなどとなっていて、これも6つしか並んでいません。ここに12個も並んでいたら嫌でしょう?
ところが、さらにトップスに行くと、トップスの中で今度は「ジャンル」というものがあって、カットソーなどが並んでいるのですが、ここは並ぶ数が多いんですよね。2、4、6、8と数えると12個並んでいます。これはちょっとデザインがひどいですね。
12個並べるのであれば、たとえばどこかで区切りを入れるとか、もう少し大きくするとか、途中で色を変えるとかしないと、ここから探すのは面倒になります。これはUIの話ですが、皆さんがデザインをするときに意識するといいと思います。
| 見やすさの工夫(楽天市場を例に) | 内容 |
|---|---|
| ① 文字を大きくして区別する | 重要な項目を大きく、目立たせて、目的の入口を見つけやすくする |
| ② 途中で色を変えてまとまりを示す | 階層の区切りで色を変え、どのまとまりの中にいるかを分かりやすくする |
| ③ 一度に並べる数と、たどる段数を一緒に考える | 同じ階層に並べる項目数(横)と、階層の深さ(縦)をバランスよく設計する |
カテゴリー検索には、「横に多すぎる」と目が迷って選びにくくなり、「深すぎる」と今どこにいるのか、どこへ戻ればいいのかが分かりにくくなる、という2つの負担があるわけです。
ステップ10:アロエヨーグルトにたどり着くまで ― カテゴリーの深さの限界
サイトがどんどん増えていくと、大分類、小分類という形で「じゃあこれに分けよう」とやっていくわけです。たとえばアロエヨーグルトを売っているサイトがあるとします。Yahoo!カテゴリーで探すと、「ショッピング」のページの中の「BtoC」(企業から個人への販売)の中の「グルメ」の中の「乳製品」の中の「ヨーグルト」の中の「アロエヨーグルト」というように、どんどんカテゴリーをたどっていって、やっとアロエヨーグルトのサイトにたどり着くわけです。
当然、アロエヨーグルトのカテゴリーのページに行ったら、ヨーグルトを売っているページが10個とかあったりするわけです。最後のアロエヨーグルトのカテゴリーにたどり着いたときに、「100個サイトがあります」と言われたら、100個の中から探すのは大変ですよね。だから100個をさらにカテゴリー分けして、ここでも5個から7個の中から選べるようにしておかないといけない。
そうすると、いつまで深く掘り下げるんだという話になります。奥行き、つまり階層の深さも5段から7段ぐらいに収めておかないと、迷子になってしまうんですね。自分がどこまで深く入ったのか分からなくなる。1個前に戻ろうと思っても、どこまで入ったの?という話になるからです。
ステップ11:7の7乗=82万3,543サイトという「人力分類の限界」
ということは、数学上、横に7個、深さ7段まで、つまり7の7乗=82万3,543サイトが、Yahoo!カテゴリーで分類できるサイト数の限界なんですよ。これ以上のウェブサイトを人間が手で分類しようとしても、もう分けきれない。Yahoo!がそれに気づいたかどうかは分かりませんが、ここが面白いところなんです。
| 年 | 世界のウェブサイト数 | 7のべき乗(分類できる上限) | 出来事 |
|---|---|---|---|
| 1991年 | 1 | 7 = 7 | ― |
| 1992年 | 10 | 7×7 = 49 | ― |
| 1993年 | 130 | 7の3乗 = 343 | ― |
| 1994年 | 2,738 | 7の4乗 = 2,401 | Yahoo!誕生 |
| 1995年 | 23,500 | 7の5乗 = 16,807 | ― |
| 1996年 | 257,601 | 7の6乗 = 117,649 | ― |
| 1997年 | 1,117,255 | 7の7乗 = 823,543 | 7段×7個の限界を超える |
| 1998年 | 2,410,067 | 7の8乗 = 5,764,801 | Google誕生 |
| 1999年 | 3,177,453 | 7の8乗 = 5,764,801 | ― |
| 2000年 | 17,087,182 | 7の9乗 = 40,353,607 | ― |
世の中のウェブサイトはどんどん増えていきます。1997年に世の中のウェブサイトの数が82万サイトを超えたとき、その翌年の1998年にGoogleのキーワード検索が誕生しているんです。
つまり、世の中のみんなが「カテゴリー検索ではもう無理です」「全部は探しきれません」「使いにくいです」と言い始めたときに、Googleが「キーワード検索なら、一発でバーンとあなたの好きなページを探せますよ」というサービスを出した。そうしたら「すげえ便利じゃん」となるので、Googleは人気が出ますよね。ここにGoogleは活路を見いだしたわけです。
Googleは後発ですが、先発の人たちがやっていなかったカテゴリー以外のところに、いいタイミングで気づいたのか、たまたまなのかは分かりません。でも、1998年はちょうどみんなの限界、Yahoo!のカテゴリー検索の限界のときで、そこにうまく出てきたので、一気にGoogleがやってきたんですね。
ところが今度は、そのGoogleの時代でも立ち行かなくなってきたのが、ChatGPTの登場です。それは後でお話しします。こうして、今のGoogleの時代になったわけです。
ステップ12:2005年まで、Yahoo!では「人間が選んだサイト」が上位に出た
おそらく皆さんの中には、Yahoo!というものをよく知らない方が多いと思います。Googleはよく知っているけれど、Yahoo!はよく知らない。そこで少しだけ、「Yahoo!ってすごかったんだよ」という話をしたいと思います。もう昔の話で、皆さんはまだ生まれていない2005年のことです。
2005年10月、こんな変化がありました。Yahoo!で検索すると、カテゴリーに登録されている、人間が選んだサイトが優先的に上位に表示される、という仕組みがなくなったんです。
逆に言えば、2005年まではこの仕組みがあった。Yahoo!さんが「このサイトはおすすめですよ」「よくできているサイトですよ」と、人がちゃんと認めたサイトとして登録されれば、検索でたくさんの人に見つけてもらえて、うまくいく。それが2005年まではできたんです。スライドでは、2005年10月の前と後の「Yahoo!」の検索結果画面を並べてお見せしました。前は登録サイトが目立つ位置にまとまって出ていたのが、後ではそれがなくなっています。
| 時期 | Yahoo!の検索結果の特徴 |
|---|---|
| 2005年10月まで | カテゴリーに登録された「人間が選んだサイト」が優先的に上位表示 |
| 2005年10月以降 | 登録サイト優先の表示がなくなり、ロボット型の検索結果が中心に |
ステップ13:登録料ではなく「審査料」― 5万円から15万円
そうなると、Yahoo!に「登録してください」「私のサイトを見てください」と申請を出す必要がありますよね。Yahoo!はその申請を受け付けるサービスをやっていました。そしてなんと、その審査料として5万円から15万円のお金を取っていたんです。
やばくないですか? 登録料じゃないんですよ。審査をするために5万円を払っていたんです。つまり、審査に落ちても5万円は返ってこない。登録料ではないので。
スライドには当時のYahoo!カテゴリの「登録申し込み方法」のページを載せています。「サイトの登録(有料)」は「Yahoo!ビジネスエクスプレス」からの申し込みとなり、審査料金の入金確認後、7営業日以内に登録の可否が審査され、登録の可否にかかわらずメールで結果が知らされる、と書いてあります。一方で「サイトの推薦(無料)」という窓口もありましたが、推薦されたすべてのサイトを審査するわけではなく、話題になっているサイトを中心に一部をピックアップして登録する、という扱いでした。
これをやったことで、ウェブサイトが増えれば増えるほど登録したい人が増えるので、どんどん5万円、5万円と入ってくるじゃないですか。それで儲けていたんです。
検索エンジンは皆さんには無料で提供するけれど、その代わりに企業や登録したい人からお金を取って、それで事業を回していたわけです。だから当時のYahoo!は広告ビジネスではなく、このカテゴリー登録の収入でやっていた。カテゴリーの会社で、キーワード検索が主役ではなかったからですね。
| 申し込み方法 | 料金 | 内容 |
|---|---|---|
| サイトの登録(Yahoo!ビジネスエクスプレス) | 有料(審査料5万〜15万円程度) | 入金確認後、7営業日以内に審査。可否にかかわらず結果をメールで通知。落ちても返金なし |
| サイトの推薦 | 無料 | すべてを審査するわけではなく、話題のサイトを中心に一部をピックアップ |
ここで、さっきの「なぜ検索エンジンは無料なのか」という問いを思い出してください。Googleは検索した人に広告を見せて広告主からお金をもらう。一方、かつてのYahoo!は「載せてほしい」というサイト運営者から審査料をもらっていた。同じ「無料の検索エンジン」でも、お金の出どころがまったく違ったわけです。
ステップ14:アメリカは2014年、日本は2018年にカテゴリーを終了
ところが、アメリカでは2014年12月31日に、この「Yahoo! Directory(ヤフー・ディレクトリ)」を終了しました。今から12年前です。Yahoo!のディレクトリは1994年から続いてきたサービスで、2009年あたりから縮小の動きがありました。
ところが、Yahoo! JAPANはアメリカとは別の組織だということで、2014年9月29日にアメリカの終了の発表があったときには、「Yahoo! JAPANでは今後も継続します」と言っていました。今後も審査料を取り続けますよ、ということです。
そして次です。そんなYahoo! JAPANも、2018年3月29日にカテゴリー検索を終了します。4年間は日本で頑張って5万円を取り続けたのですが、さすがに日本でも無理になったので、「Yahoo!カテゴリ」と「Yahoo!ビジネスエクスプレス」のサービスが終了になりました。1996年のYahoo! JAPAN創業以来のサービスでしたが、SNSやGoogleなどの普及で役割を終えた、というわけです。なお、それに先立って2017年7月31日には新規の申し込みの受け付けも終わっています。
| 年月日 | 出来事 |
|---|---|
| 1994年 | Yahoo!(アメリカ)誕生。ディレクトリ(カテゴリー)サービス開始 |
| 1996年 | Yahoo! JAPAN誕生。Yahoo!カテゴリ開始 |
| 2005年10月 | Yahoo!検索で、カテゴリー登録サイトの優先表示がなくなる |
| 2009年 | アメリカで縮小の動き |
| 2014年9月29日 | アメリカのYahoo! Directory終了を発表。日本は継続を表明 |
| 2014年12月31日 | アメリカのYahoo! Directory終了 |
| 2017年7月31日 | 日本のYahoo!ビジネスエクスプレス新規受付終了 |
| 2018年3月29日 | 日本のYahoo!カテゴリ、Yahoo!ビジネスエクスプレス終了 |
こうして今があるわけです。皆さんはご存じないかもしれませんが、こんな歴史があったんです。
ステップ15:Yahoo!きっずも2026年12月4日に終了へ
そこで、さっき誰かがコメントに書いてくれた話につながります。皆さんはおそらく、小学校のときに「Yahoo!きっず」というサービスを使っていましたよね?
Yahoo!きっずは今でも実は人気で、「寿司打(すしだ)」というタイピングゲームなどが中に入っていて、それで遊んだりしていたと思います。ところが、残念なお知らせがあります。Yahoo!きっずは2026年12月4日でサービスが終了します。
皆さん、久しぶりにYahoo!きっずのサイトを見てほしいのですが、今はこんな感じのサイトになっていて、大きくドーンと検索窓がついていると思います。これは最近のデザインです。今のYahoo!きっずには「検索ランキング」や「話題のキーワード」、「きっず検索ランキング ベスト20」などが並んでいて、寿司打、タイピング、NHK for School、Scratch、ゲーム、マインクラフトといった言葉が上位に入っています。
皆さんのときはどうだったか覚えていますか? これも、さっきの「Internet Archive」でさかのぼれば見られます。皆さんが小学生だったのは何年前ですか? 今は2026年なので、皆さんが仮に20歳だとすると、10年前は2016年ぐらいですね。2016年ぐらいのサイトを見てみます。
こんな感じだったんです。覚えていますか? 上には検索窓がボンと出ています。でも、ここにほら、「カテゴリ」があるでしょう? 「コンピューター」とか「勉強」とか、こうやって選びますよ、というのがありますよね。
今のYahoo!きっずのトップページを見ると、カテゴリーはないじゃないですか。もうないんです。カテゴリーではなく「タグ」になっていますね。タグはキーワード検索に少し近いものです。一応、カテゴリーではないけれど、3年生、4年生のような学年別に算数などを選ぶものはあります。でも、そこから先が細かく分かれているわけではないので、カテゴリーとは言えないと思います。
僕が生まれたときは、そもそも小学校のときにネットがありません。Yahoo!すらないので、2004年ぐらいにしてみます。2004年ぐらいのデザインを見てみると、今から22年前ですね。ほら、こんなのですよ。Yahoo!きっずは、ドーンドーンとカテゴリーが並んでいます。一応検索窓もありますが、カテゴリーが主役です。つまり、最初はみんな、こういうほうが分かりやすかったんです。
| 時期 | Yahoo!きっずのトップページ | 主な入口 |
|---|---|---|
| 2004年ごろ | カテゴリーがドーンと並ぶ。検索窓は小さめ | カテゴリー(ゲーム、学習、生活・社会など) |
| 2016年ごろ | 上に検索窓。その下に「コンピューター」「勉強」などのカテゴリー | 検索窓とカテゴリーの併用 |
| 現在(2026年) | 大きな検索窓が中心。カテゴリーはなく「タグ」と学年別メニュー | 検索窓 |
| 2026年12月4日 | サービス終了 | ― |
ステップ16:検索には「疑問を単語に変える技術」が必要
だんだんみんなが、キーワードで検索することに慣れたんですね。でも、キーワードで検索するのは実は難しいですよね。自分が思ったことを単語に直して検索しなければいけないので、実は検索するには技術が必要なんです。
こういうことは学校で習いますか? たぶん習わないですよね。自分が調べたいことを、どういう単語に直して、どう検索したらいいのか。たぶん習っていないと思います。だからこそ、カテゴリーで探すという方法があったのですが、それも終わるということです。
たとえば「昔のホームページの見た目を知りたい」と思ったとします。キーワード検索では、①まず調べたい対象を決める(昔のウェブサイト)、②知りたいことを絞る(デザインの変化)、③検索語にする(「Webサイト デザイン 歴史」)というように、ぼんやりした疑問を単語に変換する必要があります。カテゴリーは用意された入口から順に進んで探せばいいので、選択肢が探す方向を教えてくれます。一方、空白の検索窓は自由度が高い反面、入力する言葉を自分で考える必要があるわけです。
| 探し方 | 特徴 | 利用者に求められること |
|---|---|---|
| カテゴリーから選ぶ | 用意された入口から、順に進んで探す。選択肢が探す方向を教えてくれる | 選ぶだけ |
| キーワードで探す | 空白の検索窓に、自分で単語を入れて探す。自由度が高い | 調べたい内容を自分で言葉にする技術 |
ステップ17:実はYahoo!とGoogleの検索結果は同じ
皆さん、これはご存じですか? Yahoo!とGoogleの検索結果は同じだということを。
よく「私はYahoo!派です」とか、さっきもコメントで「Google派」と書いてくれていましたが、「Yahoo!派です」「Google派です」と言う人がいます。でも、どっちでも一緒です。どちらでも検索結果は同じになっています。ただ、みんなYahoo!の検索結果とGoogleの検索結果を並べて比較しないので、分かっていないだけなんですね。
講義では、「長岡造形大学」で検索したときのYahoo!とGoogleの検索結果を並べて、同じ順位のものを線で結んだスライドをお見せしました。公式サイト、オープンキャンパスのページ、Wikipedia、大学受験の情報サイト、X(旧Twitter)のアカウントと、順位がぴったり同じなんです。
これがいつから一緒になったかと言うと、2010年からです。2010年から、Yahoo! JAPANはGoogleの検索エンジンを使っています。皆さん、さかのぼってみてください。2010年は今から16年前なので、皆さんが小学生になったぐらいからは、Yahoo!とGoogleの検索結果は同じなんですね。
なのに「私はYahoo!派」とか「Google派」と言っている人がいるけれど、一緒だという話です。
ところが、2010年より前は違いました。なぜかと言うと、Yahoo!さんも検索エンジンとして、キーワード検索のエンジンの開発をしていたからです。お金をかけて、Googleにも負けない素晴らしい検索エンジンを作るんだと頑張っていたんですね。
ところが、Googleに勝てない。無理だということに気づいたので、それにお金をかけるのはもったいない。だから「Googleさん、あなたと同じ結果でいいから貸して」と言って、借りている状態がもう16年間続いています。本来は2年契約で、それがずっと延長、延長、延長で、今年まで延長されています。一応12月にまた更新の時期が来るのですが、たぶん更新すると思います。これがどうなるか、というお話です。
ちなみに、日本の主要な検索エンジンの歴史を振り返ると、1994年12月の「千里眼」(早稲田大学)に始まり、1995年にはNETPLAZA(日本電気)、Info Navigator(富士通)、Hole-In ONE(日立国際ビジネス)、TITAN(NTT)、ODiN(東京大学)、1996年にはRCAAU Mo-re-do-u(京都大学)、Yahoo!カテゴリ(ヤフー)、Infoseek(インフォシーク)、1997年にはgoo(NTTグループ)、Excite(エキサイト)、そして2000年8月にGoogleが日本でサービスを始めています。
しかも、日本の検索エンジンの多くは、途中で自社のプログラムからGoogleなどの技術に切り替えています。たとえばYahoo! JAPANは、1996年4月はオリジナル、1998年5月にgoo、2001年4月にGoogle、2004年5月にYahoo! Search Technology(オリジナル)、そして2010年7月にGoogleと変遷してきました。gooも1997年3月はオリジナル、2003年12月にGoogle。Infoseek Japanは1996年10月オリジナルから2003年9月にGoogle、Excite Japanは1997年7月オリジナルから2002年1月にGoogle、といった具合です。今も独自のエンジンを持っているのは、ごく一部です。
| 検索エンジン | プログラムの変遷 |
|---|---|
| Yahoo! JAPAN | 1996年4月 オリジナル → 1998年5月 goo → 2001年4月 Google → 2004年5月 Yahoo! Search Technology(オリジナル) → 2010年7月 Google |
| NETPLAZA / BIGLOBE | 1995年9月 オリジナル → 2000年11月 Google |
| InfoNavi / @nifty | 1995年10月 オリジナル → 2001年4月 Google |
| goo | 1997年3月 オリジナル → 2003年12月 Google |
| bing | 2009年5月 オリジナル |
| Infoseek Japan | 1996年10月 オリジナル → 2003年9月 Google |
| Excite Japan | 1997年7月 オリジナル → 2002年1月 Google |
| Baidu | 2008年1月 オリジナル |
| NAVER | 2009年6月 オリジナル |
(出典:山名早人「検索エンジンの歴史とGOOGLE誕生」より一部抜粋・編集。Yahoo! JAPANの2010年の切り替えについては、講義では「2010年から同じ」と説明しています)
| 検索エンジンを自社で作るか、他社から借りるか | 自社開発を続ける | 他社の技術を利用する |
|---|---|---|
| やること | 自社で検索エンジンを開発・運用し、独自の技術を育てる | 他社の検索技術を借りて、自社のサービスとして提供する |
| 必要なもの | 大量のデータを扱うためのサーバーや設備への投資、Googleなどとの性能競争 | 利用者が使うサービスの名前と、裏側の検索技術を別に考える |
| 例 | Google、Bing | Yahoo! JAPAN(表側:Yahoo! JAPANの画面・サービス、裏側:Googleの検索技術) |
自社で検索エンジンを開発し続けるには、大きな投資と継続的な競争が必要です。だからYahoo! JAPANは、Googleとの競争を続けるための費用を考えて、技術を借りるという選択をしたわけです。表側の画面やサービスはYahoo! JAPANのものですが、裏側の検索技術はGoogleのもの、という構造です。
ステップ18:GoogleはAppleに毎年お金を払っている
次はこちらです。これもびっくりなのですが、GoogleはAppleのデフォルト検索にしてもらうために、毎年お金を払っているという話です。
皆さんがiPhoneでSafariを使っているとき、検索窓が出てきますよね。Safariを開いたときに上に出てくるアドレス欄や、普通に検索したときに出てくるキーワード検索の場所。ここは自動的にGoogle検索になっていると思います。
これにしてもらうために、GoogleがAppleにお金を払って、その契約を勝ち取っているんですね。つまり、「あなたのところの検索エンジンにGoogleを載せてくれ」と。載せてもらいさえすれば、検索するたびに全部Googleを使ってくれるので、広告収入が自分のところに入ってくる。そのほうが払っているお金よりも多いので、そのぐらいは払いますよ、ということで、めちゃくちゃ払っているんです。
| 流れ | 内容 |
|---|---|
| ① 利用者は、普段の入力欄から検索する | iPhoneのSafariなど、普段使う検索欄に気になることを入力 |
| ② 標準の検索先へつながる | 調べたい言葉が、初期設定の検索エンジン(Google)に送られる |
| ③ Googleの検索結果が表示される | 広告と通常の検索結果が並ぶ |
| ④ 検索が集まると、広告を表示する機会が生まれる | 広告主はGoogleに広告費を支払う |
| ⑤ Googleは、そこから得られる収入を見込んでAppleに契約費用を払う | 初期設定の契約に伴う支払い |
利用者は無料で検索できますが、検索の入口には事業上の大きな価値があるということですね。
ステップ19:揺らぎ始めた「Google一強」― Samsung、そしてYahoo! JAPAN
最近では、Samsung(サムスン)がスマホの検索をGoogleからBingに変えようとしていました。結局は見送ったのですが、こういう動きが今、世界的に起きているんですね。
Google一強の時代が変わろうとしているのが、まさに今なんです。なぜかと言うと、AIのせいです。AIが入っている検索のほうがいいんじゃないの? ということで、そちらにするかどうかで、いろいろと揺れているわけです。
日本でもこんなニュースがありました。日本経済新聞の2023年7月の記事で、「ヤフーの検索エンジン技術契約、Googleから変更検討」というものです。Yahoo!が検索エンジンの技術を、2025年3月末の契約満了でGoogleから他社に切り替えることを検討している、というニュースでしたが、結局これは見送られました。
でも、こういうニュースは今までは出てこなかったんですね。ここ数年で見直しの動きが出ていて、どうなるかは分かりません、というお話です。
| 時期 | 動き | 結果 |
|---|---|---|
| 2010年〜 | Yahoo! JAPANがGoogleの検索技術を利用 | 2年契約を延長し続けて現在に至る |
| 2023年7月 | Yahoo!がGoogleからの切り替えを検討(2025年3月末の満了時) | 見送り |
| 近年 | SamsungがスマホのデフォルトをGoogleからBingへの変更を検討 | 見送り |
| 背景 | AIを組み込んだ検索のほうがいいのでは、という揺らぎ | Google一強が変わろうとしている |
ステップ20:「インプラント」で検索すると見える、Yahoo!とGoogleのわずかな違い
では、実際にやってみましょう。何でもいいのですが、講義では有名なキーワードとして「インプラント」という言葉でYahoo!で検索してみました。
検索結果がこう出てくると思うのですが、たとえばここに「メディカルノート」というサイトが出てきていますよね。ほかにも日本歯科医師会や、長岡の歯医者さんなど、いろいろ出てきていると思います。
このいちばん上の「メディカルノート」というサービスは、Yahoo!さんが提携している会社なんですね。だから、ここがいちばん上に出るようになっています。でも、見ただけでは分かりませんよね。メディカルノートのドメインに飛んでいるだけで、Yahoo!と提携しているかどうかなんて分からないじゃないですか。
つまり、このメディカルノートさんはYahoo!と提携していて、この位置を確保しているわけです。スライドでは、2018年6月4日のYahoo! JAPANとメディカルノートの提携に関するプレスリリースもご紹介しました。同じように、2021年3月1日には「mybest(マイベスト)」とYahoo! JAPANの提携のような例もあります。
Googleの検索結果でも広告を出すことはできますが、Googleの広告には「スポンサー」と書いてあります。これはスポンサーと書いてある広告ですね、これもスポンサーで広告ですね、と区別できます。ところがYahoo!のメディカルノートの枠には何も書いていないでしょう。広告ではないけれど、提携によってこの位置を確保しているわけです。
そうなると、Yahoo!も結局、お金や力がある人のほうが検索結果で自分のサイトを出せるので、「それってずるいよね」と思うわけです。でもGoogleのほうには、こういうことはないので、平等と言えば平等、公平と言えば公平なんですね。
違いはそこだけで、それ以外の順位はGoogleと一緒です。デザインがどうこうという話はちょっと置いておいて、順位だけで言うと同じものが出ています。
| 比較項目 | Yahoo! JAPAN | |
|---|---|---|
| 検索順位の元 | Googleの検索エンジン | Google自身 |
| いちばん上に出るもの | 提携先のサービス(例:「インプラント」ならメディカルノート) | 「スポンサー」と明記された広告 |
| 広告・提携の表示 | 提携枠であることが分かりにくい | 「スポンサー」と書かれている |
| それ以外の順位 | Googleと同じ | ― |
ステップ21:ツールバー獲得合戦の時代
これも皆さん知っていますかね? 「ツールバー」って覚えていますか? Internet Explorer、IEというブラウザには、上のところにツールバーをインストールすることができたんですね。たとえばYahoo!のツールバーを入れると、そこに自動的に検索窓がつくので、そこで検索するとYahoo!の検索になるわけです。
ということは、いろいろなブラウザがあったとしても、そこに便利なツールバーを入れてもらえれば、自分たちの検索エンジンのシェアを上げることができる。だから「ツールバー獲得合戦」というものが一時期あったんです。
ところが、スライドの右側を見ても分かるように、ほとんどのツールバーはサービス終了になっています。今残っているのは、たぶん楽天ツールバーぐらいではないでしょうか。ほぼ全部なくなっていると思いますが、楽天はたぶんあると思います。全部入れると、こんな感じになっていました。パソコンの画面の上が1行ずつ削られていって、ツールバーだらけになるんです。
| ツールバー | 終了時期 |
|---|---|
| Alexa | 2022年5月1日 |
| 2021年12月15日 | |
| AOL | 2021年3月17日 |
| Bing | 2021年3月17日 |
| JWord | 2019年7月31日 |
| @nifty | 2018年3月15日 |
| Yahoo! | 2017年10月31日 |
| Biglobe | 2016年3月24日 |
| OCN | 2016年3月22日 |
| goo | 2016年3月22日 |
| Excite | 2015年4月30日 |
| NAVER | 2013年4月10日 |
こんなことが昔あったのですが、これも全部、Internet Explorerの人気がなくなったことで、なくなったという感じです。
ステップ22:Chromeのアドレス欄が「検索の入口」になった
そして皆さんがGoogle Chromeを使うようになったら、もうGoogleの天下です。皆さんはたぶん分かっていると思いますが、一応やってみます。ブラウザでサイトを開いていても、上のアドレス欄、ツールバーのところでも検索できますよね。そこで「長岡」と打てば、検索できる。アドレス欄がそのままキーワードの検索窓になっているわけです。
だから、いちいちGoogleのページを開かなくても、今開いているブラウザの上のアドレス欄にキーワードを打てば検索できる。皆さん、わざわざGoogleのトップページを開いて検索する、ということはしていないでしょう?
パソコンでも、ブラウザのタブを新しく開いたら、もうそこにGoogleが出てきますよね。Chromeを使っていたら必ずGoogleが出るようになっています。だからGoogle.comを開かなくても、Googleを使っている。普通にウェブサイトを開いていても、そこで何かを打てば検索できる。こうなっているので、Googleの天下になっているわけです。
| 時代 | 検索の入口 | 特徴 |
|---|---|---|
| 以前 | ブラウザに追加したツールバー | 各社が検索の入口を獲得しようとし、画面がツールバーだらけに |
| 今 | ブラウザのアドレス欄 | 検索サイトのトップページを開かなくても、今見ているページからすぐに検索できる |
URLを入れる場所が、検索の入口になったんですね。どの検索サービスで検索するかは、ブラウザの種類や設定によって異なります。使うブラウザや検索先を変更することで、別のサービスを利用することもできます。
ステップ23:【考察】Yahoo!は「負けた」のか ― 戦略の選択として見直す
ここまでの話を聞くと、「Yahoo!はGoogleに負けた会社」というイメージを持った方が多いかもしれません。でも、僕はネットビジネスのコンサルタントとして長く仕事をしてきた立場から、少し違う見方も紹介しておきたいと思います。
確かに、検索エンジンの技術競争という意味では、Yahoo!はGoogleに勝てませんでした。カテゴリー検索は人間の手作業に頼っていたので、7の7乗、約82万サイトという限界を超えたところで、ロボット型のGoogleに追い抜かれた。自社でキーワード検索のエンジンを開発することも諦めて、2010年からはGoogleの技術を借りています。ここだけを見れば「負け」です。
でも別の見方をすると、Yahoo! JAPANは「検索エンジンの技術」ではなく「インターネットの玄関口」で勝負していた会社だとも言えます。ニュース、天気、ショッピング、オークション、知恵袋、路線情報など、検索以外のサービスで利用者を集め、その入口の1つとして検索を置いていた。技術そのものはGoogleから借りても、利用者が毎日訪れる場所であり続けることができれば、ビジネスとしては成り立つわけです。高いお金をかけて勝てない技術競争を続けるより、強い相手の技術を借りて、自分たちの得意な分野に集中する。これは経営の判断としては合理的な選択でもあります。
一方で、そのやり方には弱点もあります。裏側の技術を他社に頼っているということは、その他社の方針が変われば、自分たちのサービスも影響を受けるということです。2023年に検索技術の切り替えが検討されたのも、AIの時代に入って「このままGoogleに頼っていていいのか」という問いが出てきたからでしょう。また、「インプラント」の例で見たように、提携先を目立つ位置に出すやり方は、利用者から見ると「それってずるいよね」と感じられる面もあります。
| 観点 | 「負けた」とする見方 | 「戦略的な選択」とする見方 |
|---|---|---|
| 検索技術 | Googleに勝てず、自社開発を断念 | 勝てない競争から撤退し、費用を他の事業に回した |
| カテゴリー検索 | 人力の限界を超えられなかった | インターネット初心者を迎え入れる役割を果たし終えた |
| 収益モデル | 審査料ビジネスは2018年に終了 | 時代に合わせて収益源を切り替えてきた |
| 今後のリスク | ― | 裏側の技術を他社に頼る構造、提携枠の分かりにくさ |
僕が皆さんに伝えたいのは、「勝ち負け」で単純に判断するのではなく、それぞれの会社が何を目的にして、どんな選択をしたのかを見ることが大事だ、ということです。ビジネスモデルを考えるということは、まさにそういうことなんですね。そして、Yahoo!が初心者に親切だったカテゴリーの考え方は、楽天市場のメニューや、スマホの5個のアイコン、ECサイトのカテゴリー機能など、形を変えて今もあちこちに生き続けています。
「考えない」キーワード検索から「意図を理解する」生成AIへ
ステップ1:ChatGPT searchとGoogleで「長岡 ランチ」を検索してみる
では、Googleの話をしたいと思います。先ほど堀江さんがかなり詳しく話してくれたので、僕がそれほど詳しく言う必要はないのですが、キーワードを入れるとバーンとダイレクトにページにアクセスできるようになったから成功した、という話がありましたよね。
ここで1つ、お話ししておきたいことがあります。後でも出てくるので、同時にやってみました。画面の左側はChatGPTです。ChatGPTの中には「ChatGPT search」というウェブ検索機能が入っています。右側はGoogleです。Googleでも同じように検索ができます。
左側のChatGPTで「長岡 ランチ」と検索します。同じ言葉をGoogleにも入れて、同じように検索します。そうすると、Googleはすぐに答えが出てきたのに、ChatGPTのほうはまだウェブ検索の答えを考えていて、答えが出てきません。
そうすると皆さん、「なんだ、ChatGPTってバカじゃん。Googleなんか一瞬で答えていたじゃん」と思いませんか?
これは皆さん、たぶん確認している人はいないと思うのですが、調べてみてください。昔は「長岡」について検索したときに、検索結果が出るまでの時間が「2秒かかりました」とか「0.5秒でした」とか、数字で表示されていたんですね。「0.3秒で答えを出します」というふうに。それがYahoo!などと比べてGoogleはバーンとすぐに答えが出てくるので、「Googleすげえ」と言われていたわけです。
そうこうしているうちに、やっとChatGPTの答えが出てきました。でも遅いですよね。
ステップ2:Googleは「考えて」いない ― 答えは事前に用意されている
Googleはめちゃくちゃ速いから「すごい」と言われてきたのですが、皆さん、騙されないでほしいんです。Googleは、キーワードを打って検索ボタンを押してからバーンと出すから速いと思っているかもしれませんが、押してから検索して答えを出しているわけではありません。
どういうことかと言うと、「長岡 ランチ」の検索結果のページを、事前にもう作ってあるんです。 このページは作ってあるので、あなたが「長岡 ランチ」と打った瞬間に、作っておいたページを「はい、これ」と出しているだけです。だから考えて出しているのではなく、もう答えが用意されているんですよ。
みんながどんなキーワードで検索しているかは事前に分かっているので、その答えを用意しておいて、「はい」と出しているわけです。本当に考えようと思ったら、今のChatGPTのように時間がかかるはずなんですね。
ChatGPTの場合は、今まさに打った言葉について、今まさに考えています。あなたが「長岡 ランチ」で検索しているのなら、講義をしている今の時間だと、もう今日のランチではないですよね。今日のランチの時間は終わっている。だから明日のランチだろう。明日空いているランチのお店なら、今日が定休日でも明日は開いているはずだから、そこを出してあげようかな、と考えて出すわけです。
Googleはそういうことはしません。検索結果には「スポーツの日は営業時間が異なる場合があります」と出ていましたが、講義をしたのは祝日のスポーツの日の夕方です。今日のランチを出したって仕方がないじゃないですか。今からランチには行かないでしょう? だから、Googleは考えていないんですよ。今まで皆さんはGoogleを賢いと思っていたかもしれませんが、実はめっちゃバカなんですね。それに、ChatGPTが出てきたときにみんなが気づいたんです。
「なんだ、Googleって」と。Google以上のものがなかったから、Googleより賢いものを知らなかっただけで、比較したら気づくわけです。
| 比較項目 | Google(キーワード検索) | ChatGPT search(生成AI検索) |
|---|---|---|
| 表示の速さ | 一瞬(昔は「0.3秒」などと表示) | 考える時間がかかる |
| 仕組み | あらかじめ作った索引・結果ページから、入力語に応じて候補を返す | 依頼の条件を読み取り、必要な情報を検索・参照し、説明文にして出力 |
| 「長岡 ランチ」を夕方に検索すると | 今日のランチの候補をそのまま出す | 「今からなら明日のランチ」と考え、明日営業している店を出す |
| 返ってくるもの | Webページの候補一覧(検索結果ページ) | 条件に沿って整理された回答 |
ステップ3:長い相談文にすると、Googleは急に「バカ」になる
「長岡 ランチ」のような単純なワードなら差はつきにくいのですが、では複雑な文章にしたらどうなるでしょうか。
たとえばChatGPTでウェブ検索にチェックをつけて、こう入力します。
「今週末、初めて彼女とデートする予定です。彼女はインスタ映えするお店が好きで、肉料理が好きだと言っているんだけど、長岡市でランチのおすすめのお店があったら10件ぐらい教えて」
これを教えてもらおうとします。同じ文章をGoogleにもキーワードとして打って、エンターを押したとします。
そうしたら、Googleのほうで、あなたが打った内容にぴったりのお店が出てきますか? なぜかいきなり横浜のお店が出てきたりしていますよね。ラーメン巡りになっていたりもする。ラーメンなんて言っていないじゃないですか。
なぜこんなにバカなのかと言うと、あなたが今打ったこのキーワードにマッチするページがないからです。この文章に対する答えのページを、Googleは用意していない。だから急にこれを言われても、ページがないわけです。
だから慌てて、適当に何か出しておけ、と適当に出しているんですね。急にバカになるんです。みんながよく使っているキーワードは答えを用意しているからあるのですが、こんな長い文章になった瞬間に、急にバカになる。
一方、ChatGPTのほうは、あなたが打ったものを今考えて、ちゃんと「週末」だからと、10月17日、18日と日付を出してくれています。週末だと分かっているんですね。週末に営業しているお店で、あなたの条件に合うならここがいいよ、とちゃんと教えてくれます。
このように、文章が長くなればなるほど、文脈を理解し、意図を理解して答えなければいけないので、考える必要があります。でもGoogleは全然考えていないので、答えが出ない。そのことに、みんなが気づき始めたわけです。
| 相談文に含まれる条件 | 内容 |
|---|---|
| ① 場所 | 長岡市 |
| ② 時間 | 今週末・ランチ(相対的な日時を、利用日として捉える。例:10月17日・18日) |
| ③ 目的 | 初めてのデート |
| ④ 好み | 写真映え(インスタ映え)・肉料理 |
| ⑤ 回答形式 | 候補を約10件 |
単語だけの依頼(「長岡 ランチ」)では「地域と食事」という条件で検索されますが、相談文では、地域・食事に加えて、目的や相手の好みなども含めて検索してもらえる、という違いがあります。
ステップ4:GoogleはAIモードを追加し、2社が並んだ
そうするとGoogleは、このままではやばいぞということに気づきました。そこで検索画面の上のところに「AIモード」というものを追加しました。AIモードを押すと、ChatGPTと同じように、AIが今すぐ答えを考えて書いて出すものを作ったわけです。
これで晴れて、2社が並んだわけです。これが今の検索エンジンの歴史です。
| 段階 | Googleの対応 |
|---|---|
| ChatGPT登場前 | 事前に用意した検索結果をキーワードに合わせて一瞬で表示 |
| ChatGPT search登場後 | 長い相談文や意図の理解でChatGPTとの差が明らかに |
| 現在 | 検索画面に「AIモード」を追加し、AIが回答を生成する機能でChatGPTと並ぶ |
ステップ5:ページランクの仕組み ― リンクは「点数」を配る行為
ちょっと話がそれましたが、ここでページランクの話をします。これはすごく大事で、テストにも出たことがあります。ページランクの仕組みは次のようになっています。
誰かから誰かにリンクを貼るという行為は、点数を上げることになります。
たとえば、90点のサイトがあるとします。このサイトから3つのサイトにリンクを貼っているとすると、90÷3で、それぞれ30点ずつもらえます。
別のサイトは、この90点のサイトからのリンクで30点、50点のサイトからも50÷2で25点、さらに別のサイトからも5点もらっているので、合わせて60点になりますよ、というわけです。
これをずっと、みんなからリンクをもらったり、あげたりしてぐるっと1周回ると、また最初のサイトに戻ってきます。最初のサイトが点数をもらうと、元の点数が90点だったのが30点もらって120点になったとします。
この120点はまた3で割らなければいけないので、今度は40点ずつ配ることになり、また1周回ってぐっと計算していくわけです。ずっとこれを続けていくと、全員の点数がどんどん変わっていきますよね。バーッとずっと全部計算していって、ある一瞬で「えい」と止めたときに、「じゃあ、あなたのサイトは何点ですよ」と出しているわけです。これがページランクという仕組みです。
| 計算の流れ | 内容 |
|---|---|
| ① 点数を持つサイトがリンクを貼る | 90点のサイトが3サイトにリンク → 90÷3=30点ずつ配る |
| ② 複数のサイトからリンクをもらう | 30点+25点(50÷2)+5点=60点 |
| ③ 1周回って最初のサイトに戻る | 90点のサイトが30点もらって120点に |
| ④ 再び配り直す | 120÷3=40点ずつ配る |
| ⑤ 計算を繰り返し、ある時点で止める | そのときの点数がそのサイトのページランク |
スライドではページランクを0〜10の11段階で示す表も載せています。たとえばページランク10にはTwitter、9には500〜600ほどのサイト、Facebookなどが並び、ECサイトは3〜4あたり、というようなイメージです。
Googleは、Yahoo!のように人間がカテゴリーに分類するのではなく、トップページだけでなくカテゴリーページや商品ページなど、あらゆるページに直接ロボットでたどり着き、リンクの関係から点数をつけた。だから階層の深さの限界がなかったわけですね。
ステップ6:「僕のブログのリンクを貼ってね」の本当の理由
なので、リンクをもらうということは、点数をもらえるということなんです。だから「横田先生が喜ぶよ」と言っているわけです。
皆さんのレポートのときに「僕のブログのリンクを貼ってね」と書いていたと思いますが、あれは皆さんから点数をもらえるからなんですね。皆さんのブログは今日noteを始めたばかりなので、もともとの点数がないから少ないけれど、それでももらえる。1点ぐらいもらえるわけです。なので嬉しいです。
今度は逆に、僕がたくさんの人からもらっているリンクの点数を、僕から皆さんへのリンクを通して皆さんにあげるので、皆さんのところの点数もまた上がるわけです。こういう仕組みになっているのが、ページランクというものです。
| 流れ | 内容 |
|---|---|
| ① 学生がブログを紹介 | 自分のレポートから、参考にした講師の記事へリンクする。読者が出典をたどれる |
| ② 講師がレポートを紹介 | 講師のブログから、学生のレポートへリンクする。別の読者が学生のレポートを見つける入口になる |
| ③ 講義ではPageRankになぞらえて説明 | 他のページからのリンクが、ページ評価の手がかりになるという考え方 |
ただし、「1点もらえる」などは講義中のたとえです。実際の評価は固定点数ではなく、リンクだけで検索順位が決まるわけでもありません。ほかにもコンテンツの内容など、さまざまな要因が関係します。
ステップ7:検索回数は増え続け、私たちは「記憶」を犠牲にした
さっきもありましたが、Googleは広告をやっている会社です。その話の前に、これを考えてほしいのですが、Googleで検索される数は毎年どんどん増えていると思いませんか?
スライドに載せたデータでは、Googleの検索回数は1999年には年間10億回程度だったものが、2000年には140億回、2001〜03年には550億回、2004〜08年には730億回、2009年には3,650億回、2012〜15年には1兆2,000億回、2016年には2兆回、そして2021年には2兆8,470億回(2,847,000,000,000回)にまで増えています。2016年ごろの数字で見ると、年間2兆回、1ヶ月で1,670億回、1日で55億回、1時間で2億2,800万回、1分で380万回、1秒で6万3,000回です。
| 期間(2016年ごろ) | 検索回数 |
|---|---|
| 年 | 2兆回 |
| 月 | 1,670億回 |
| 日 | 55億回 |
| 時 | 2億2,800万回 |
| 分 | 380万回 |
| 秒 | 6万3,000回 |
皆さん、小学校のときより、今のほうがググっていますよね? でも、昔はググらなくても生きてきたはずなんです。それなのに、ググらないと生きていけない人間になっていませんか? ググらなければいけないことが増えたのかもしれませんが、皆さんが何を犠牲にしたかと言うと、記憶を犠牲にしたんです。
暗記を犠牲にしたわけです。覚えておけば2回目は検索しなくていいのに、皆さんはすぐ「そういえば、この間の打ち合わせ、何だったっけ?」「今度どこで会うんだっけ?」となったときに、すぐスマホを見る。スマホに答えがあると思ったら、覚えないんです。
スライドでは、2011年7月14日に科学誌『Science』に掲載された「Google Effects on Memory: Cognitive Consequences of Having Information at Our Fingertips(Googleが記憶に与える影響:情報が指先にあることの認知的帰結)」という研究もご紹介しました。後で調べられると分かっている情報は覚えにくく、その代わりに「どこにあるか」を覚えるようになる、という「トランザクティブ・メモリー(交換記憶)」の話です。
これはすごく顕著で、僕らの昔、これは電話の回にまたお話ししますが、電話番号を10件ぐらい覚えていたんですね。友達の家の電話番号など、いろいろ覚えていて、何も見なくても電話のボタンを押せた。皆さん、電話番号を何件覚えていますか?
たぶん自分の家ぐらいしか覚えていないのでは? 友達の家の番号は覚えていないでしょう。だって、スマホを見れば出てくるから。結局、それはググるのと同じ話で、検索しなくても情報が出てくると分かると、覚えなくていいと思うようになるんですね。
人間は効率よく、賢くなりたいと思うので、「覚えなくても載っているなら、覚えなくていいじゃん」と思うわけです。
ステップ8:だから「ググって出ない情報」をテストに出す
だから僕は、初回の講義のテストの話のときに言ったわけです。「ググって出ない情報をテストに出すよ」と。
ググって出る情報は、もう価値がないからです。ググれば分かるんですから。だからググって出ない情報、つまり僕がしゃべった内容や、スライドに書いていない内容をどうやってメモするか、ということがテストのときに活きますよ、という話をしているんですね。
| 比較 | 僕らの昔 | 今の皆さん |
|---|---|---|
| 覚えている電話番号 | 友達の家など10件ぐらい | 自分の家ぐらい |
| 打ち合わせの内容や待ち合わせ場所 | 覚えておく | すぐスマホで確認する |
| 犠牲にしたもの | ― | 記憶(暗記) |
| テストで問われるもの | ― | ググって出ない情報(講義で話した内容、スライドにない内容) |
ステップ9:Apple・Amazon・Google・Facebook・Microsoftの売上構成
次はAppleさんの売上の構成比です。iPhoneが62%で、残りがMacなどです。Appleという会社は、ハードウェアで儲けている会社だということがよく分かりますね。
Amazonは、Amazonという通販サイトの売上と、クラウドサービス(AWS)の売上で成り立っている会社です。
そしてGoogle。Googleの赤い部分は広告です。Googleは広告で成り立っている会社です。スライドに載せた2010年のGoogleの売上構成では、広告が96%、その他が4%でした。最近の数字でも、Alphabetの売上の約85%が広告です。Facebookなんてもっとすごくて、98.5%が広告で成り立っている会社です。
Microsoftはバランスがよくて、ハードウェアの部分や、OS(Windows)の部分、いろいろなもので成り立っている会社です。同じIT企業でも、何で儲けているかはこんなに違うんですね。
| 企業 | 主な収益源 | 特徴 |
|---|---|---|
| Apple | iPhone(62%)、Macなど | ハードウェアで儲ける会社 |
| Amazon | 通販サイト、クラウドサービス | ECとクラウドの会社 |
| Google(Alphabet) | 広告(2010年は96%、近年も約85%) | 広告で成り立つ会社 |
| Facebook(Meta) | 広告(98.5%) | ほぼ広告のみの会社 |
| Microsoft | ハードウェア、OS、その他さまざま | バランス型の会社 |
ここで言いたいのは、Googleは広告の会社です、ということです。「承」でお話しした「なぜ検索エンジンは無料なのか」という問いの答えの1つがこれですね。Googleは広告のために検索エンジンを無料で提供している。かつてのYahoo!はカテゴリー登録の審査料、そしてポータルサイトとして自社のサービスへの入口として検索を提供していた。会社によって目的が違うわけです。
本当は、ここで検索広告の単価の話(2016年2月20日時点の「インプラント」の広告枠の例など)や、SEO(Search Engine Optimization:検索エンジン最適化)、共起語の話などもやりたかったのですが、時間がないので飛ばしました。スライドは後で上げておくので、よかったら見てください。
ステップ10:「あと300年」から「無理です」へ ― Googleがインデックスを諦めた理由
残り10分なので、ちょっと面白い話をして終わりたいと思います。
2005年、Googleはこんなことを言っていました。**「あと300年頑張れば、世界中のすべての情報をインデックスできます」**と。本に書いてある内容など、いろいろな情報を全部インデックスして、何でもググれるようにします、と言っていたんです。
ところが2008年になると、「あと200年ぐらい頑張ればできる」と言い出します。3年で100年分ぐらい縮めたわけです。そのぐらいたくさんの情報を集めていますよ、と言っていたのですが、その2年後の2010年には「無理です」と諦めたんですね。
2010年に何で諦めたかと言うと、2010年ぐらいからFacebookというSNSが出てきて、Facebook上にある内容をGoogleがインデックスできなくなったからです。FacebookのようなSNSは、Instagramもそうですが、ログインしないと情報が見られません。皆さんのところに、Googleさんからフォローが来たりはしないでしょう? フォローしないと見られない投稿は、Googleも見られないわけです。
2010年までの世の中では、インターネットの情報はほとんどが公開されている情報でした。ところがここから、公開されていない情報がどんどん増えていきました。会員登録しないと見られないサイトや、クラウドサービスがどんどん増えてきたので、インデックスすることが無理になったんですね。それで諦めた、という話なんです。
| 年 | Googleの発言・状況 |
|---|---|
| 2005年 | 「あと300年頑張れば、世界中のすべての情報をインデックスできる」 |
| 2008年 | 「あと200年ぐらい頑張ればできる」(3年で100年分短縮) |
| 2010年 | 「無理です」と断念。FacebookなどログインしないとみられないSNSが増加 |
| 2010年以降 | 会員制サイトやクラウドサービスが増え、公開されていない情報が拡大 |
スライドには、2012年1月に当時のローマ法王ベネディクト16世が「沈黙を大切に」と、検索サイトやSNSへの依存に警鐘を鳴らしたという朝日新聞の記事もご紹介しています。答えを探す多くの人が検索サイトやソーシャルネットワークを頼っていることを指摘し、うわべだけの意見交換では人は安らげないと説いた、というものです。検索とSNSが生活の一部になったことの、もう1つの側面ですね。
ステップ11:2026年、ChatGPTが検索で世界2位に
今日いちばんびっくりしたのは、これです。先にお見せしたいと思います。検索エンジンのシェアの歴史の動画(「Most Popular Search Engines: Data from 1994 to 2026」)です。
2003年ぐらいから、さっき話したようにGoogleが一強体制です。もう盤石の一強体制だったんですよ。2010年、2011年も全然、盤石じゃないですか。何も問題ない。ダントツ状態です。皆さん、僕の言いたいこと、分かりますか?
2022年、ChatGPTが出ます。はい、出ました。そうすると、ChatGPTが出てきて、なんと今、2位まで来たんです。2026年に、ChatGPTは2位まで来ました。 他の検索エンジンを全部抜いて、2位がChatGPTになってしまったんですね。
2026年の1時間あたりの検索・質問数で見ると、Googleが5億3,865万2,777、ChatGPTが6,101万268、Baiduが5,363万9,429、Bingが4,646万4,453、Yandexが2,299万2,165、Yahoo!が1,273万9,029、Sogouが890万8,792、Perplexity AIが830万4,219、Claude AIが562万904、DuckDuckGoが545万9,967です。Googleの世界シェアは72.29%、その他が27.71%で、Alphabetの時価総額は4.7兆ドルに達したとも表示されていました。
| 順位(2026年) | 検索エンジン・AI | 1時間あたりの検索・質問数 |
|---|---|---|
| 1 | 538,652,777 | |
| 2 | ChatGPT | 61,010,268 |
| 3 | Baidu | 53,639,429 |
| 4 | Bing | 46,464,453 |
| 5 | Yandex | 22,992,165 |
| 6 | Yahoo! | 12,739,029 |
| 7 | Sogou | 8,908,792 |
| 8 | Perplexity AI | 8,304,219 |
| 9 | Claude AI | 5,620,904 |
| 10 | DuckDuckGo | 5,459,967 |
これはGoogleにとっては嫌ですよ。このぐらいで、ちょびちょびで終わっているならいいけれど、伸びてくることが予測されていて、実際にここまで伸びてきてしまったわけですから。ゼロから、この4年ぐらいで。
今のGoogleだって、最初はちょびちょびだったのに、いきなりグワンと伸びたわけです。同じようにChatGPTにもグワーンと行かれたら困るじゃないですか。だからGoogleが今慌てている理由がよく分かると思います。2位まで来たんだよ、というお話です。
さっきお話ししたChatGPT searchというものがあって、検索意図を理解して検索できるようになったので、めちゃくちゃ賢くなりました。それはまだ2年前のことなんですね。
ステップ12:「見積もり」で出てこない ― 終わらない検索地獄
最後に、この話をして終わりたいと思います。皆さんにとっていい例がないので、僕の例でお話ししますが、たとえば何か探し物があったとき、メールの中を検索することがあると思います。Gmailなどで「こんなやり取りがあったはずなんだけど」というときです。
分かりやすく、僕がよく使う「見積もり」で考えます。誰かに「見積もりしてください」と言われたとしますね。そうすると、「見積もりって、誰が言っていたんだっけ?」と思ったら、Gmailの中で「見積もり」と検索すれば出てきますよね。「あ、そうそう、この人この人」と見つけられます。
では、そのときに「見積もり」と検索しても出なかったらどうしますか? 「あれ? 確かに言っていた人がいたんだけどな」と思ったら、皆さんは諦めて1通ずつメールを開いていきますか? さすがにそれはしないでしょう。
次にどうするかと言うと、「見積もり」という言葉は、「見積」が漢字で「もり」がひらがなの場合もあれば、「見積」が漢字で送りがなが「り」だけの「見積り」の可能性もあるじゃないですか。だから、それで検索してみるわけです。「見積り」で検索してみる。それでも出ない。
おかしいなと思って、「分かった、もしかしたら最初から全部ひらがなで『みつもり』と書いていたのかな?」とやってみる。でも出ない。「あ、分かった、『み積もり』と最初だけひらがなで、後ろは漢字だったのか」とやってみる。全部の組み合わせを試しても出ない。でも、確かに「見積もりを出して」と言われていたとします。
皆さんも似た例を思い出しましたか? 「〆切」「締め切り」「締切」などもありますよね。〆切はこういう字で書くのか、漢字で「締め切り」と書いているのか、ひらがなで「しめきり」なのか、いろいろあります。それを「何だっけ?」と全部のパターンで検索してみて、それでも出てこない。
| 探したい言葉 | 試す表記の例 |
|---|---|
| 見積もり | 見積もり/見積り/見積/みつもり/み積もり |
| 締め切り | 〆切/締め切り/締切/しめきり |
これがキーワード検索の限界です。キーワード検索というのは、あなたが打ったキーワードに完全に一致するものを見つけることしかできないので、実は超バカなんですよ。それでも今の皆さんは賢いと思っていたわけですが、ChatGPTなどの生成AIは、あなたが打っている言葉の意図を理解するんですね。
ステップ13:生成AIは「意図」を理解する
見積もりも締め切りもそうですが、生成AIは、その言葉を使っていなくても、結果的に「締め切り」のことを言っている、ということを理解します。
たとえば「レポートの締め切りは10月19日です」と書かれているのではなく、「レポートは10月19日までに出してね」としか書かれていなければ、「締め切り」という言葉はありませんよね。ということは、「締め切り」で検索しても「までに」は出てこないわけです。でも生成AIに「レポートの締め切りっていつだっけ?」と聞いたら、ちゃんと教えてくれます。見積もりも、「金額を出して」としか言われていなくても答えが出てくるのが生成AIです。
これが「意図を理解している」ということです。さっきの「デートに行きたいんだけど」という話も同じです。さっきは言わなかったのですが、普通に考えたら、あんな長い文章で検索する人はいないじゃないですか。
だから、それにぴったりのページがあるわけがない。今までは、そのキーワードがあるページを出していたのですが、こんな長い文章を打つ人はいないから出ないわけです。でも普通の人間なら、この文章で出なかったら「分かった、分かった」と、この中から「彼女」「デート」「インスタ」「長岡」「ランチ」という言葉だけをピックアップして検索すればいいじゃん、と気づきますよね。あるいは「長岡 デート 〇〇」とやれば出るよね、と気づく。
じゃあ、裏でGoogleがそれを考えて、その検索結果を出せばいいわけです。でも、それすら考えていないということでしょう? つまり、Googleは考えていないんです。なぜかと言うと、事前に用意された答えを、あなたが打ったキーワードにマッチさせて出しているだけだから。それに対して、ちゃんと意図を理解して考えるようになったのが生成AIということです。
だからやっぱり、みんなが便利だということで使うようになってきたんですね。
| 比較項目 | キーワード検索 | 生成AI |
|---|---|---|
| 仕組み | 指定された単語(文字列)と完全に一致するものを探す | 言葉の意図・文脈を理解する |
| 「締め切り」で検索して「10月19日までに出してね」は? | 見つからない | 見つけられる |
| 「見積もり」で検索して「金額を出して」は? | 見つからない | 見つけられる |
| 長い相談文 | マッチするページがなく、的外れな結果に | 条件を分解して考え、答えを組み立てる |
| たとえ | 融通の利かないマニュアル人間 | 意図を汲んでくれる相談相手 |
ステップ14:図書館で考える、探し方の3つの時代
ということで、今日の内容をまとめるとこうなります。
Yahoo!時代の「カテゴリーで選ぶ」は、百貨店、あるいは図書館のようなものです。図書館が分かりやすいですね。図書館に行ったとき、たとえば小説コーナーや教育コーナーなどに分かれていて、そのコーナーに行くと、そこがまたカテゴリーに分かれていて、その中の作家別の棚などを見て選ぶじゃないですか。これが図書館というカテゴリー検索です。
でも、カテゴリーをたどって探しに行くのが面倒な場合は、皆さんは店員さん(司書さん)に「この本が欲しいんだけど」と言いますよね。そうすると店員さんがその場所に連れて行ってくれて、「これですよ」と指差してくれる。これがGoogleがやっていること、キーワード検索です。便利ですよね。
ただ、キーワード検索ではダイレクトにそこに行けるので便利ですが、カテゴリーの場合は「何だっけ?」と探しながら歩くので、違う本を見つけたりする可能性がありますよね。「あ、他にいい本が見つかった」ということがある。これがYahoo!とGoogleの違いです。
そして今度は、AIにチャットで聞くようになります。そうすると店員さんが「この本はないかもしれないけど、この本に似ているこういうものなら、他にこんなのもあるよ」と教えてくれたりするわけです。ぴったりではないけれど「他ならこの本もいいよ」と。こういう形で、探し方は今、3パターン目に来ているんですよ、ということです。
| 時代 | 探し方 | たとえ | 利用者の行動 | 課題・特徴 |
|---|---|---|---|---|
| 1990年代:Yahoo!時代 | 「選ぶ」カテゴリー検索 | 百貨店・図書館のコーナーをたどる | クリックで選択。ジャンルを絞り込んでいく | 欲しいものが決まっていると時間がかかる。一方で別のいい本に出会える |
| 2000年代:Google時代 | 「探す」キーワード検索 | 店員さんに「この本ください」と指名買い | キーワードで検索。目的のページに直接アクセス | 曖昧なニーズや長い文章に対応できない |
| 2020年代:生成AIチャット時代 | 「聞く」相談・提案 | 専門家に相談すると、似た本や別の候補も教えてくれる | 対話で相談。目的や状況を伝える | 意図を理解し、最適な候補を提案してくれる |
スライドでは、ECサイトのUIもこれと同じように、Step1:カテゴリー機能の実装、Step2:サイト内検索機能の実装、Step3:AIチャット機能の実装、と進化してきていることもまとめました。AmazonではAIアシスタント「Rufus(ルーファス)」を利用している顧客の購入完了率が、利用していない顧客に比べて60%高いという結果も出ているそうです。
この流れが、来年また同じ時期に授業があると思うのですが、そのときにChatGPTのシェアがどのぐらい増えているのか、ちょっと楽しみだったりします。
ステップ15:日本のPC検索で、BingがGoogleを逆転?
もう1つ、この話をしておきたいと思います。ちょっとびっくりなんです。恐ろしいことが起きていて、日本の検索エンジンのシェアが変化しています。去年から今年にかけて、Googleのシェアが一気に落ちて、Bingのシェアがめちゃくちゃ上がったんですね。
なぜ上がったのかと思って分析してみると、パソコンでのシェアで、急にBingが上がっているんです。去年まではこのあたりだったのに、抜いているんですよ。パソコンでのシェアは、Googleが42.17%に下がって、Bingが51.83%なので、逆転しているんです(statcounterのデータ)。
正直、僕の感覚ではそんなことはありえないと思っているのですが、このデータを見る限りでは逆転しています。何が世の中で起きているのか分からないので、よかったら皆さんも調べてみてください。
| 日本のPCにおける検索エンジンシェア(2026年) | シェア |
|---|---|
| Bing | 51.83% |
| 42.17% |
ステップ16:【考察】生成AI検索とどう付き合うか ― 便利さとリスクの両方を見る
講義の最後は時間切れになってしまったので、ここで僕なりの補足を書いておきます。ここまで「Googleはバカで、生成AIは賢い」という話をしてきましたが、これも一方的に受け取るのではなく、両方の面から考えてほしいんです。
まず、生成AI検索の便利な点です。長い相談文の意図を読み取ってくれる。表記ゆれがあっても、言いたいことを理解してくれる。「明日のランチ」のように、今の時間や日付を踏まえて考えてくれる。そして答えを文章にまとめてくれるので、自分で何ページも開いて比べる手間が減ります。
一方で、注意すべき点もあります。1つ目は、AIはもっともらしく間違えることがある、という点です。存在しないお店や、営業時間が変わったお店を紹介してしまうこともあります。だから、AIが出した答えの引用元を開いて、自分で確かめる習慣が大切です。2つ目は、答えがまとめて出てくるぶん、さっきの図書館のたとえで言う「別のいい本に出会う」偶然が減るかもしれない、という点です。AIが提案してくれる候補は便利ですが、AIが選ばなかったものは見えなくなります。3つ目は、OpenAIがChatGPTに広告を入れ始めたように、生成AIもいずれビジネスモデルの影響を受ける、という点です。Yahoo!の提携枠や、Googleのスポンサー表示と同じように、「なぜこの答えが出てきたのか」を考える目を持っておく必要があります。
そしてもう1つ、記事を書く側から見た変化もあります。AIが答えを文章でまとめてくれると、利用者は元のウェブサイトを開かなくなるかもしれません。今までは検索結果からクリックしてもらうことでアクセスが集まっていましたが、これからは「AIに引用されること」が大事になっていく可能性があります。さっきの「AIの引用元の82%が人間の記事」という数字は、人間が書いたオリジナルの体験や意見が、AIの時代にこそ価値を持つということでもあると思います。
| 観点 | 生成AI検索の良い面 | 気をつけたい面 |
|---|---|---|
| 理解力 | 長い相談文や表記ゆれから意図を読み取る | もっともらしく間違えることがある |
| 時間・状況 | 今の時刻や日付を踏まえて考える | 情報が古いままの場合もあるので確認が必要 |
| 手間 | 答えを文章にまとめてくれる | 引用元を開かず、偶然の出会いが減る |
| ビジネスモデル | 無料でも高度な検索が使える | 広告などの影響を受ける可能性 |
| 発信する側 | 人間のオリジナルな記事が引用されやすい | 元のサイトへのアクセスが減る可能性 |
僕からのおすすめは、目的に応じて使い分けることです。正確な公式情報や、決まった言葉で探したいときはキーワード検索。条件が複雑な相談や、言葉にしにくい探し物は生成AI。そして大事な情報は、必ず元のページで確かめる。カテゴリーで「選ぶ」、キーワードで「探す」、AIに「聞く」という3つの探し方を、全部使いこなせる人が、これからの情報社会でいちばん強いのではないかと思います。
| 目的 | おすすめの探し方 |
|---|---|
| 公式サイトや決まった言葉の情報を確実に見つけたい | キーワード検索 |
| 何があるのかを広く眺めたい、偶然の出会いがほしい | カテゴリー(サイト内メニュー、図書館の棚) |
| 条件が多い相談、言葉にしにくい探し物 | 生成AIに聞く |
| 大事な判断の前 | AIの引用元や公式ページを開いて自分で確認する |
スライドは後で全部上げておきますので、ご覧になってください。ということで、時間になりましたので、今日は以上で終わります。
おわりに ― 探し方の3つ目の時代を、どう生きるか
今回は「検索エンジンの変遷と進化」をテーマに、インターネットの探し方がどう移り変わってきたのかをお話ししました。ウェブサイトが1個しかなかった1991年から、14億を超える2026年まで。人間が手作業でカテゴリーに分けたYahoo!は、7の7乗、約82万サイトという限界を超えたところで、ロボットが巡回してページランクで順位をつけるGoogleに主役の座を譲りました。そのGoogleも、実は答えを事前に用意しているだけで「考えていない」ことが、ChatGPTの登場で明らかになり、2026年にはChatGPTが検索で世界2位にまで迫っています。
「選ぶ」「探す」「聞く」。探し方は今、3つ目の時代に入りました。でも、どの時代にも共通しているのは、道具が便利になるほど、私たちが何かを手放しているということです。暗記を手放し、検索の技術を手放し、偶然の出会いを手放す。だからこそ、自分の着想や体験、そしてググっても出てこない情報の価値が、これからますます高まっていくのだと思います。来年の今ごろ、ChatGPTのシェアがどこまで伸びているのか。皆さんと一緒に見届けたいですね。
まとめ
- 前回の振り返り:Milia「World Wide Web」で、インターネットの誕生、リンク、IP・ドメイン・DNS、通信速度、ブラウザの歴史を復習した
- AI作曲の作り方:鼻歌のサビとギターのリフを起点に、AIが曲全体を補完。AI任せの「ガチャ」ではなく、人間の着想を起点にすることが大事
- ラージランゲージメロディ:ひらめきの材料は蓄積したインプット。3ヶ月ほどでメロディーが浮かぶようになった
- Google誕生の秘密:ページランク、安いPCサーバーを大量に並べた「力技」、広告の受発注の自動化。Googleは売上の9割以上が広告の会社
- 今のAI競争も同じ構図:半導体(計算資源)を大量に確保した会社が勝つ
- 情報爆発:1日に受け取る情報量は平安時代の一生分、江戸時代の1年分。SNSも全部は読み切れない
- ウェブサイト数:1991年に1、1992年に10、1993年に130、1994年に2,738、2000年に1,700万、2026年に約14.9億
- AI記事の増加:Rettyは2020年にAI記事でアクセス285倍。2022年11月30日のChatGPT以降、公開記事の48%がAI生成、検索上位では人間86%・AI14%、AIの引用元は人間82%・AI18%
- Yahoo!の時代:2001年に世界で最も人気のサイトに。1999年には検索シェアも世界1位。ポータルサイト(玄関口)として初心者に親切だった
- 選択肢の数:5個が理想、7個が限界(日本人)。iPhone、Instagram、X、TikTok、楽天市場のメニューにも表れている
- カテゴリー検索の限界:7の7乗=82万3,543サイト。1997年にウェブサイトが82万を超え、翌1998年にGoogleが誕生
- Yahoo!のビジネスモデル:カテゴリー登録の審査料5万〜15万円(落ちても返金なし)。アメリカは2014年、日本は2018年にカテゴリー終了。Yahoo!きっずも2026年12月4日に終了
- Yahoo!とGoogleの検索結果は同じ:2010年からYahoo! JAPANはGoogleの検索技術を利用。違いは提携枠の有無
- 検索の入口の争い:GoogleはAppleに初期設定の費用を支払い、かつてはツールバー獲得合戦、今はChromeのアドレス欄が入口
- Googleは「考えていない」:答えを事前に用意しているから速い。長い相談文や表記ゆれ(見積もり/見積り、〆切/締め切り)には弱い
- 生成AIは意図を理解する:「までに」から締め切りを、「金額を出して」から見積もりを読み取る。GoogleもAIモードを追加
- ページランク:リンクは点数を配る行為。90÷3=30点ずつ、計算を繰り返して点数を決める
- 記憶の犠牲:検索に頼るほど暗記しなくなる。だからテストは「ググって出ない情報」
- インデックスの断念:2005年「あと300年」、2008年「あと200年」、2010年「無理です」。ログインが必要なSNSの登場が原因
- 2026年の検索シェア:ChatGPTが世界2位に。日本のPC検索ではBingが51.83%、Googleが42.17%と逆転したというデータも
- 探し方の3つの時代:Yahoo!の「選ぶ」(図書館の棚)、Googleの「探す」(店員さんに指名)、生成AIの「聞く」(相談して提案をもらう)
<a id=”よくある質問”></a>
よくある質問(Q&A)
Q1. YahooとGoogleでは、検索結果が違うのですか?
A. 基本的な検索順位は同じです。Yahoo! JAPANは2010年からGoogleの検索技術を借りているため、「Yahoo!派」「Google派」と分かれていても、出てくる順位はほぼ一緒です。2010年より前は、Yahoo!も自社で検索エンジンを開発していましたが、Googleに勝てないと判断して技術を借りる選択をしました。違いがあるとすれば、Yahoo!では提携しているサービス(たとえば「インプラント」で検索したときのメディカルノートなど)が上位の目立つ位置に表示されることがある点です。Googleの広告には「スポンサー」と表示されますが、Yahoo!の提携枠は見ただけでは分かりにくいので、注意して見てみてください。実際に両方で同じ言葉を検索して、並べて比べてみると面白いですよ。
Q2. なぜYahoo!のカテゴリー検索はなくなってしまったのですか?
A. 大きな理由は、ウェブサイトの数が人間の手で分類できる限界を超えたからです。人間が選びやすい選択肢の数は5個が理想、7個が限界と言われています。横に7個、深さ7段までと考えると、分類できるのは7の7乗=82万3,543サイトまで。世界のウェブサイト数は1997年に約111万サイトとなってこの限界を超え、その翌年の1998年にキーワード検索のGoogleが誕生しました。また、利用者がインターネットに慣れて、目的のサービスを最初から知っているようになると、親切なカテゴリーのメニューが「余計なお世話」に感じられるようになったことも理由です。アメリカでは2014年、日本では2018年にカテゴリーのサービスが終了し、Yahoo!きっずも2026年12月4日に終了します。
Q3. Googleが速いのに「考えていない」というのはどういう意味ですか?
A. Googleは、みんながよく検索するキーワードについて、検索結果のページを事前に用意しています。だから「長岡 ランチ」と打った瞬間に、用意しておいた答えを一瞬で出せるわけです。逆に言えば、入力された言葉の意図や、今の時間・状況を考えて答えているわけではありません。夕方に「長岡 ランチ」と検索しても今日のランチの情報を出しますし、「今週末初めて彼女とデートする…」のような長い相談文では、マッチするページがないので、横浜のお店やラーメン巡りのような的外れな結果が出てしまいます。一方、ChatGPTなどの生成AIは、時間がかかる代わりに、その場で意図を読み取り、「明日のランチ」や「今週末の日付」を考えて答えます。ただしGoogleも今は「AIモード」を追加して、同じようなことができるようになっています。
Q4. ページランクとは何ですか? ブログにリンクを貼るとどうなるのですか?
A. ページランクは、Googleが検索順位を決めるために作った仕組みの1つで、「たくさんリンクされているページは良いページに違いない」という考え方に基づいています。論文の世界で、たくさん引用された論文が良い論文とされるのと同じ発想です。リンクを貼るという行為は、自分の持っている点数を相手に配ることにあたります。たとえば90点のサイトが3つのサイトにリンクしていれば、90÷3で30点ずつ配られます。これをすべてのサイトの間で何周も計算し続け、ある時点で止めたときの点数がページランクです。皆さんがレポートで僕のブログにリンクを貼ってくれると、僕は少し点数をもらえますし、僕が皆さんのレポートにリンクを貼れば、皆さんの点数も上がります。ただし、実際の検索順位はリンクだけで決まるわけではなく、内容などさまざまな要素で決まります。
Q5. これからの時代、検索とどう付き合えばいいですか?
A. 探し方は今、Yahoo!の「選ぶ」、Googleの「探す」、生成AIの「聞く」という3つ目の時代に入っています。おすすめは、目的に合わせて使い分けることです。公式サイトや決まった言葉で確実に見つけたいときはキーワード検索、条件が多い相談や言葉にしにくい探し物は生成AI、何があるかを広く眺めたいときはカテゴリーやメニューを使う、というように。そして、生成AIはもっともらしく間違えることもあるので、大事な情報は必ず引用元のページを開いて確認してください。また、検索に頼るほど記憶を犠牲にしているということも忘れずに。ググれば出てくる情報の価値は下がり、ググっても出てこない自分の体験や考え、その場で聞いた話の価値が上がっていきます。だからこそ、講義で聞いたことを自分の言葉でメモしておくことが、これからますます大切になります。
🔍 検索エンジン
検索エンジンとは、インターネット上の膨大なWebページから目的の情報を探し出す仕組みのことです。1991年には世界にWebサイトが1つしかなく、探す仕組みは必要ありませんでした。しかしサイトは2000年に1700万を超え、今も爆発的に増え続けています。日本ではGoogle・Yahoo!・Bingが三大大手です。無料で使える裏には、各社それぞれ異なるビジネスモデル(収益の仕組み)があります。
📂 カテゴリー検索(ディレクトリ型)
カテゴリー検索とは、人間がWebサイトを見て分野ごとに分類した一覧から、階層をたどって目的のサイトを探す方式です。Yahoo!が採用し、ネット初期は精度が高く主流でした。ただし1階層の選択肢を7つ、深さも7段階までとすると、7の7乗=約82万サイトが分類の限界になります。米国では2014年、日本では2018年にYahoo!カテゴリは終了しました。
⌨️ キーワード検索(ロボット型)
キーワード検索とは、検索窓に単語を入力し、その言葉を含むページを一覧表示する方式です。1998年にGoogleが登場し、カテゴリーをたどらずに目的のページへ直接たどり着ける便利さで支持を集めました。ただし、入力した言葉と完全に一致するものしか見つけられないという限界があります。「見積もり/見積り」「締め切り/〆切」のように表記が揺れると、見つからないことがあります。
🕷️ クローラー
クローラーとは、世界中のWebサイトをリンクをたどって自動的に巡回し、ページの情報を集めて検索エンジンのサーバーに蓄えるロボット(bot)のことです。インデックスとも呼ばれるこの仕組みが、キーワード検索の土台になっています。現在はネット通信の半分以上をボットが占めています。一方で、ログインしないと見られないSNSなどの情報は集められません。Googleは2010年、世界中の全情報のインデックス化をあきらめました。
🔗 ページランク
ページランクとは、Googleが開発したWebページの評価の仕組みです。「多く引用される論文ほど良い論文」という考え方をWebに応用しました。リンクを貼ることは点数を分け与えることで、90点のサイトが3サイトにリンクすると30点ずつ渡ります。これを何周も計算してページの価値を決め、検索順位に反映します。良いサイトからリンクされるほど評価が上がります。
🚪 ポータルサイト
ポータルサイトとは「玄関口」という意味で、ニュース・天気・ショッピング・ゲームなど、さまざまなサービスへの入口をまとめたWebサイトのことです。ネットで何ができるか分からない人が多かった初期には、Yahoo!のトップページをブラウザのホームに設定するのが流行しました。幕の内弁当のように「1つ見れば何でも分かる」形が日本人に好まれ、日本では長くYahoo!が強かった理由とされます。
✋ 選択肢は5〜7個
人が迷わずに選べる選択肢の数は5個が理想で、7個が限界と言われます。店員が服を勧めるときも、5着ほどに絞るのが一般的です。iPhoneのホーム画面やInstagram・X・TikTokの下部メニューが5個前後なのも、このためです。PCなら7個まで許されますが、スマホでは5個が限界です。UIデザインやWebサイトのメニュー、カテゴリー分類を考えるうえで欠かせない考え方です。
🤝 YahooとGoogleの検索提携
Yahoo! JAPANは自社の検索エンジン開発でGoogleに勝てないと判断しました。2010年からはGoogleの検索技術を借りており、その状態が16年間続いています。そのため「Yahoo派」「Google派」と言っても、検索結果の順位は基本的に同じです。違いは、提携企業の枠などが上位に表示される点くらいです。近年は契約見直しを検討するニュースも出ましたが、継続が続いています。
💰 広告ビジネスモデル
広告ビジネスモデルとは、サービスを無料で提供し、広告主から得る収入で利益を上げる仕組みのことです。Googleは売上の大半が検索広告やYouTube広告で、AndroidやChromeも広告への入口と言えます。Appleに巨額を支払ってSafariの標準検索の座を得ているのも、そのほうが広告収入が大きいからです。Facebookは売上の98.5%が広告です。かつてのYahoo!は、カテゴリー登録の審査料で稼いでいました。
🤖 生成AI検索(検索意図の理解)
生成AI検索とは、ChatGPT searchのように、入力された文章の意図や文脈を理解してその場で考え、答えを生成する検索のことです。Googleは事前に用意した結果を出すだけなので、長い文章や複雑な条件に弱いのが弱点です。生成AIは「週末」から日付を割り出すなど、柔軟に対応できます。ChatGPTは2026年に検索シェア2位まで上がり、Googleも「AIモード」を追加して対抗しています。
検索エンジンとは?誕生の背景と2つの検索方式
検索エンジンが必要になった理由|ウェブサイト数の爆発的増加
検索エンジンの歴史をひもとくと、その出発点は「情報が増えすぎて、人間の手に負えなくなった」というシンプルな事実に行き着きます。よく引用される言葉に「現代人が1日に受け取る情報量は、平安時代の一生分、江戸時代の1年分」というものがあります。厳密な出典は定かではありませんが、新聞、ラジオ、テレビ、パソコン、インターネット、スマートフォンと新しいメディアが登場するたびに、私たちが触れる情報量が飛躍的に増えてきたことは間違いありません。
その変化を端的に示すのが、世界のウェブサイト数の推移です。Internet Live Statsのデータによると、世界初のウェブサイトが公開された1991年、サイトの数はわずか1つでした。1992年に10、1993年に130、1994年に2,738、1995年に約2万3,500と増え、1997年には100万サイトを突破します。2000年には約1,700万サイトに達しました。
サイトが1つなら検索は不要です。10個ならリンクを並べれば済みますし、130個でも「日本語」「英語」のように分類すれば探せます。数千個になっても、「日本語→ビジネス」「日本語→趣味」と階層を深くすれば何とかなりそうです。しかし数百万、数千万となると、人間が分類して並べるやり方は破綻します。
一方で、情報を処理する人間の能力は、パソコンやスマホの性能が上がってもそこまで伸びていません。選べる情報量と処理できる情報量の差が開き続けた結果、「必要な情報だけを素早く見つけ出す仕組み」が欠かせなくなりました。これが検索エンジンが生まれ、進化を続けてきた根本的な理由です。
現在のSNSで、フォローしている全員の投稿やストーリーズをすべて見てから眠る人はほとんどいないでしょう。アルゴリズムが選んだものだけを見るのが当たり前になっています。情報の洪水から「何を見るか」を選ぶ仕組みの歴史こそが、検索エンジンの歴史なのです。
カテゴリ検索とキーワード検索の違い|ディレクトリ型とロボット型
検索エンジンには、大きく分けて2つの方式があります。**カテゴリ検索(ディレクトリ型)とキーワード検索(ロボット型・全文検索型)**です。この2つの違いを理解すると、検索エンジンの変遷がぐっと見通しやすくなります。
カテゴリ検索は、人間の編集者がウェブサイトを1つずつ確認し、「ビジネスと経済」「コンピュータとインターネット」「エンターテインメント」といったカテゴリに分類して登録する方式です。利用者はカテゴリを上から順にたどって、目的のサイトにたどり着きます。人が目で見て選んでいるため掲載サイトの質が高い一方、登録できる数には限りがあり、更新も追いつきにくいという弱点がありました。この方式で成功したのがYahoo!です。
キーワード検索は、「クローラー」と呼ばれるロボット(bot)が、ページからページへとリンクをたどって世界中のウェブサイトを自動で巡回し、その内容をデータセンターに蓄積(インデックス)しておく方式です。利用者が入力したキーワードを含むページを、蓄積したデータの中から探し出して表示します。初期にはDEC社の「AltaVista」が人気を集め、その後Googleが圧倒的な精度で主役の座を奪いました。
インターネットそのものが「World Wide Web(世界中に張り巡らされたクモの巣)」と呼ばれるように、ウェブはリンクという糸でつながっています。ロボット型の検索エンジンは、その糸を伝って巣全体を歩き回る存在だと考えると分かりやすいでしょう。
初期のインターネットでは、キーワード検索の精度が低く、そもそも「調べたいことを単語に置き換える」こと自体に慣れている人も少なかったため、カテゴリ検索の方が人気でした。しかしウェブサイトが爆発的に増え、検索技術が賢くなるにつれて立場は逆転します。今では検索窓にキーワードを打ち込むのが当たり前になりました。この「人力の分類」から「機械による自動収集」への移行が、検索エンジンの歴史における最初の大転換です。
Yahoo!時代|カテゴリ検索とポータルサイトが支配した1990年代
Yahoo!が日本で圧倒的に強かった理由|ポータルサイトと「幕の内弁当」
Yahoo!は1994年にスタンフォード大学の大学院生だったジェリー・ヤンとデビッド・ファイロが始めたウェブサイトのリンク集から生まれました。Googleの誕生は1998年なので、Yahoo!の方が4年早いことになります。1996年にはソフトバンクの出資でYahoo! JAPANが設立されました。講義で紹介された推計データでは、Yahoo!は1999年に検索シェアで世界トップとなり、2001年にはウェブサイト全体のアクセスでも世界有数の人気サイトになっています。
日本でYahoo!が特に強かった理由は、ポータルサイトという考え方にあります。ポータルは「玄関口」を意味します。インターネットが普及し始めた頃、多くの人は「インターネットで何ができるのか」が分かりませんでした。Yahoo!のトップページには、ニュース、天気、スポーツ、ショッピング、地図、ゲーム、占いと、あらゆるメニューが並んでいました。ブラウザ(当時はInternet Explorer)を開くと最初にYahoo!が表示されるよう設定していた家庭も多かったはずです。
一方、Googleのトップページは検索窓がひとつあるだけ。インターネットに詳しくない人には「何をすればいいのか分からない」画面でした。Yahoo!にとって検索は、あくまでポータルの数あるサービスの1つにすぎず、対してGoogleは検索に特化した後発企業だったのです。
さらに、ひとつの弁当箱に何でも詰まった「幕の内弁当」のように、1ページを見れば何でも分かる構成が日本人の好みに合っていた、という見方もあります。
ただし、利用者が賢くなると、この親切さは「余計なお世話」に変わります。Amazonを知っている人は、Yahoo!を経由せず最初からAmazonを開けばいいからです。Yahoo!のトップページの移り変わりは、Internet Archive(ウェイバックマシン)で1990年代までさかのぼって確認できます。年を追うごとにメニューが増え、カテゴリ一覧がページ中央から下部、そして右上の小さなリンクへと追いやられていく様子は、そのまま「カテゴリ検索の衰退史」になっています。
カテゴリ検索の限界「7の7乗」とYahoo!カテゴリ終了までの歩み
カテゴリ検索には、構造上の限界がありました。人が一度に比較して選べる選択肢の数は、心理学者ジョージ・ミラーが「マジカルナンバー7±2」と示したように、多くても7個前後とされます。スマホのホーム画面やInstagram、X、TikTokの下部メニューが5個前後に収まっているのも、この限界を意識したデザインです。
カテゴリを1階層7個、深さも7階層までに収めると、分類できるサイトの数は7の7乗で82万3,543サイトが上限になります。「ショッピング→BtoC→グルメ→乳製品→ヨーグルト→アロエヨーグルト」のように階層をどこまでも深くすれば、利用者は自分がどこにいるのか分からず迷子になってしまうからです。
興味深いことに、世界のウェブサイト数がこの82万を超えて約112万サイトになったのが1997年、そしてGoogleが誕生したのが翌1998年でした。カテゴリ検索が使いにくくなり始めた絶妙なタイミングで、キーワード一発で目的のページに飛べるGoogleが登場したわけです。
カテゴリ検索は、ビジネスの面でも独特でした。Yahoo! JAPANは2005年10月まで、カテゴリに登録された「人が選んだサイト」を検索結果で優先表示していました。そのため企業はこぞって登録を申請し、商用サイトは「Yahoo!ビジネスエクスプレス」で審査料(5万〜15万円・税別)を支払いました。登録料ではなく審査料なので、落ちても返金されません。広告ではなく、このカテゴリ審査の収入が検索の収益源の1つだったのです。
その後、米国のYahoo! Directoryは2014年12月31日に終了。Yahoo! JAPANは継続を表明していましたが、ビジネスエクスプレスの販売を2017年7月31日に終え、2018年3月29日に「Yahoo!カテゴリ」そのものを終了しました。Google DirectoryやDMOZなど他のディレクトリ型サービスも相次いで姿を消しています。そして子ども向けにカテゴリ型の画面を残していた「Yahoo!きっず」も、1997年の開始から29年を経て2026年12月4日にサービスを終了します。
Google時代|キーワード検索とページランクが変えた検索の常識
Googleが後発で勝てた理由|ページランクと「力技」のサーバー戦略
Googleは1998年、ラリー・ペイジとセルゲイ・ブリンが創業しました。後発でありながら、短期間でAltaVistaやYahoo!を追い抜いた理由は、大きく2つあります。
1つ目が**ページランク(PageRank)**という評価の仕組みです。学術論文の世界には「多くの論文から引用されている論文は良い論文だ」という考え方があります。これをウェブに応用し、「多くのページからリンクされているページは価値が高い」と判断しました。
仕組みはこうです。90点のサイトが3つのサイトにリンクを張ると、リンク先は90÷3で30点ずつ受け取ります。50点のサイトが2つにリンクすれば25点ずつ。あるサイトが複数のサイトから30点、25点、5点と受け取れば、合計60点になります。点数は網の目のようなリンクを何度も循環し、計算を繰り返した結果として各ページのスコアが決まります。リンクをもらうことは「点数をもらうこと」であり、点数の高いサイトからのリンクほど価値があるわけです。現在のSEO(検索エンジン最適化)で被リンクが重視される原点はここにあります。
2つ目は、元ライブドア社長の堀江貴文氏が解説する「力技のインフラ戦略」です。当時の検索サービスの多くは、高価で高性能なサーバーにエレガントなプログラムを載せ、1台で大量のリクエストをさばこうとしていました。これに対してGoogleは、モニターもケースも省いた安価なPCサーバーを大量に並べ、並列処理させることで、待ち時間のない高速な検索を実現しました。大量発注によって1台あたりのコストも下がります。
優れたプログラムよりも、ハードウェアをどれだけ投入できるかが勝敗を分ける。この構図は、半導体(GPU)を大量に確保した企業が強い現在の生成AI競争とそっくりです。検索エンジンの歴史は、AI時代を読み解くヒントにもなっているのです。
Googleのビジネスモデルは広告|Appleへの支払いと検索連動型広告
検索エンジンは誰でも無料で使えます。では、Google、Yahoo!、Bingはなぜ無料で検索を提供できるのでしょうか。その答えがビジネスモデルの違いです。
Googleの売上の大半は広告です。検索キーワードに連動して表示されるリスティング広告(旧AdWords、現Google広告)と、ウェブサイトに配信されるAdSenseが収益の柱で、YouTubeの広告も同じ仕組みの上にあります。Androidも、Google検索を標準にすることで広告枠を広げる役割を担っています。売上構成比で見ると、iPhoneなどハードウェアで稼ぐApple、ECとクラウドで稼ぐAmazonに対し、Googleは典型的な「広告の会社」です。Facebook(Meta)はさらに広告依存度が高い企業です。
Googleのもう1つの画期的な点は、広告の受発注をすべてオンラインで自動化したことです。広告代理店との打ち合わせや請求書のやり取りなしに、誰でも管理画面から広告を出稿できる仕組みを2000年代初頭に整え、売上を急拡大させました。
検索の利用者が増えるほど広告収入が増えるため、Googleは「標準の検索エンジン」の座を何よりも重視します。その象徴が、iPhoneのSafariでGoogleを既定の検索エンジンにしてもらうためにAppleへ支払っている巨額の対価です。米司法省との反トラスト訴訟の過程では、2022年の支払額が約200億ドルにのぼることが明らかになりました。
かつてはブラウザに検索窓を追加する「ツールバー」の獲得合戦もありましたが、Yahoo!ツールバー(2017年)、Googleツールバー(2021年)など、そのほとんどが終了しています。ChromeのアドレスバーやAndroidの検索窓にキーワードを打てば、そのままGoogleで検索される。「入口」を押さえた企業が勝つという原則は、検索エンジンの歴史を通じて一貫しています。
日本の検索エンジンシェアとYahoo!・Google・Bingの関係
Yahoo!とGoogleの検索結果は同じ?2010年からの提携と違い
「私はYahoo!派」「Google派」という会話をよく耳にしますが、実はYahoo! JAPANの検索結果の順位は、基本的にGoogleと同じです。Yahoo! JAPANは2010年7月にGoogleの検索エンジンと検索連動型広告配信システムの採用を発表し、同年12月から切り替えました。つまり、今の大学生が小学生になった頃から、両者の検索の中身は共通なのです。
それ以前のYahoo!は、自前のキーワード検索エンジンの開発に投資していました。しかしGoogleの精度には追いつけないと判断し、技術を借りる道を選んだわけです。2000年代後半まで日本ではYahoo!のシェアがGoogleを大きく上回っていましたが、提携後はスマホの普及とともにGoogleが逆転しました。
ただし、両者がまったく同じというわけではありません。Yahoo!の検索結果の上部には、Yahoo!が提携するサービス(医療情報のメディカルノートや、商品比較のmybestなど)の情報が優先的に表示されることがあります。「広告」「スポンサー」の表記がなくても提携によって位置が確保されている点が、Googleとの違いです。また、画面デザインや周辺サービス(ニュース、知恵袋、ショッピングなど)も異なります。Yahoo!のオークションやショッピングのリアルタイム情報をGoogleが取得できるなど、提携には双方向の側面もあります。
この関係が揺らいだこともあります。2023年7月、日本経済新聞は、2025年3月末に満了するGoogleとの検索エンジン契約をLINEヤフーが見直しており、韓国NAVERなどへの切り替えも検討していると報じました。講義では最終的に見送られたと説明されていますが、Googleとの提携に見直し報道が出ること自体、以前にはなかった動きです。米国でもSamsungが2023年にスマホの標準検索をBingに変更する検討をしていると報じられました。その背景にあるのが、AIを組み込んだ検索の台頭です。
2026年の日本の検索エンジンシェア|Bing急伸とスマホでのGoogle優位
日本の検索エンジンシェアは、ここ数年で大きく動いています。アクセス解析サービスStatcounterの日本のデータ(2026年7月)を集計したレポートによると、全デバイスではGoogleが約59.7%、Bingが約32.1%、Yahoo!が約6.6%です。かつて日本で圧倒的だったYahoo!は、もはや3位にとどまっています。
注目すべきはパソコンでのBingの急伸です。2026年4月にはパソコンでBingが約52.4%、Googleが約42.7%となり、BingがGoogleを上回る月が出ました。講義でもパソコンでBing 51.83%、Google 42.17%という逆転の数字が紹介されています。7月時点ではGoogle約50.4%、Bing約44.9%とGoogleが首位に戻っていますが、数年前まで1桁台だったBingが拮抗するまでになったのは驚くべき変化です。
原因については、Windowsの標準ブラウザEdgeや、CopilotなどAI機能との連携による利用増を挙げる声がある一方、Statcounter側の計測方法の影響を指摘する見方もあり、発表元からの明確な説明はありません。データの読み方には注意が必要です。
一方、スマートフォンではGoogleが約82.6%と圧倒的で、Yahoo!が約13.7%、Bingは1%未満です。iPhoneのSafariとAndroidの標準検索をGoogleが押さえていることが、この差に直結しています。
さらに視野を「検索エンジン」から「情報を探す行動」全体に広げると、別の変化が見えてきます。米国のマーケティング会社First Page Sageの推計(2026年第3四半期)では、デジタル上の問い合わせ全体に占める割合でGoogleが56.3%、ChatGPTが18.7%とされています。推計方法には幅がありますが、2022年の登場からわずか数年で、ChatGPTがGoogleに次ぐ「探す手段」になりつつあることを示すデータです。
AI検索時代|ChatGPT searchとGoogle AIモードが変える「探し方」
キーワード検索の限界と生成AIの「意図理解」
Googleで検索するとすぐに結果が出るため、「Googleは賢い」と思われてきました。かつては「約○件(0.3秒)」と検索にかかった時間まで表示されていたほどです。しかし、よく検索されるキーワードについては、あらかじめ結果を用意しておいて瞬時に返している、と考えると実態に近くなります。
この差が露わになるのが、長く複雑な質問です。たとえば「今週末初めて彼女とデートする。インスタ映えする店と肉料理が好き。長岡市でおすすめのランチを10件教えて」と入力すると、従来のキーワード検索では、文章全体にぴったり合うページが存在しないため、別の地域のラーメン店など的外れな結果が出がちです。一方、ChatGPTの検索機能「ChatGPT search」(2024年10月提供開始)は、「週末」が具体的にいつかを把握し、条件に合う店を考えて提案します。
身近な例ではメール検索があります。「見積もり」で検索して見つからなければ、「見積り」「みつもり」「見積」と表記ゆれを試すしかありません。相手が「金額を出してください」としか書いていなければ、どの表記でもヒットしません。キーワード検索は、入力した文字列と完全に一致するものを探すだけの「融通の利かないマニュアル人間」なのです。生成AIは言葉の裏にある意図を理解するため、「締め切り」という語がなくても「10月19日までに出してね」という文から締め切りを答えられます。
これに危機感を持ったGoogleは、検索結果にAIの回答を表示する「AIによる概要」に続き、対話型の「AIモード」を2025年9月に日本語でも提供開始しました。こうして検索は、キーワードを照合する段階から、意図を理解して答えを組み立てる段階へと進化しています。
ただし、AIが生成するコンテンツも急増しています。SEO企業Graphiteの調査では、新たに公開される英語記事のうちAI生成の割合が2024年11月に50%を超え、以後ほぼ半々で推移しています。それでもGoogle検索の上位ページの86%、ChatGPTやPerplexityが引用する記事の82%は人間が書いたものでした。AIが一般化する前の2020年に、グルメサービスRettyがAIライターで1年に2万ページ以上を作り、2年でアクセスを285倍に伸ばした事例が話題になりましたが、今では誰もが同じことをできる時代です。
図書館の比喩で見る検索の3段階とこれからの情報リテラシー
検索エンジンの歴史は、図書館(書店)にたとえると分かりやすく整理できます。
**第1段階:カテゴリ検索(Yahoo!時代)**は、案内板を頼りに「小説」「教育」などのコーナーへ行き、さらに作家別の棚をたどって本を探すやり方です。手間はかかりますが、棚を眺めるうちに思いがけず良い本に出会えることがあります。
**第2段階:キーワード検索(Google時代)**は、店員に「この本がほしい」と書名を伝えると、その棚まで案内してくれるやり方です。ダイレクトに目的地へ行けて便利ですが、書名(キーワード)を正確に伝えられないと見つかりません。
**第3段階:AI検索(ChatGPT・AIモード時代)**は、店員に相談すると「その本はないけれど、目的が近いならこの本もいいですよ」と、意図をくみ取って提案してくれるやり方です。私たちの「探し方」は、今まさにこの3段階目に入っています。
一方で、便利さには代償もあります。2011年に米コロンビア大学の研究者らが科学誌Scienceに発表した論文「Google Effects on Memory」では、後で検索できると分かっている情報は記憶されにくく、人は情報そのものより「どこにあるか」を覚えるようになると報告されました。電話番号をいくつも暗記していた時代から、スマホを見れば分かる時代へ。検索に頼るほど、記憶を外部に預けているともいえます。
また、2005年に「世界中の情報をインデックスするには300年かかる」と語ったGoogleも、ログインしなければ見られないSNSや会員制サービスが広がると、ウェブの情報をすべて集めることはできなくなりました。検索エンジンに出てこない情報は増え続けています。
だからこそ、これからの情報リテラシーで大切なのは、「ググれば分かる情報」の価値が下がることを前提にすることです。そのうえで、AIに問いを立てる力、出てきた答えの出典を確かめる力、そして検索では出てこない一次情報や自分自身のひらめきを持つことが求められます。検索エンジンの変遷を知ることは、AI時代の情報との付き合い方を考える出発点になるのです。
ファクトチェック・訂正表(講義書き起こしとの照合)
| 書き起こし/スライドの記述 | 確認結果 | 記事での扱い |
|---|---|---|
| 「2022年の11月31日にChatGPTが起こした革命」 | 11月31日は存在しない。ChatGPT公開は2022年11月30日(講義の別箇所でも正しく30日と発言) | 記事では日付を出さず「2022年の登場」と記載 |
| 「オンラインで公開されている記事の48%がAIの生成物」 | スライドのGraphite/Axiosグラフは2025年5月時点でAI 52%・人間 48%。数字が逆。AIが50%を超えたのは2024年11月(50.3%) | 「2024年11月に50%を超え、以後ほぼ半々」と記載 |
| 「2026年までに9割がAIになる予測」 | 予測として広く引用されるが、実データ(Graphite)ではほぼ半々で横ばい | 記事では不採用 |
| Rettyの事例「1年間で2万ページ、2年間で285倍、570万MAU」 | Business Insider Japan(2020/1/8)と一致。2018年1月の2万MAU→2019年12月に570万MAU | 正しいため採用 |
| 「パソコンのシェアがGoogle 42.17%、Bing 51.83%で逆転」 | 講義スライドの数値。公開レポートで確認できたのは2026年4月の Bing 52.42%/Google 42.65%(7月は Google 50.37%/Bing 44.90%で再逆転) | 講義の数値と、確認できた4月・7月の数値を併記 |
| 「2026年にChatGPTが検索エンジンシェア2位」 | Statcounterの検索エンジン集計にChatGPTは含まれない。講義では動画のデータとして紹介。First Page Sageの推計(2026年Q3)ではGoogle 56.3%、ChatGPT 18.7% | 「推計」と明記して First Page Sage の数値で記載 |
| 「Yahoo!検索は2025年3月末満了でGoogleからの変更を検討→見送り」 | 日経(2023/7/1)が報道。変更見送りの公式発表は確認できず | 「講義では見送られたと説明」と出典を明示 |
| 「Yahoo!とGoogleは2年契約で毎年12月更新」 | 公開資料で確認できず | 記事では不採用 |
| 「Yahoo!きっずは2026年12月4日で終了」 | LINEヤフー公式発表と一致(1997年開始、29年) | 採用 |
| 「Yahoo!カテゴリ登録の審査料5万〜15万円」 | スライド(Yahoo!公式ガイド引用)で「5万円〜15万円(税別)」 | 「税別」を補って採用 |
| 「82万3,543サイト(7の7乗)」 | 計算は正しい(7^7=823,543)。スライドの「823,524」は誤記 | 823,543で記載 |
| 「日本人は7個、海外の人は11個まで選べる」 | 学術的な裏付けを確認できず。一般にはミラーの「マジカルナンバー7±2」 | ミラーの説のみ採用 |
| 「Googleは1億台サーバーを準備」(堀江氏の動画) | 比喩的な誇張と判断 | 「安価なPCサーバーを大量に並べた」と表現 |
| 「Googleは検索にかかった時間を表示していた」 | かつて「約○件(○秒)」と表示されていたのは事実 | 採用 |
出典
| 内容 | 出典 |
|---|---|
| Yahoo!きっずの終了(2026年12月4日) | LINEヤフー お知らせ/GameBusiness.jp |
| AI生成記事の割合、Google上位86%・AIアシスタント引用82%が人間 | eWeek「AI Now Writes Half of the Internet…」(Graphite調査) |
| 日本の検索エンジンシェア(Statcounter 2026年4月・7月) | 日本の検索エンジンシェア|PCとモバイルで違う推移とAI検索 |
| Google vs ChatGPT の問い合わせシェア推計(2026年Q3) | First Page Sage「Google vs ChatGPT Market Share」 |
| Yahoo!のGoogle契約見直し報道(2023年) | 東京報道新聞(日経報道を引用) |
| Yahoo! JAPANのGoogleエンジン採用(2010年) | Web担当者Forum/ITmedia |
| RettyのAIライター事例 | Business Insider Japan(2020/1/8) |
| Google AIモードの日本語提供(2025年9月) | Web担当者Forum/gihyo.jp |
| ウェブサイト数の推移、Yahoo!カテゴリ・ディレクトリ終了日、ツールバー終了日、ページランク図解 | 講義スライド「情報リテラシー論03 検索エンジンの変遷と進化」(Internet Live Stats、Yahoo!公式告知等の引用を含む) |
| Google Effects on Memory | Sparrow, Liu & Wegner, Science(2011年7月) |