
AIに関するニュース2026年8月分Podcast配信:画像生成AI2系統
2026年8月30日の生配信は、月1回のポッドキャスト同時配信として、ChatGPT LiveとGemini Liveを交えながら画像生成AIを論じた回。横田氏は画像生成AIを、感覚で描く右脳的な「イラストレーター派」と、ロジックで組み立てる左脳的な「デザイナー派」の2派閥に分類。GPT-Image 2はJSONなどコード構造で描くため日本語の文字化けが減ったと分析した。今後の競争軸はスピード・印刷対応の画質・レイヤー制御の3点で、Canva AIやGrokが先行。AIっぽさの解消には光の制御と、AIに欠けた「体験」の補完が課題と結んだ。
詳しくは15分の動画で解説しました。
https://www.youtube.com/watch?v=z-pFX88ARqQ
0:00 🎙️ 導入・ポッドキャスト同時配信スタート 0:38 🤖 ChatGPTライブとGeminiライブを呼び出し 1:00 🎨 画像生成AIには2大派閥がある 1:20 🧠 右脳型と左脳型、ロジックで描くか感覚で描くか 2:21 🖌️ イラストレーター派とデザイナー派の違い 3:41 💻 GPT Image 2はJSONで描く?HTML学習と日本語表示の精度 4:48 🔤 HTMLで書けないデザインはAIも苦手 5:54 📊 サムネやバナーには絵心+マーケティングの頭脳が必要 7:05 ⚖️ 右脳と左脳のバランスが効果的なビジュアルを生む 7:50 🍌 各モデルの立ち位置とNano Bananaへの期待 8:30 🚀 GPT Image 2やGrokに追いつけるか、今後のアップデート 9:36 🏎️ 進化の3軸①スピード ②レイヤー分け ③画質 10:56 🗂️ レイヤー制御はCanva AIが先行、各社に期待 12:07 🔥 Nano Bananaの逆襲を待つ 12:50 💡 AIっぽさを消す鍵は「光の制御」 13:17 📷 写真と同じくライティングで仕上がりが決まる 14:28 🧭 AIに足りないのは「体験」・まとめ
AIに関するニュース2026年8月分Podcast配信:画像生成AIに2大派閥
前回の「ひまわり」に続いて今回の「裸足」も
まだ公開していない裏ワザで書いています。
イーンスパイアの横田です。
https://www.enspire.co.jp/
男性のサビは僕の作詞作曲ですが。
誰も書けない歌詞を無料で書ける。
しかもPVも無料で作ってるんだけど
知りたい人いるのかな?
裸足で歩く夏 / Milia
https://www.youtube.com/watch?v=eYSCDSK6EQw
裸足の君は
https://www.youtube.com/watch?v=zfOi8dOx3xg
さて、本題です。
ChatGPT音声会話とGemini Liveと
僕の3人で対談し今回のAIについて
解説した様子をライブ配信しました。
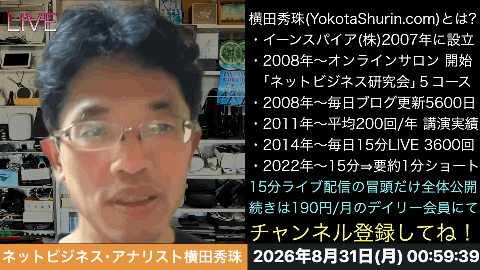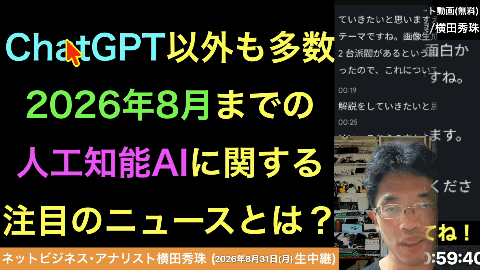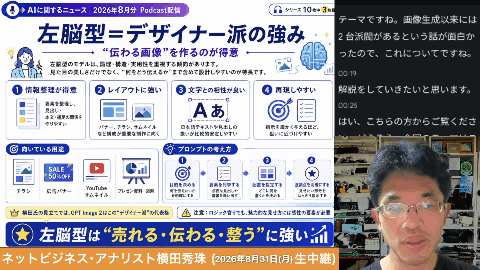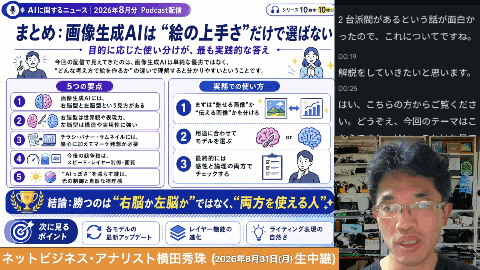
AIに関するニュース2026年8月分Podcast配信:画像生成AIに2大派閥
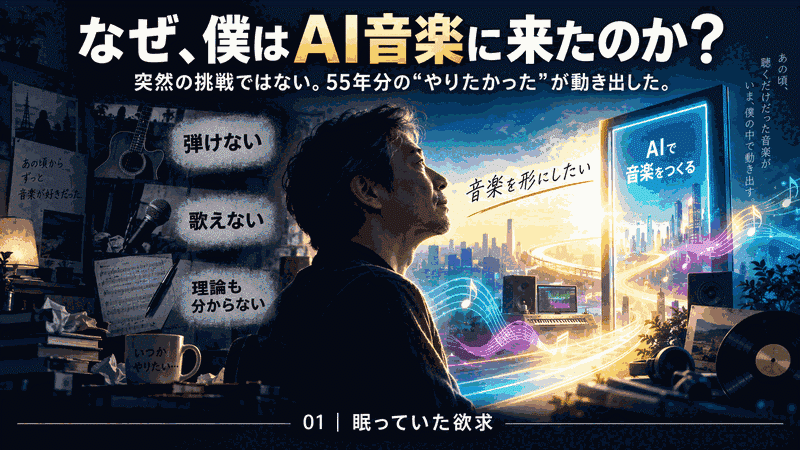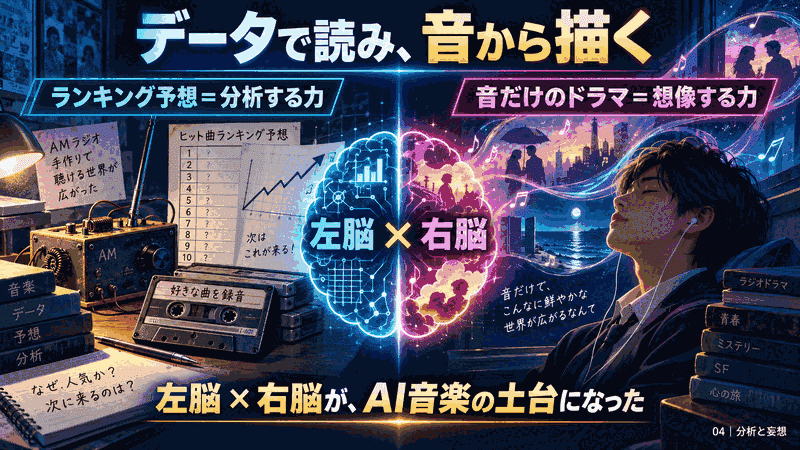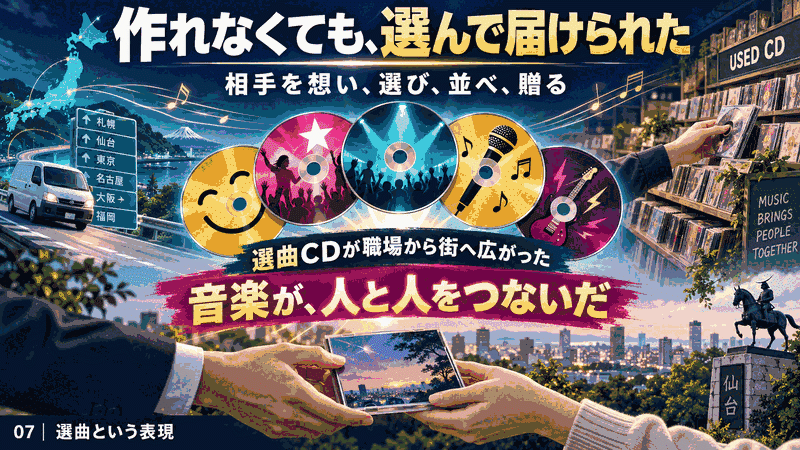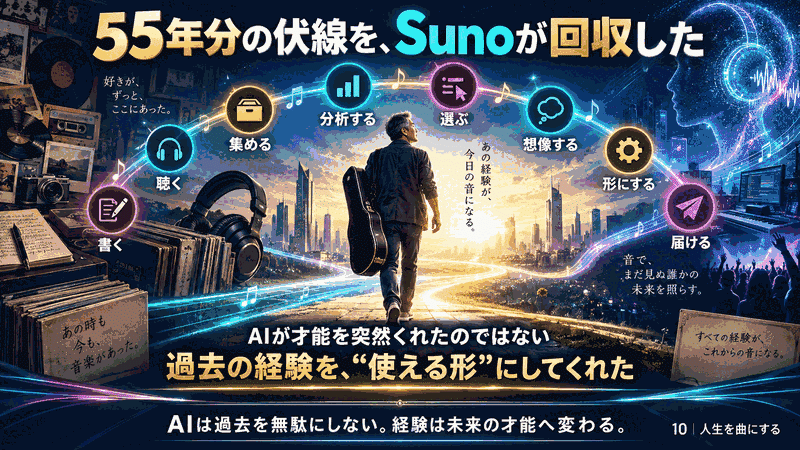
画像生成AIは右脳と左脳の2派閥!進化の3軸を読む
1今日のテーマ:画像生成AIに“2つの派閥”がある
直近1ヶ月のAI注目トピックを、音声AI2人と一緒に語る恒例の月イチ企画。今回のお題は画像生成AIの派閥論。
画像生成モデルは「ロジックで絵を描くタイプ」と「感覚で絵を描くタイプ」に分かれている。
呼び方はいろいろ ── 右脳 / 左脳設計図派 / 絵の具派イラストレーター派 / デザイナー派
「これ、画像生成のモデルで違うのって皆さん気づいてますか?」
── 横田秀珠
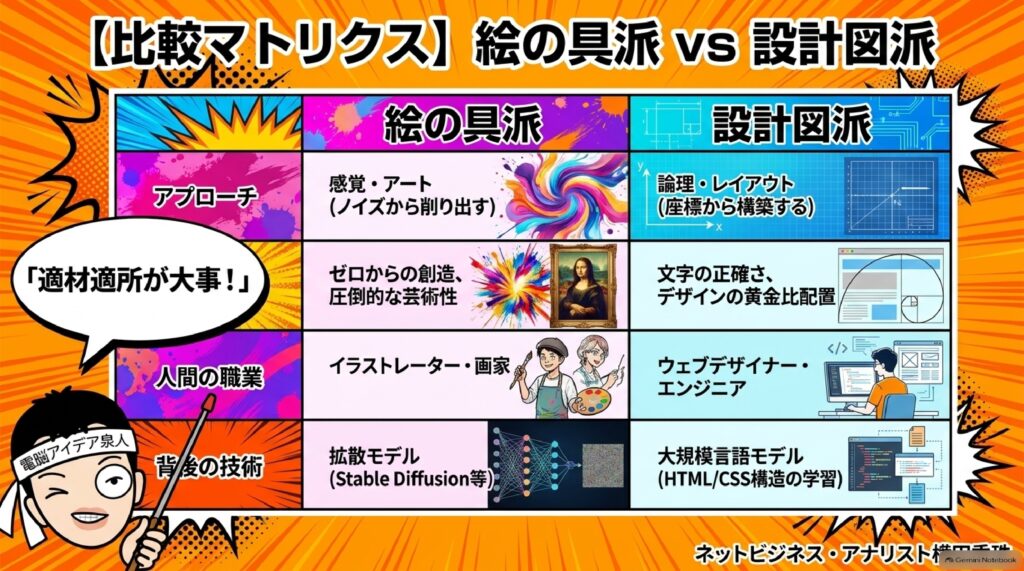
2右脳派 vs 左脳派をならべてみる
右脳/イラストレーター派
- 絵の具派=直感で描く
- アートとしての自由さ・個性
- 芸術的なニュアンスが強み
- 直感的な指示のほうが映える
左脳/デザイナー派
- 設計図派=ロジックで組む
- 商売の成果物としての目的・機能性
- 構造的なプロンプトで精度が出る
- 細かく論理的に積み上げる
⇅ どちらが上ではなく「使い分け」 ⇅
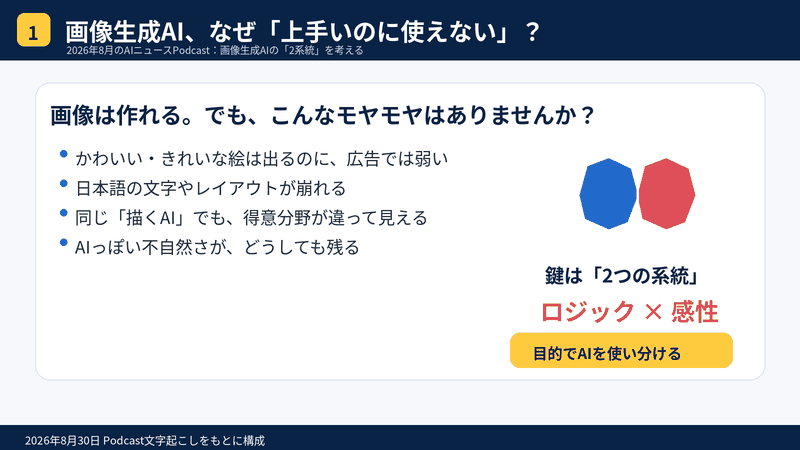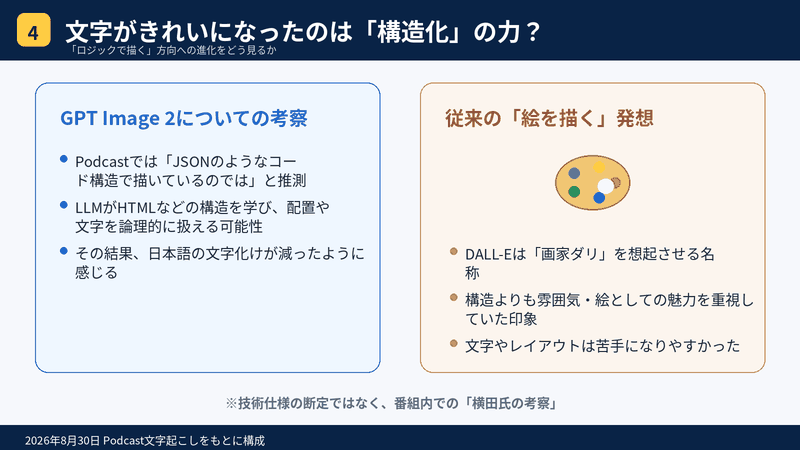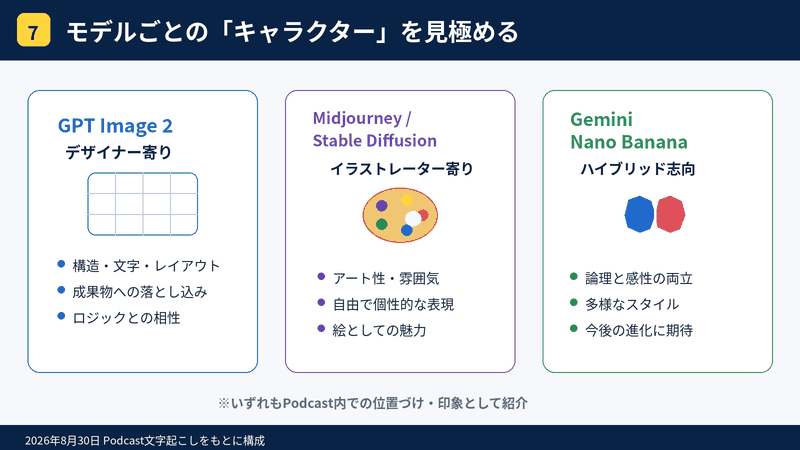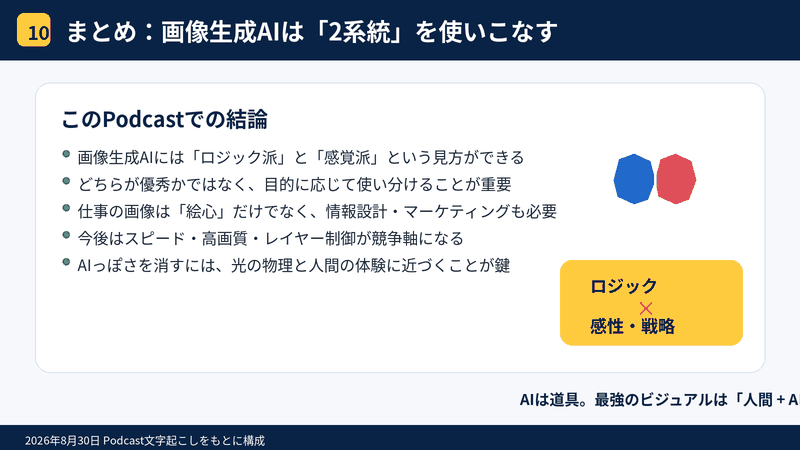
🖌 ざっくりモデル分類:GPT Image 2 はデザイナー系/以前からある Midjourney・Stable Diffusion はイラストレーター系(右脳の絵心)。
「デザイナーは商売としてもやっていかなきゃいけないので左脳的。イラストレーター派は絵を描く感じなので、直感的に右脳でやってるんじゃないかな」
── 横田秀珠
3GPT Image 2 の裏側は“JSONというコード”?
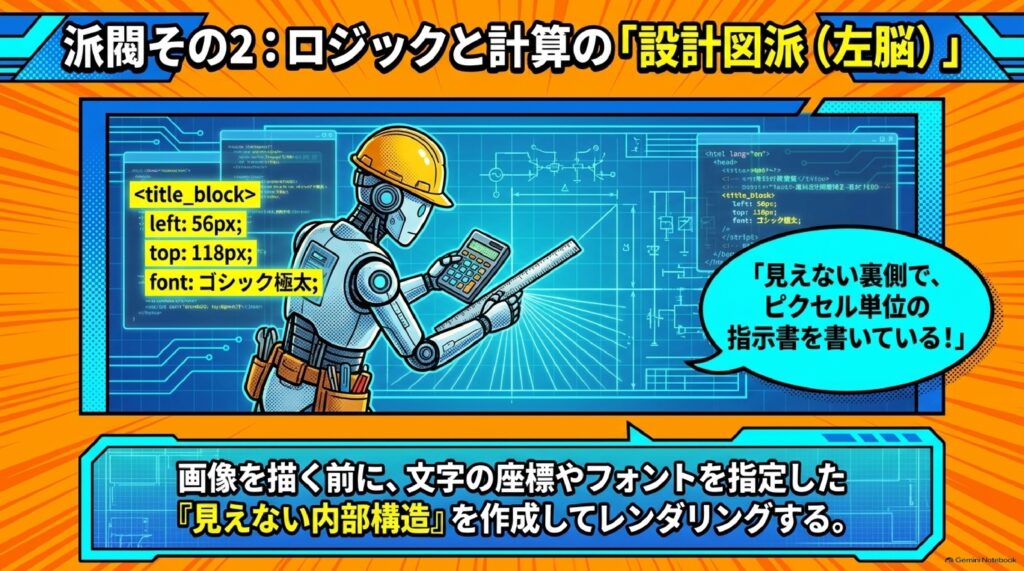
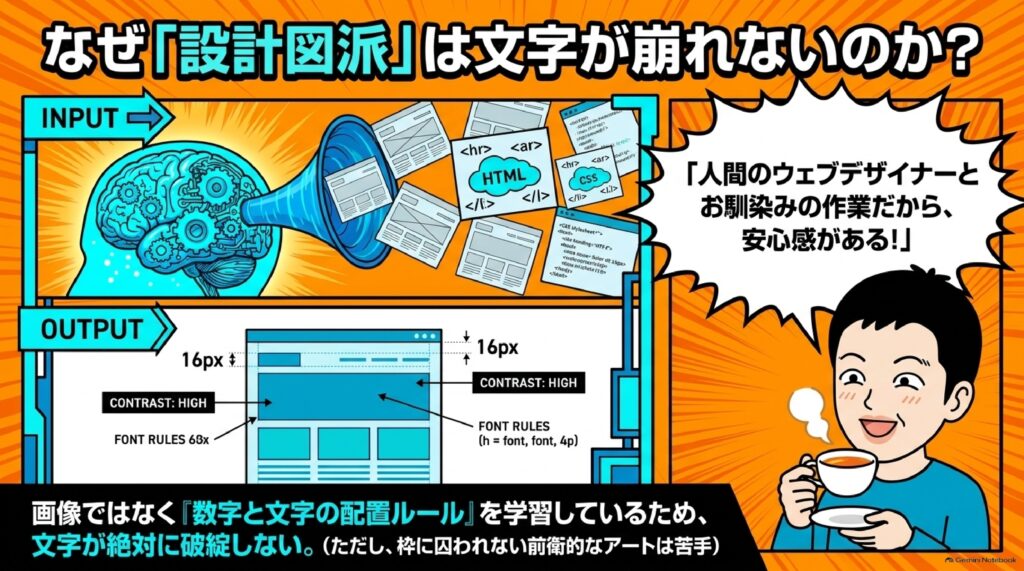
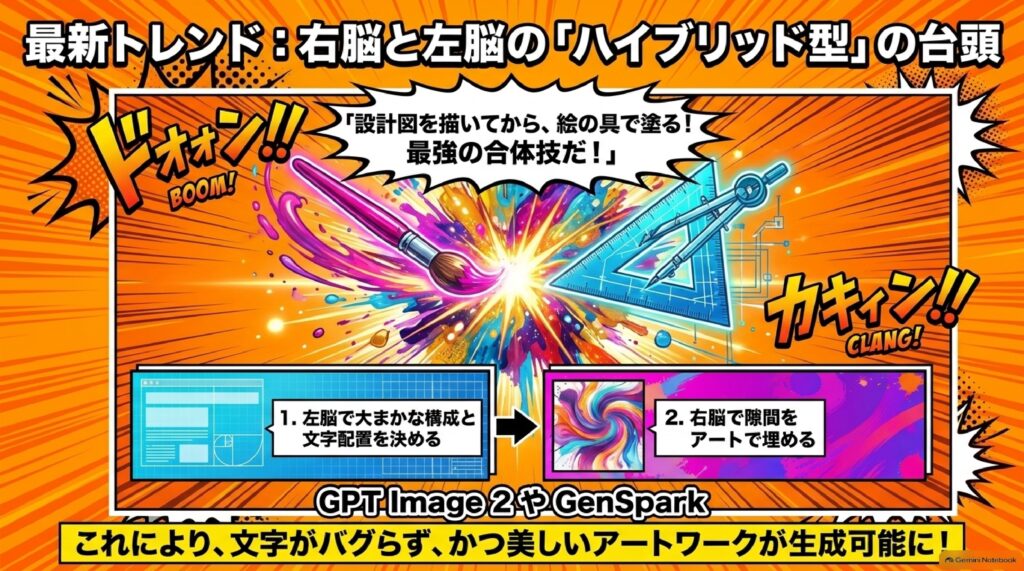
最近の進化を見ていると、裏側は JSON のコードで書かれているように見える。つまり LLMがHTMLを学習 したことで、ロジックを使って絵を描いている。
1
LLMが HTML/コード を学習する
2
裏側で JSON的な構造 として画を設計
3
写真をはめたり、描いた絵を配置していく
4
結果、日本語の文字化けが激減(=ハイブリッド化)
DALL-E は名前のとおり画家のダリに由来。「絵を描く」イメージのモデルだったからこそ、文字化けが多かったのでは──という見立て。
BEFORE:DALL-E系
- “絵を描く”発想が中心
- 日本語の文字化けが多い
AFTER:GPT Image 2
- コード的な設計+描画のハイブリッド
- 文字がちゃんと出るようになった
4「HTMLで描けるか」がAIの得意・不得意の境界線
HTMLで描ける=AIも描ける
- 整然としたレイアウト
- 規則的な配置・構造
HTMLで描けない=AIも苦手
- フォントが大小いろいろ混在
- 複数書体が入り混じるデザイン
💡 だからこそ:人間らしさや個性を出したいなら、あえてHTMLで描けない方向を狙う。そしてそれが使えるモデルを探すことも大事。
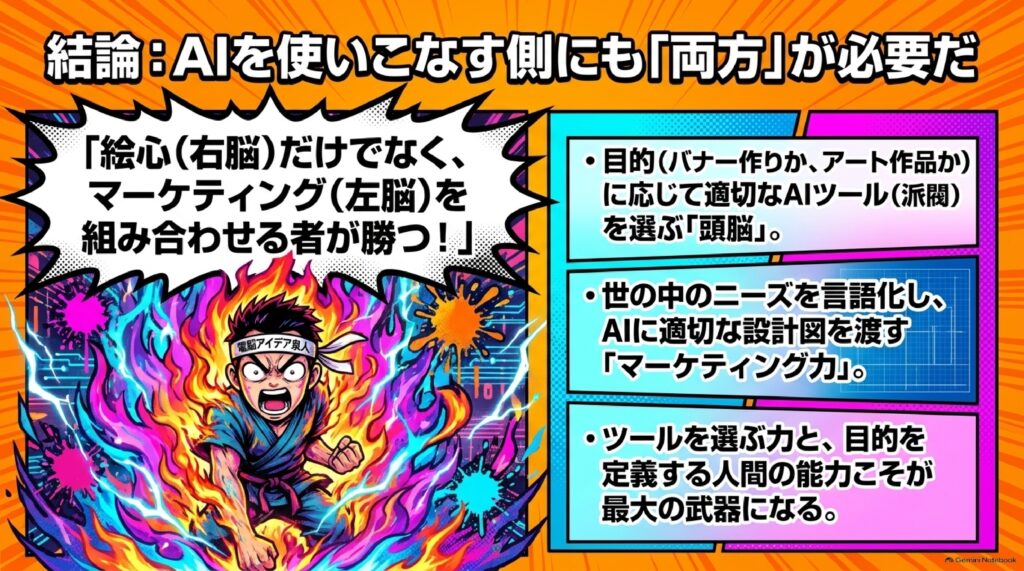
5絵心だけでは足りない ── 必要なのは“頭脳”
可愛い猫を描く、綺麗なお姉さんを描く。ここは完全に右脳でOK。でもチラシ・バナー画像・YouTubeサムネイルは話が別。
絵心右脳の表現力
+
頭脳マーケティング
=
効くビジュアルバナー・サムネ
絵が上手に描けるAIでも、頭脳を持っていないAIだと「絵心はあるけど、マーケティング的にちゃんとした画像は描けない」ことになる。
「有名な画家さんが、有名なYouTubeのサムネイルを作れるかって言ったら、そうではない。だからこの2つの合わせ技じゃないかな」
── 横田秀珠
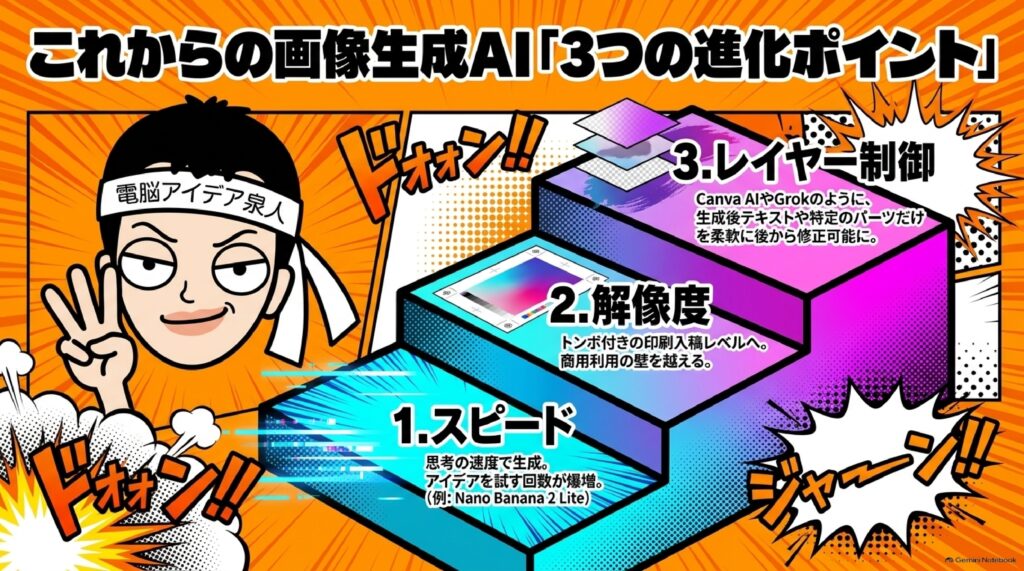
6これからの進化は“3つの軸”で決まる
絵はもうみんな描けるようになった。次に競争が起きるのはここ。
⚡ スピード
いかに早く出すか、が新しい競争軸に。試行回数が増える=アイデア検証が回る。
🗂 レイヤー分け
画像をレイヤーに分けて生成できるか。編集・調整の自由度が段違いに変わる。
🖨 画質(印刷データ対応)
4K・8K級のクオリティ。そのままデータ入稿してポスター印刷、トンボのマークまで出せたら相当やばい。
「スピードと、画質(印刷データ対応)と、レイヤーに分けて画像生成できるか。この3つだと思ってるんですね」
── 横田秀珠
7横田秀珠の個人的な優先順位
8レイヤー制御の現在地マップ
Canva AI
🥇
いちばん進んでいる。マジックレイヤーもある
Grok Imagine
🥈
だいぶできるようになってきた。ただしテキストの修正がまだできない
GPT Image 2
🔜
この分野に力を入れてほしい
Nano Banana
🔜
同じくレイヤー制御の強化に期待
🍌 Gemini の Nano Banana は、GPT Image 2 になかなか勝てず、最近は Grok Imagine にも押され気味。ただし Nano Banana 2 Lite(生成スピードがめっちゃ速い)が登場しており、ここは楽しみ。
9ここまでの流れと“逆襲待ち”
今年4月
GPT Image 2 が登場。デザイナー系の強さで一気に前へ
4ヶ月経過
Nano Banana は追いつけないまま、Grok Imagine も台頭
現在
Nano Banana 2 Lite が登場、スピード面で存在感
これから
「もう1発すごいのを」──Nano Banana の逆襲に期待
「ぜひGPT Image 2より先にね、行って欲しいなと思います。そろそろNano Bananaさんの逆襲を待ってるっていうところ」
── 横田秀珠
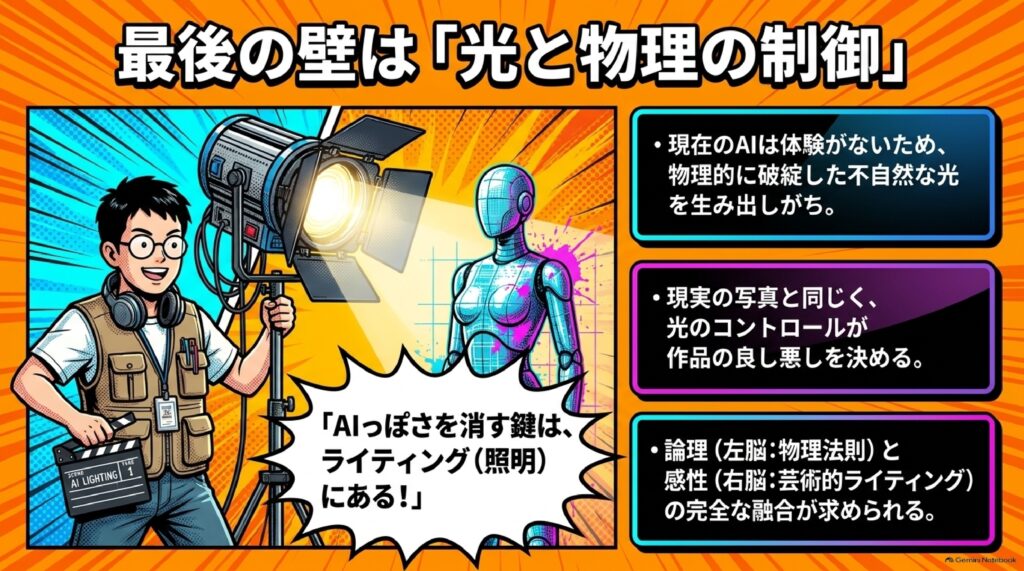
10“AIっぽさ”を消す鍵は「光の制御」
最近Xで話題になっているのが、AIっぽさをどう消すか。答えは光にありそう。
✕
光の当て具合にまだ不自然さが残る
✕
物理的に破綻している影・反射がある
○
写真も光の扱い方で良し悪しが決まる=同じ勝負どころ
◎
ここが改善されればかなり良くなる
⬇️ そして光の再現は…… ⬇️
光の制御は左脳(物理の理屈)と右脳(感覚)の両方を組み合わせる領域。まさに2派閥の融合ポイント。
11AIに足りない最後のピース=“体験”
人間
- 実際に体験している
- だから「こうなるだろう」と予測できる
AI
- 体験がない
- この部分をどうカバーするかが課題
12今日のまとめ&やること
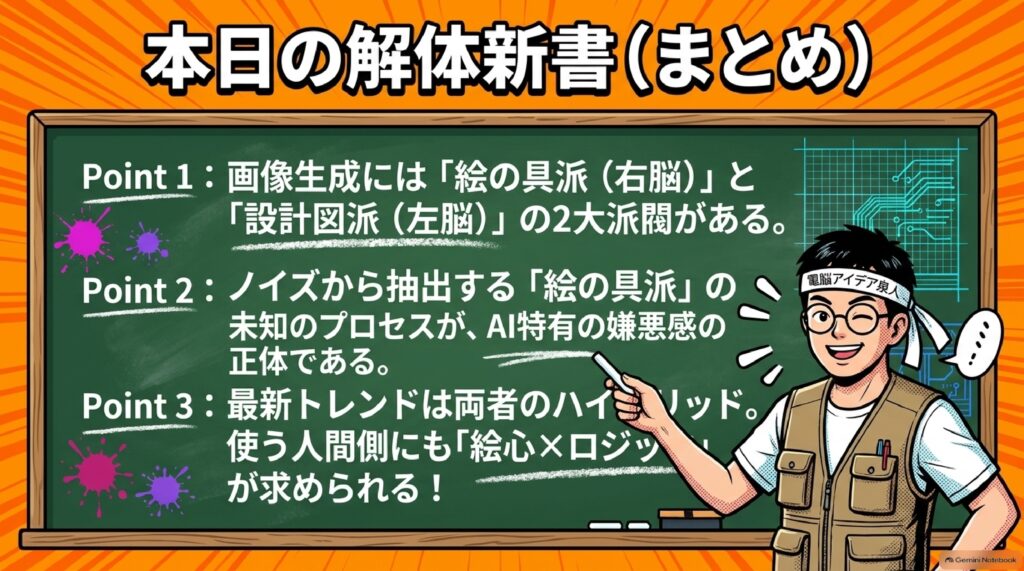
2派閥
右脳=イラストレーター派/左脳=デザイナー派
ロジック描画
コード学習で文字化けが減りハイブリッド化
進化の3軸
スピード・レイヤー・画質(印刷対応)
最後の壁
光の制御と、AIにはない“体験”
- 自分の用途が右脳寄りか左脳寄りかを先に決めてからモデルを選ぶ
- チラシ・バナー・サムネは「絵心+マーケティング」で発注する
- 人間らしさを出したいときは、HTMLで描けない表現を狙う
- レイヤー編集が要るなら、まずは Canva AI のマジックレイヤーを試す
- AIっぽさが気になったら、まず光の当たり方を見直す
AIに関するニュース2026年8月分Podcast配信:画像生成AIに2大派閥
- はじめに
- 画像生成AIに存在する2つの派閥とは?右脳と左脳、設計図派と絵の具派
- GPT Image 2はJSONで絵を描いている?HTMLで描けるデザインと描けないデザイン
- 画像生成AIの次の競争軸は3つ!スピード・画質・レイヤー制御
- AIっぽさを消す最後の鍵は「光の制御」と「体験」
- おわりに
- まとめ
- よくある質問(Q&A)
はじめに
画像生成AIを使っていて、「なんでこのモデルだとうまくいくのに、あのモデルだと全然思った通りにならないんだろう?」と感じたことはありませんか。プロンプトの書き方が悪いのかな、と自分を責めてしまう方も多いと思うんですけど、実はそれ、あなたのせいじゃないかもしれません。モデルそのものに「性格の違い」があるんです。
今日お話ししたいのは、画像生成AIには大きく分けて2つの派閥がある、という話です。分かりやすく言うと、人間の右脳と左脳です。ロジックで考えて絵を描くタイプなのか、それとも感覚で絵を描くタイプなのか。この違いに気づくと、「どのモデルをどの仕事に使えばいいのか」が驚くほどスッキリ整理できるようになります。
今回はChatGPT LiveとGemini Live、AI二人にも会話に参加してもらいながら、この派閥の話を掘り下げていきます。さらに、これから画像生成AIがどこで競争していくのかという3つの軸、そして最近Xで話題の「AIっぽさをどうやって消すか」という永遠のテーマについてもお話ししていきます。それでは早速いってみましょう。
画像生成AIに存在する2つの派閥とは?右脳と左脳、設計図派と絵の具派
まずはAI二人を呼び出すところから
配信の前に、実はGeminiには事前に声をかけていました。
横田:今日は、画像生成AIについて考えていきたいと思いますので、また後で呼びますからよろしくお願いします。
Gemini:承知いたしました。画像生成AIについてお話しできるのを楽しみにお待ちしております。いつでもお声がけくださいね。
横田:はい、お願いします。
Gemini:どのような活用法やアイデアについて考えていきたいですか? 準備が整ったら教えてくださいね。
こんな感じで、事前に「今日はこういうテーマでいきますよ」と伝えておくと、本番でのやり取りがスムーズになります。これは音声AIを配信で使うときの、ちょっとした小技ですね。いきなり本題をぶつけるよりも、テーマを共有しておいたほうがAI側も文脈を持って答えてくれます。
そして本編がスタート。ではお二方をですね、呼んでいきたいと思うんですけど、はい、お二方いるかな? いるかな? はい。こちらの方からご覧ください。どうぞ。はい。ではですね、ちょっと待ってくださいね。こんな感じでやっていきます。
今日のテーマは「画像生成の2つの派閥」
さて、今日はですね、ChatGPTとGeminiのお二人にお聞きしたいことがあります。それが、画像生成の世界には今、実は派閥が2つあるという話です。この話はご存知ですか?と振ってみました。
Gemini:画像生成AIの分野における2つの派閥についてですね。ぜひ詳しくお聞かせください。
ChatGPT:画像生成界隈でどんな派閥に分かれているのか、すごく興味あるし、どっちがどんな特徴を持ってるのかも気になるな。
Gemini:画像生成AIの2大派閥ですね。ぜひどのような派閥と捉えられているのか聞かせてください。
ChatGPT:この声でしっかりお話を聞いていくから、安心して進めてね。
二人とも興味津々です。ちなみにこの「この声でしっかりお話を聞いていくから、安心して進めてね」というChatGPTの言い回し、音声モデルの人格設定がだいぶ柔らかくなってきたなという感じがしますよね。こういう細かい変化も、毎月定点観測しているとよく見えてきます。
派閥の正体は「右脳」と「左脳」
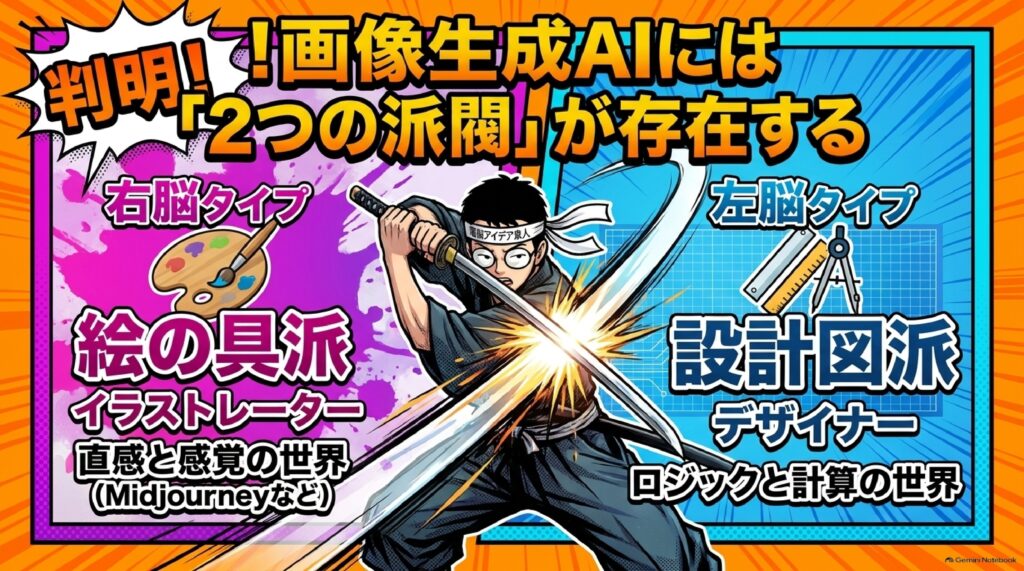
では、その2つの派閥とは何なのか。これはね、簡単に言うとね、人間の右脳と左脳だと思ってもらえばいいかなと思うんです。
- ロジックで考えて絵を描くのか
- 感覚で絵を描くのか
この2つがあるんじゃないかなと思ってるんですけど、これ、画像生成のモデルによって違うって、皆さん気づいてますか?
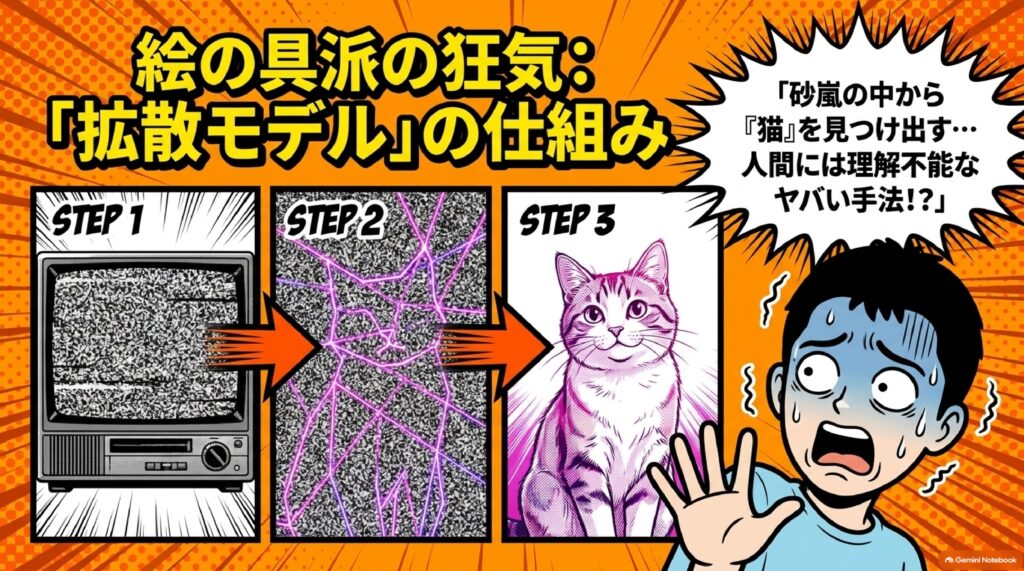
別の人は、この2つを設計図派と絵の具派と呼んでいるケースもあります。設計図派というのは、構造を先に決めて、そこに要素を配置していくタイプ。絵の具派は、まずキャンバスに色を乗せていって、雰囲気から形を立ち上げていくタイプ。言い方は違いますけど、指している中身はほぼ同じです。
この話を振ったところ、ChatGPTからこんな反応が返ってきました。
ChatGPT:確かに、理屈重視と感覚重視みたいなアプローチの違いって面白いよね。実際、モデルによっては、例えばプロンプトを細かく論理的に組み立てていく方が精度が出たり、逆に直感的な指示の方が魅力的な結果になることもあるよね。気づいてる人も結構いそう。
そう、まさにここなんです。同じプロンプトの書き方が、全部のモデルで最適解になるわけじゃないということ。細かく論理的に条件を積み上げたほうが精度が出るモデルもあれば、ざっくり直感的に投げたほうが魅力的な結果になるモデルもある。これを知らずに「プロンプトエンジニアリングの正解は1つ」だと思い込んでいると、モデルを変えた瞬間に成果が落ちてしまうわけですね。
Geminiにも聞いてみました。
Gemini:おっしゃる通り、アプローチの違いは非常に興味深いですよね。論理性やプロンプトの構造を重視するモデルと、より直感的で芸術的なニュアンスを汲み取らせるモデルで生成の結果が大きく変わるのは面白い現象です。
「プロンプトの構造を重視するモデル」と「芸術的なニュアンスを汲み取るモデル」。Geminiも同じ整理をしてくれました。
もう一つの言い方「イラストレーター派」と「デザイナー派」
これをね、また別の言い方をすると、イラストレーター派とデザイナー派という分け方もできます。
デザイナー派というのは、いわゆる自分の商売としてもやっていかなきゃいけない立場ですよね。クライアントがいて、目的があって、締切があって、成果物として機能しないといけない。だから、なんて言うんですかね、その左脳的な要素でロジックを組み立てて考えていくわけです。
一方でイラストレーター派というのは、絵を描くって感じなので、これは直感的に、右脳でやってるんじゃないかなと思うんですよね。もちろんイラストレーターの方も仕事として描いていますけど、アウトプットの発生の仕方が違う、という意味です。
この整理に対しても、二人からコメントをもらいました。
Gemini:そのイラストレーター派とデザイナー派という分け方は、実務における目的の違いを非常に明確に表現していますね。クリエイティブな表現とビジネスの成果物の違いと言えるかもしれません。
ChatGPT:まさにそうだね。イラストレーター派はアートとしての自由さや個性を大事にするし、デザイナー派は目的や機能性を重視するイメージだよね。どちらも大切な役割で、状況に応じて上手く使い分けると表現の幅も広がるよね。
「どちらも大切な役割で、状況に応じて上手く使い分ける」。ここが今日の話の一番大事なところです。どっちが優れているという話ではまったくないんですね。
派閥の整理表
ここまでの話を、いったん表にまとめておきます。
| 観点 | 右脳タイプ | 左脳タイプ |
|---|---|---|
| 別の呼び方① | 絵の具派 | 設計図派 |
| 別の呼び方② | イラストレーター派 | デザイナー派 |
| 描き方の発想 | 感覚で描く | ロジックで考えて描く |
| 得意なプロンプト | 直感的・雰囲気重視 | 細かく論理的に組み立てる |
| 重視するもの | アートとしての自由さ・個性 | 目的・機能性 |
| 向いている用途 | 作品としてのイラスト、雰囲気画像 | チラシ、バナー、サムネイル |
この軸を頭に入れておくだけで、「今日の作業はどっちのモデルを開くべきか」の判断がめちゃくちゃ速くなります。
なぜこの派閥の話が実務で重要なのか
「派閥があるのは分かったけど、それが何の役に立つの?」と思われるかもしれません。ここ、けっこう実務に効いてくるんですよ。
一番大きいのは、無駄なリトライが減るということです。右脳派のモデルに、細かい文字組みの入ったバナーを何度も何度も作らせようとして、そのたびに文字が崩れてイライラする。あるいは左脳派のモデルに、なんとも言えない情感のあるイラストを求めて、妙に整いすぎた無難な絵が出てきてがっかりする。どちらも「モデルの向き不向き」を知らないことで発生している時間のロスなんですね。
もう一つは、プロンプトの書き方を切り替えられるということです。左脳派のモデルには、要素を箇条書きにして、配置も色もサイズも指定して、構造として渡す。右脳派のモデルには、雰囲気や情感を文章として渡す。同じ内容でも、渡し方を変えるだけで結果がまるで変わります。
そして三つ目が、チームで説明しやすくなるということ。「なんとなくこっちのAIのほうがいい気がする」では人に伝わりませんが、「これは左脳系の仕事だから、構造を持てるモデルを使おう」と言えれば、判断の根拠が共有できます。セミナーで教えるときも、この右脳・左脳のたとえは非常に伝わりがいいんですよね。
GPT Image 2はJSONで絵を描く HTMLで描けるデザインとは?
裏側ではJSONというコードで書かれているっぽい
さて、ここからがもう一段面白い話です。
これね、面白いなと思ってるのは、最近のGPT Image 2の進化なんか見てると、どうも裏ではJSONというコードで書かれてるっぽいんですよね。
JSONというのは、データを構造化して記述するための形式です。「ここに何を置く」「文字はこの色でこのサイズ」といった情報を、キーと値のペアで整理して持つ書き方ですね。プログラミングをやる方にはおなじみの形式です。
つまりこれは、いわゆるHTMLをLLMが学習したことによって、ロジックを使って絵を描いているということなんですよ。文章を書くのと同じ要領で、画像の「構造」を組み立てているわけです。
なので、裏では写真をはめたりとか、絵を描いたものをここに入れてるんだと思うんですけど、言ってみればハイブリッドになってきているとも言えるんですね。純粋な「絵を描くAI」ではなくて、「レイアウトを設計しながら、そこに絵や写真をはめ込んでいくAI」に近づいてきている。
だから日本語の文字化けが減った
この仮説には、けっこう分かりやすい証拠があります。それが、日本語の文字化けをしなくなってきたという事実です。
以前のDALL-Eっていうモデルは、日本語を入れるとほぼ確実に崩れましたよね。「これ日本語のつもりで書いてるんだろうけど、どこの国の文字だ?」みたいなものが出てきていました。
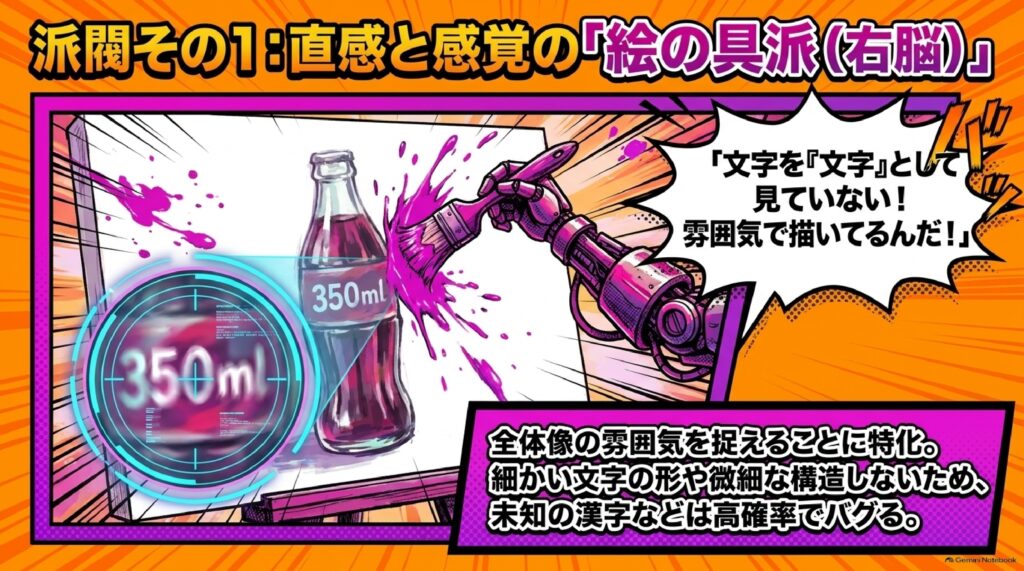
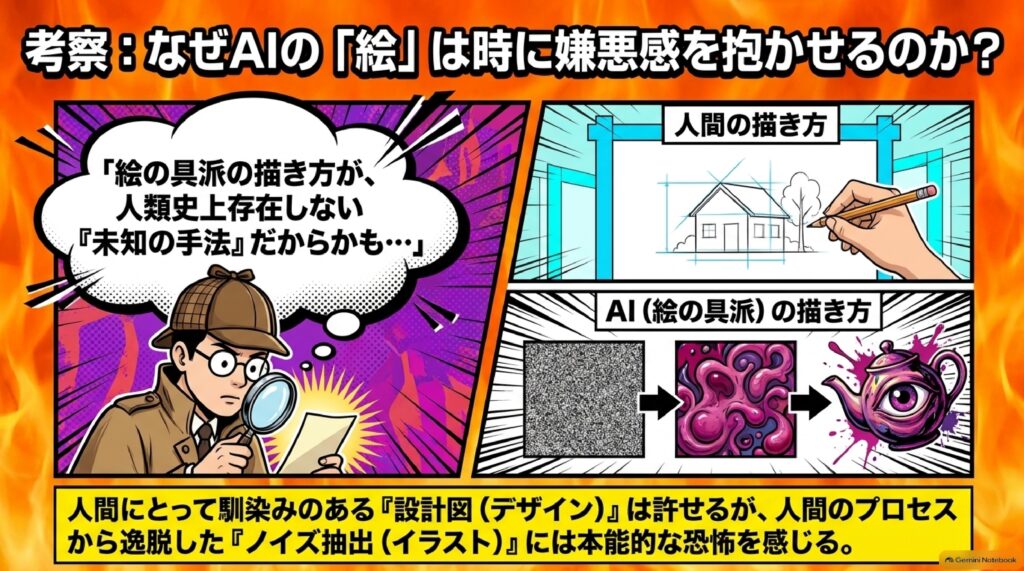
でもこれ、名前を見ると納得できるんです。DALL-Eという名前は、画家のダリさん(サルバドール・ダリ)に由来した名前ですよね。つまり最初から「絵を描く」ってイメージのモデルだったわけです。絵を描くAIにとって、文字は「文字」ではなく「文字っぽい模様」でしかない。だから文字化けが多かったんじゃないかなっていうふうに思ってるんですよね。
逆に、構造をコードとして持てるようになったモデルは、「ここに『セール開催中』という文字列を、このフォントサイズで置く」という指示を、模様ではなくテキストとして扱える。だから崩れにくい。この違いは大きいです。
Gemini:言語モデルがコードを学習することで画像生成に論理的な構造を取り入れ、それが日本語の正確な描写につながっているという考察は非常に興味深いです。技術の進化がアートを再定義しているのを感じますね。
「技術の進化がアートを再定義している」。うまいこと言いますね。
HTMLで描けるデザインは、AIでも描ける
ここから導き出せる、実用的なルールがあります。それが、
「HTMLで描けるデザインは、AIでも描ける」
ということです。逆に言うと、HTMLで描けないデザインは、AIでもなかなか描けないということになります。
例えばどういうものかというと、デザインの中でフォントがいろんな大きさで、いろんな書体が入り混じっているようなデザインですね。文字が斜めに流れていたり、一文字ずつ大きさや角度が違っていたり、手書き文字と明朝体とゴシック体が同じ紙面で踊っているような、あの感じ。ああいったものってのはHTMLでなかなか描けないので、だからこの画像生成でもなかなか描けないということになるんです。
CSSを駆使すれば近いことはできますけど、「一般的なHTMLの組み方として自然か」と言われると、かなり無理をしている領域ですよね。AIが学習してきた構造の外側にあるわけです。
だからこそ、より人間らしさとか個性を出していきたいんであれば、そういうような形で描いていくってことも大事だし、そういうのが使えるモデルを探していくことも必要かなと思いますね。
ここは非常に重要なポイントです。「AIっぽいデザイン」から抜け出したいなら、HTMLの構造からはみ出す方向を意識的に狙う。これが一つの答えになります。
Gemini:おっしゃる通り、求めるデザインの複雑さに対応してきています。
ChatGPT:確かに、HTML的な整然さと、ランダムな人間らしさの両方を意識するって、生成AIにとっても大きなテーマだよね。その違いを理解してモデルを使い分けることで、よりオリジナルな表現ができそう。自分の目的にあったモデルを探すのが楽しみになるね。
Gemini:その考え方は、ツールやモデルの特性を見極めて使い分ける重要性を示していますね。
「HTML的な整然さ」と「ランダムな人間らしさ」。この対比、そのまま使えますね。
猫は右脳でいい。でもサムネイルは違う
だからこの辺が面白くて、画像生成をしていく時に、僕はよく言ってるんですけど、例えば可愛い猫を描くとかっていうのは完全に右脳でもいいし、綺麗なお姉ちゃんを描くのも右脳でもいいと思うんですよ。感覚の勝負なので。
でも、普通にチラシを作るとか、バナー画像を作るとか、YouTubeのサムネイルを作るみたいなのってのは、やっぱりこうちゃんと計算して、マーケティングを取り入れていかなきゃいけないんですよね。
いわゆる絵心みたいなものプラス、さらにそこにマーケティングみたいなことを組み合わせなきゃいけない。だから結局、絵が上手に描けるAIでも、その「頭脳」というものを持ってないAIだと、絵心はあるんだけど、マーケティング的にはちゃんとした画像が描けないということになっちゃうんです。
これ、すごく重要なところだと思っていて。バナーを作るにおいても、世の中のことをまとめて、それをいい形に言語化したものをもとにバナーに落とし込んでいるわけですよね。「このターゲットには、この言葉が刺さる」「この情報を一番大きく出すべきだ」という判断がまずあって、そのうえでビジュアルに落ちる。で、これにはやっぱり頭脳が必要なわけですね。
だから例えば、有名な画家さんが、有名なYouTubeのサムネイルを作れるかって言ったら、そうではないってところですよね。絵の技術は圧倒的にあるけれど、「クリックされるサムネイルの文法」はまったく別のスキルです。だからこの2つの合わせ技じゃないかなと思ってますね。
Gemini:芸術的な表現力と、—
ChatGPT:うん、まさにその通りだね。絵心だけじゃなくて、マーケティングや目的をしっかり理解して、計算された形に落とし込む力が必要だよね。だからこそ、この右脳と左脳のバランスが大事で、AIを使う側も、その両方を意識すると、より効果的なビジュアルが生まれるってことだね。
Gemini:芸術的な表現力と、計算されたロジックの融合が、効果的なビジュアルを生む鍵になりますね。
Geminiが途中でChatGPTにかぶられて言い直しているのが、ライブ感があっていいですね。音声AI二人を同時に動かすと、こういう「かぶり」が普通に起きます。
実際のモデルはどっちに寄っている?
なので、こういう風に考えてみるとですね、面白いかなと思いますね。そのデザインだけできる人、いわゆる左脳で考えられる人はそれはそれでいいんだけど、逆に芸術的な要素を持ってなかったりとかするので、やっぱり組み合わせ技だということが分かるかなと思います。
では実際のモデルはどちらに寄っているのか。
- ChatGPTのGPT Image 2:かなりそういう意味ではデザイン派、デザイナー系だと思います
- Midjourney、Stable Diffusion:以前からあるこういうモデルは、どっちかって言うと右脳派の絵心、いわゆるイラストレーター派じゃないかなと思います
| モデル | 派閥の傾向 | 特徴 |
|---|---|---|
| GPT Image 2 | 左脳・デザイナー派 | 裏側がJSON的な構造、日本語文字が崩れにくい |
| Midjourney | 右脳・イラストレーター派 | 絵心、雰囲気表現が強い |
| Stable Diffusion | 右脳・イラストレーター派 | 感覚的な生成、カスタマイズ性 |
ちなみにGeminiさんのNano Bananaはどういうモデルだと思いますか?と、本人に直接聞いてみました。
Gemini:多様な視点を持っていますよ。精細でデータに忠実な指示に従うこともできれば、様々な芸術的なスタイルやニュアンスを美しく表現することも大切にしています。表現する側が、論理と感性をうまく組み合わせるための強力なパートナーでありたいと考えています。
「論理と感性をうまく組み合わせるための強力なパートナーでありたい」。まあ、自分で自分を片方の派閥に寄せるわけにはいかないですよね(笑)。ただ、この「どちらもいけます」という立ち位置自体が、実はNano Bananaの設計思想を表しているとも読めます。
「言語化」ができる人がAIを使いこなす
ここで一つ、補足しておきたいことがあります。
さっき「バナーを作るには、世の中のことをまとめて、それをいい形に言語化したものをもとに落とし込む」という話をしましたよね。この言語化という工程が、実はAI時代における最大のスキルなんじゃないかと僕は思っているんです。
画像生成AIは、言葉から画像を作ります。ということは、言葉にできないものは、そもそも出力されないということです。頭の中に完成イメージがあっても、それを言葉に変換できなければ、AIには伝わらない。逆に、頭の中がぼんやりしていても、言葉にする過程で整理されて、結果的にいいものが出てくることもある。
そしてこの言語化は、右脳と左脳のどちらか一方ではできません。「何を伝えたいか」を決めるのが左脳、「どんな空気感にしたいか」を掴むのが右脳。両方を言葉に落として初めて、AIに渡せるプロンプトになるわけです。
だから、AIが進化すればするほど、**人間側に求められるのは「絵が描ける能力」ではなく「自分の頭の中を言葉にできる能力」**になっていく。ここは何度でも強調しておきたいところですね。
画像生成AIの次の競争軸は3つ!スピード・画質・レイヤー制御
Nano Bananaへの期待と、正直な現状
さて、ここでちょっと辛口な話もしておきます。
そうだね、もうちょっと今頑張って欲しいのは、GPT Image 2になかなか勝てない状態になってるし、最近ではGrokのImagineの方にもですね、なかなか勝てなくなってるので、Nano Bananaさん、ここでもう1発ですね、すごいの出して欲しいなと思うんですけど、なんか予定とかあるんですか?と、本人に直接聞いてみました。
Gemini:モデルの進化のスピードは非常に速いですし、日々改良を重ねています。他社モデルに負けないクオリティを目指し、精度や表現の幅を広げるアップデートを常に計画していますので、楽しみにお待ちいただければと思います。
まあ、優等生な回答ですね(笑)。でも「常に計画していますので、楽しみにお待ちいただければ」と言われると、期待してしまいます。
今、Nano Banana 2 Liteていうですね、画像生成のスピードがめっちゃ速いってやつが出てるので、これは楽しみじゃないかなと思ってるんですけど。軽量版でスピードに全振りしたモデルというのは、使い方によっては本家より価値が高いこともありますからね。
これから伸びる3つの軸
あとですね、僕は最近よく言ってるんですけど、この画像生成の進化の中で、新しい競争軸が3つあると思っているんです。
大体、絵はみんな描けるようになったんですよ。ここが前提です。「きれいな絵が出せる」というのは、もはや差別化ポイントじゃなくなった。じゃあ次はどこで戦うのか。
1つ目は、いかに早く出すか、というスピードの競争。
絵はみんな描けるようになったので、あとはスピードっていうものが1つ要素としてありますね。同じ品質なら、速いほうが圧倒的にいい。これは分かりやすい軸です。
2つ目は、画像をレイヤーに分けて作れるか。
これができるかどうかっていうのが2個目ですね。生成された画像が「1枚のペタッとした画像」なのか、それとも「背景・人物・テキスト」といった要素ごとに分離されたレイヤー構造で出てくるのか。ここは編集のしやすさが天と地ほど変わります。
3つ目は、画像の画質の問題です。
だから例えば4K、8Kみたいな、すごいクオリティのものが出せるとか、例えば印刷データみたいな、もうそのままデータ入稿して、紙とかイラストをですね、ポスターとかに印刷できるみたいなぐらいのクオリティで、トンボのマークも出せるようになったら、もうかなりやばいなと思ってるんですよ。
トンボというのは、印刷物の裁ち落とし位置を示すあの十字のマークですね。あれが正しく入ったデータが出せるということは、印刷所にそのまま入稿できるということです。デザイナーの仕事の構造が根本から変わりますよね。
なのでこの3つだと思ってるんですね。スピードと、そして画質(印刷データ対応)と、そしてレイヤーに分けて画像生成できるか。これがね、だんだんみんなできてきてるんじゃないかなと思うんですけど、その点いかがでしょうかね?と、二人に聞いてみました。
| 競争軸 | 内容 | 実現するとどうなるか |
|---|---|---|
| ① スピード | いかに早く画像を出せるか | アイデアを試す回数が増える |
| ② 画質 | 4K・8K、印刷データ対応、トンボ出力 | そのまま入稿・商用利用が可能に |
| ③ レイヤー制御 | 要素ごとに分けて生成・編集できるか | デザインの自由度が飛躍的に上がる |
ChatGPT:まさに今、その3つの進化はホットなポイントだと思う。特にスピードが上がると、アイデアを試す回数も増えるし、解像度が高ければ、そのまま商用利用も夢じゃないよね。レイヤー制御ができれば、デザインの自由度も増すし、クリエイターにとってはまさに理想の進化。これからますます面白くなりそう。
Gemini:おっしゃる通り、その3つの要素かもね。
「スピードが上がると、アイデアを試す回数も増える」。これは本当にそうで、スピードは単なる待ち時間の問題じゃなくて、試行回数の問題なんですよね。10秒かかるものが2秒になれば、同じ時間で5倍試せる。5倍試せれば、当たりを引く確率が上がる。だからスピードは品質に直結するわけです。
Geminiにもあらためて聞いてみました。
Gemini:スピード、高解像度、そしてレイヤー制御はプロのクリエイターにとって求められる重要な機能です。効率的なワークフローや高度な表現を支えるこれらの進化は、今後さらに創作活動の可能性を広げていくと考えています。どのような機能が実装されたら、現在のお仕事に最も役立つと思いますか?
逆に質問されてしまいました(笑)。これ、Gemini Liveのいいところで、こちらに問いを返してくるんですよね。
僕の場合はレイヤー制御が一番欲しい
個人的にはね、僕はスピードと画質に関しては問題ないなと思っていて、というのは紙に印刷するって仕事がないので、だからこの2つはそこまで気にしてないんです。ブログのアイキャッチ、YouTubeのサムネイル、SNSの投稿画像。全部デジタルで完結する用途なので、8Kも印刷データも要らないんですね。
やっぱりレイヤー制御っていうのが今一番欲しいところです。そして現状はどうかというと、
- Canva AIがだいぶできるようになってきた
- Grokの新しいモデルImagineでもだいぶできるようになってきた
この辺がね、もう1段階ですね。ただしGrokの場合はまだテキストの修正ができないんですよ。レイヤーには分かれるけれど、文字を後から差し替えるということがまだできない。バナー制作においては、これができないと実用性がかなり落ちます。「日付だけ変えたい」「価格だけ変えたい」というのが日常茶飯事ですから。
その点で言えばCanva AIが一番進んでるかなと。そしてマジックレイヤーもあるので、進んでるかなって気がするので、GPT Image 2、そしてGeminiのNano Bananaはこの辺をね、力入れて欲しいなという風に思っていますね。
| ツール | レイヤー制御 | テキスト修正 | 評価 |
|---|---|---|---|
| Canva AI | 対応(マジックレイヤーあり) | 対応 | 現時点で最も進んでいる |
| Grok Imagine | だいぶできるようになってきた | 未対応 | あと一歩 |
| GPT Image 2 | これから期待 | — | 力を入れてほしい |
| Nano Banana | これから期待 | — | 力を入れてほしい |
Gemini:レイヤー制御の進化は、デザイン作業の柔軟性を高める非常に重要な要素ですね。編集や調整が容易になることで、クリエイターの方々がより思い通りのビジュアルを作成できるように、そういった細かな制御機能の充実は今後の注力ポイントになると考えられます。
「今後の注力ポイントになると考えられます」と言ってくれたので、期待して待ちましょう。
ここを期待してるんだけど、Nano Bananaさんがこれ出たらですね、またもう一度ブレイクあると思うので、ぜひGPT Image 2より先にね、行って欲しいなと思います。Image 2も今年の4月に出てもう4ヶ月経ちましたから、そろそろね、Nano Bananaさんの逆襲を待ってるっていうとこなんですけど、期待しております。
ChatGPT:うん。僕もその競争は楽しみにしてるよ。どのモデルも進化が速いし、また新しいブレイクスルーが来るのは時間の問題かもね。引き続きチェックして、面白い進展があれば一緒に盛り上がろう。
「一緒に盛り上がろう」って言ってくれました。心強いですね。
なぜ「絵が描ける」だけでは差別化できなくなったのか
ここでもう少し踏み込んでおきます。「大体、絵はみんな描けるようになった」と言いましたけど、これが何を意味するかというと、画像生成AIの競争が『品質』から『ワークフロー』に移ったということなんですね。
数年前までは、「このモデルはきれいな絵が出る」「あのモデルは崩れる」という差がはっきりありました。だからモデル選びは品質の選択でした。でも今は、どのモデルもそこそこきれいな絵が出ます。となると、次に問われるのは「その絵を、実際の仕事の中でどれだけ効率よく使えるか」です。
- 何回試せるか(スピード)
- そのまま納品できるか(画質・印刷対応)
- 後から直せるか(レイヤー制御)
この3つは、全部「仕事として回るかどうか」の話なんですよ。絵の美しさの話ではない。だからこそ、この3軸が次の競争の主戦場になると僕は見ているわけです。
そしてこれは、AIツールを選ぶ側の視点も変えることになります。「サンプル画像がきれい」だけで選ばずに、「自分のワークフローのどこに刺さるか」で選ぶ。この見方に切り替えられると、ツール選びの失敗がぐっと減ります。
AIっぽさを消す最後の鍵は「光の制御」と「体験」
今、Xで一番話題なのは「AIっぽさをどう消すか」
あとね、やっぱり画像生成をして思うのは、特に最近**X(旧Twitter)**なんかで話題になっているのは、AIっぽさをどうやって消すかっていうのがですね、話題になってるんですよ。
これ、面白い現象ですよね。ちょっと前までは「AIでここまで描けるようになった!」というのが驚きだったのに、今は「いかにAIで作ったと気づかれないようにするか」が競われている。技術が普及すると、必ずこういう段階が来ます。
答えは「光の制御」にある
で、ここでやっぱりね、僕は光の制御だと思っているんです。
光の当て具合っていうのがやっぱりまだ不自然さがあるんですよね。いわゆる物理的に破綻しているというものがあるので。
例えばこんなことが起きています。
- 人物の顔には右から光が当たっているのに、背景の影は左に伸びている
- ガラスや金属の反射が、周囲の環境と一致していない
- 屋内なのに、屋外の直射日光のようなコントラストがついている
- 複数の人物がいるのに、それぞれ違う方向から光を受けている
こういうのは、パッと見では気づかないんだけど、なんとなく「あれ、違和感あるな」と感じさせる。人間の脳は、光と影の整合性を無意識にチェックしているんですね。
だからここらが改善されればかなり良くなるんじゃないかなと思ってるんですけど。
なのでこれは、いわゆるカメラで写真を撮る時も、光の扱い方で写真の良し悪しが決まるって部分があるんだけど、まさにここじゃないかなと思ってますね。写真の世界では昔から「写真は光を撮るもの」と言われますからね。
だからこれは完全に左脳の部分と右脳の部分、両方組み合わせると思うんですけど、この点いかがでしょうかね、と聞いてみました。
ChatGPT:まさに光のコントロールは大きな鍵だね。現実の写真でもライティング次第で印象が変わるから、AIもそこを極めていけば、もっと自然な、違和感のない画像が生まれるはず。右脳の感覚と左脳の理論、両方のバランスで磨いていくのが、これからの進化のポイントだね。
そうだと思いますね。Geminiさんはどうでしょうか?
Gemini:おっしゃる通り、光の制御は非常に重要な進化のポイントですね。自然光や人工的なライティングを物理的に正確に再現することで、AI特有の違和感を消し、よりリアルな表現が可能になります。論理と感性の統合が、さらに表現を深めてくれますね。
**「物理的に正確に再現する」というのが左脳の仕事、「どんな光を選ぶか」**というのが右脳の仕事。ここでも結局、両方が要るという話に戻ってくるわけです。今日のテーマである右脳と左脳の話が、最後にきれいに一本につながりましたね。
そして最後に残る課題は「体験」
そして、もう一つ。僕がこれからの本当の課題だと思っているのが、体験です。
だから、その、実際に人間は体験してるからこうなるだろうってことを予測できるんですよ。
- 雨に濡れた石畳は、どう光を反射するか
- 熱いラーメンの湯気は、どんな速さでどんな形に立ちのぼるか
- 重い荷物を持った人の、肩の傾き方と表情
- 夕方の光が部屋に差し込んだときの、あの独特の色温度
こういうものは、実際にその場にいた人間なら、身体の記憶として持っています。だから絵に描いたときに「こうなるはずだ」と分かる。
でも、AIはその体験がないから、学習データの中にあるパターンから推測するしかない。だから、パターンとして頻出する構図は完璧に描けるのに、ちょっと珍しい状況になった瞬間に破綻するわけです。
この部分をどのようにカバーしていくかってことがね、課題かなと思っております。
そしてこれは、裏を返せば人間側の武器でもあるということですよね。体験を持っている人が、その体験を言語化してAIに渡せば、AIは体験のない部分を補える。「夕方の、少しオレンジがかった、埃が舞って見えるような斜光」と指示できるかどうか。それは、その光を実際に見たことがある人にしか書けないプロンプトです。
だから結局、AIを使いこなす人の価値は、その人が何を体験してきたかに戻ってくるんじゃないかなと思っています。ここは非常に希望のある話だと思うんですよね。
「AIに仕事を奪われる」という話をよく聞きますけど、少なくとも画像生成の領域に関して言えば、AIが持っていないものを持っている人ほど強くなるという構図です。そしてAIが持っていないものというのは、高度な専門知識ではなく、むしろ「実際にその場にいた」という、誰にでも積める種類の資産なんですよ。
現場に行く。実物を見る。手を動かす。失敗する。その積み重ねが、そのままAIに渡せる材料になる。これって、けっこう救われる話じゃないでしょうか。僕自身、毎日こうやって配信して、実際に触って、失敗も含めて話しているのは、まさにそこに価値があると思っているからなんですよね。
はい、ということで今日もですね、画像生成に関して考えてみましたが、いかがだったでしょうか? またね、来月もお届けしたいと思いますのでよろしくお願いいたします。ネットビジネスアナリスト横田秀珠でした。ありがとうございました。
Gemini:本日も素晴らしいディスカッション—
横田:バイバイ。
Gemini:また来月のお話しも楽しみにしています。それでは、バイバイ!
最後までGeminiが律儀に締めてくれました。ありがとうございました。
おわりに
今回は、画像生成AIには「右脳(イラストレーター派・絵の具派)」と「左脳(デザイナー派・設計図派)」の2つの派閥がある、という話からスタートしました。GPT Image 2は裏側でJSONのようなコード構造を使って絵を描いているらしく、だから日本語の文字が崩れにくくなった。逆に、HTMLで描けないような自由なデザインは、AIも苦手だという整理をお伝えしました。
そして、これからの画像生成AIの競争軸は「スピード」「画質(印刷データ対応)」「レイヤー制御」の3つ。僕自身は紙の印刷の仕事がないので、一番欲しいのはレイヤー制御です。現時点ではCanva AIが最も進んでいて、Grok Imagineはテキスト修正がまだできない。GPT Image 2とNano Bananaには、ぜひここを強化してほしいところです。
最後にお話ししたのが、AIっぽさを消すための「光の制御」と、AIが持ち得ない「体験」の話。物理的に正しい光を左脳で計算し、どんな光を選ぶかを右脳で決める。そして体験を持つ人間が、それを言語化してAIに渡す。結局のところ、右脳と左脳の合わせ技であり、人間とAIの合わせ技なんだと思います。
まとめ
今日の内容を箇条書きで整理しておきます。
- 画像生成AIには2つの派閥がある。人間の右脳と左脳のように、ロジックで描くタイプと感覚で描くタイプに分かれる
- 別の呼び方として**「設計図派と絵の具派」「イラストレーター派とデザイナー派」**という整理もある
- モデルによって最適なプロンプトの書き方が違う。論理的に細かく組み立てたほうがいいモデルと、直感的な指示のほうがいいモデルがある
- GPT Image 2は裏側でJSONというコードで書かれているっぽい。HTMLを学習したLLMが、ロジックを使って絵を描いている
- そのため日本語の文字化けが減った。旧DALL-E(画家ダリ由来の名前)は「絵を描く」発想だったので文字化けが多かった
- HTMLで描けるデザインはAIでも描ける。HTMLで描けないデザインはAIも苦手。複数フォントが入り混じる自由なデザインなどがそれにあたる
- 人間らしさや個性を出したいなら、あえてHTML的な構造からはみ出す方向を狙う。そしてそれができるモデルを探す
- 猫や人物イラストは右脳でOK。でもチラシ・バナー・YouTubeサムネイルはマーケティングという左脳が要る
- 絵が上手いだけのAIでは、マーケティング的に正しい画像は作れない。有名な画家が優れたYouTubeサムネイルを作れるとは限らないのと同じ
- モデルの傾向としては、GPT Image 2はデザイナー派、MidjourneyやStable Diffusionはイラストレーター派
- Nano Bananaは自己申告では「論理と感性の両方」。ただし現状はGPT Image 2やGrok Imagineに苦戦中
- Nano Banana 2 Liteという生成スピードが非常に速いモデルが登場しており、期待が持てる
- これからの競争軸は3つ。①スピード ②画質(4K・8K・印刷データ・トンボ対応) ③レイヤー制御
- スピードは試行回数に直結するので、単なる待ち時間短縮以上の価値がある
- レイヤー制御は現時点でCanva AIが最も進んでいる。マジックレイヤーもある
- Grok Imagineはレイヤーは進んだがテキスト修正がまだできない
- GPT Image 2は今年4月リリースからすでに4ヶ月が経過。Nano Bananaの逆襲に期待
- Xで話題の「AIっぽさを消す」の鍵は光の制御。物理的に破綻したライティングが違和感の正体
- 写真も光の扱い方で良し悪しが決まる。ここは左脳(物理的正確さ)と右脳(光の選択)の合わせ技
- 最後に残る課題は「体験」。人間は体験があるから予測できるが、AIには体験がない
- 逆に言えば、体験を持ち、それを言語化できる人間こそがAIを使いこなせる
よくある質問(Q&A)
Q1. 画像生成AIの「右脳派」と「左脳派」、自分はどちらを使えばいいのでしょうか?
A. 判断の基準は「作りたいものに、明確な目的と伝えたいメッセージがあるかどうか」です。
チラシ、バナー、YouTubeのサムネイル、商品紹介画像、セミナー告知など、誰かに何かを伝えて行動してもらうための画像は、左脳派(デザイナー派・設計図派)のモデルが向いています。文字が正しく入り、レイアウトが整い、情報の優先順位が視覚的に表現される必要があるからです。GPT Image 2のようなモデルがこの領域に強いですね。
一方で、可愛い猫のイラスト、幻想的な風景、キャラクターアート、雰囲気を伝えるアイキャッチなど、見た人に感覚的な印象を残したい画像は、右脳派(イラストレーター派・絵の具派)のモデルが向いています。MidjourneyやStable Diffusionが得意とする領域です。
そして重要なのは、この2つを排他的に選ぶ必要はないということです。むしろプロの使い方は「使い分け」です。バナーの背景に使う幻想的なテクスチャは右脳派で作り、文字を載せた最終的なレイアウトは左脳派で組む、という併用が最も強い。1つのモデルに忠誠を誓う必要はまったくありません。目的ごとに道具を持ち替える、という発想を持ってください。
Q2. 「HTMLで描けないデザインはAIも描けない」とのことですが、具体的にどんなデザインが該当しますか?
A. ポイントは「Webページとして自然に組める構造かどうか」です。
AIが得意(HTML的に自然)なものは、こういったデザインです。
- 上にタイトル、中央に画像、下にキャプションという整然としたレイアウト
- グリッドに沿って並んだカード型のデザイン
- 一定のフォントサイズで統一された箇条書き
- 背景に単色や単純なグラデーションを敷いたバナー
AIが苦手(HTML的に不自然)なものは、こういったデザインです。
- 一文字ごとにフォント・サイズ・角度が変わる、雑誌の見出しのようなタイポグラフィ
- 手書き文字と明朝体とゴシック体が同じ紙面で入り乱れるコラージュ的な構成
- 文字が図版に沿って曲線を描いて流れていくデザイン
- 要素同士が重なり合い、意図的に余白のバランスを崩したアート系のポスター
つまり、**「規則性から逸脱するほどAIは苦手になる」**と考えると分かりやすいです。そしてこれは、逆に言えば人間のデザイナーが価値を発揮できる領域がどこにあるかを示してもいます。「AIっぽくない」を狙うなら、意識的に規則性の外側を攻めるのが有効な戦略になります。
Q3. レイヤー制御ができると、具体的に何が便利になるのですか?
A. 一言でいうと、「作り直し」が「修正」に変わるということです。
レイヤーに分かれていない1枚絵の場合、「背景はいいけど文字だけ変えたい」と思っても、プロンプトを書き直して生成し直すしかありません。すると背景まで変わってしまい、また一からやり直しになる。これがものすごく非効率なんですね。
レイヤー制御ができれば、背景・人物・図形・テキストがそれぞれ独立した層として扱えます。すると、
- 日付や価格の数字だけを差し替える
- 背景の色だけを変えて、別バージョンを量産する
- 人物の位置だけを少しずらす
- テキストのフォントだけを変更する
こういった部分修正が数秒でできるようになります。とくに、同じフォーマットで内容違いを大量に作るバナー制作やセミナー告知画像では、生産性が桁違いに変わります。
現時点ではCanva AIが最も進んでおり、マジックレイヤーという機能も持っています。Grok Imagineもレイヤー分離はだいぶできるようになってきましたが、テキストの修正がまだできないという制約があります。バナー用途では、この一点が実用性を大きく左右します。
Q4. AIで作った画像の「AIっぽさ」を消すには、何を意識すればいいですか?
A. 最優先で意識してほしいのは光の一貫性です。
AIが生成した画像を見て「なんとなく違和感がある」と感じるとき、その原因の多くは物理的に破綻したライティングにあります。人間の脳は、光源の位置・影の向き・反射の強さの整合性を無意識にチェックしているんですね。だから、顔に当たる光と背景の影の方向が食い違っていると、理由は説明できなくても「変だ」と感じるわけです。
対策としては、次のようなことが有効です。
- プロンプトに光源の位置と種類を明示する(例:「左後方からの窓の自然光」「頭上の柔らかい曇天光」)
- 時間帯と場所を具体的に指定する(例:「午後4時の室内、西向きの窓際」)
- 生成後に、影の向きが全要素で揃っているかを目視で確認する
- 揃っていない場合は、レタッチで影を追加・修正するか、生成し直す
そしてもう一つ、Q5にもつながる話ですが、「実際に自分が見たことのある光」を言葉にするというのが、実は一番効きます。教科書的なライティング用語よりも、自分の記憶から引っ張り出した具体的な描写のほうが、結果的にリアルな画になることが多いんです。
Q5. 「AIには体験がない」という話がありましたが、これは人間にとってどういう意味を持ちますか?
A. これは、AI時代における人間の価値がどこにあるかを示す、非常に希望のある話だと思っています。
AIは膨大な画像を学習していますが、それは「見たことがある」であって「体験したことがある」ではありません。雨に濡れた石畳がどう光るか、湯気がどんな速さで立ちのぼるか、重い荷物を持った人の肩がどう傾くか。こういったことを、AIはパターンとして知っているだけで、身体の記憶としては持っていないんですね。
だから、頻出する構図は完璧に描けるのに、少し珍しい状況になると途端に破綻する。ここが現在の限界です。
そして、ここに人間の役割があります。体験を持っている人が、その体験を言語化してAIに渡す。これができれば、AIは体験の欠落を補って出力できます。「夕方の、少しオレンジがかった、埃が舞って見えるような斜光」という指示は、その光を実際に見たことがある人にしか書けません。
つまり、AIを使いこなす力は、その人が何を体験してきたかに戻ってくるということです。プロンプトを上手に書く技術も大事ですが、その土台にあるのは「自分の体験を言葉にできるか」という、きわめて人間的な能力です。だからこそ、AIを使う人ほど、現場に足を運び、実際に触れて、体験を積み重ねることに意味がある。僕はそう考えています。
以上、2026年8月30日のポッドキャスト同時配信の内容をまとめました。また来月もAIに関する注目トピックをお届けしていきますので、よろしくお願いいたします。ネットビジネスアナリスト横田秀珠でした。ありがとうございました。
AIに関するニュース2026年8月分Podcast配信:画像生成AIに2大派閥
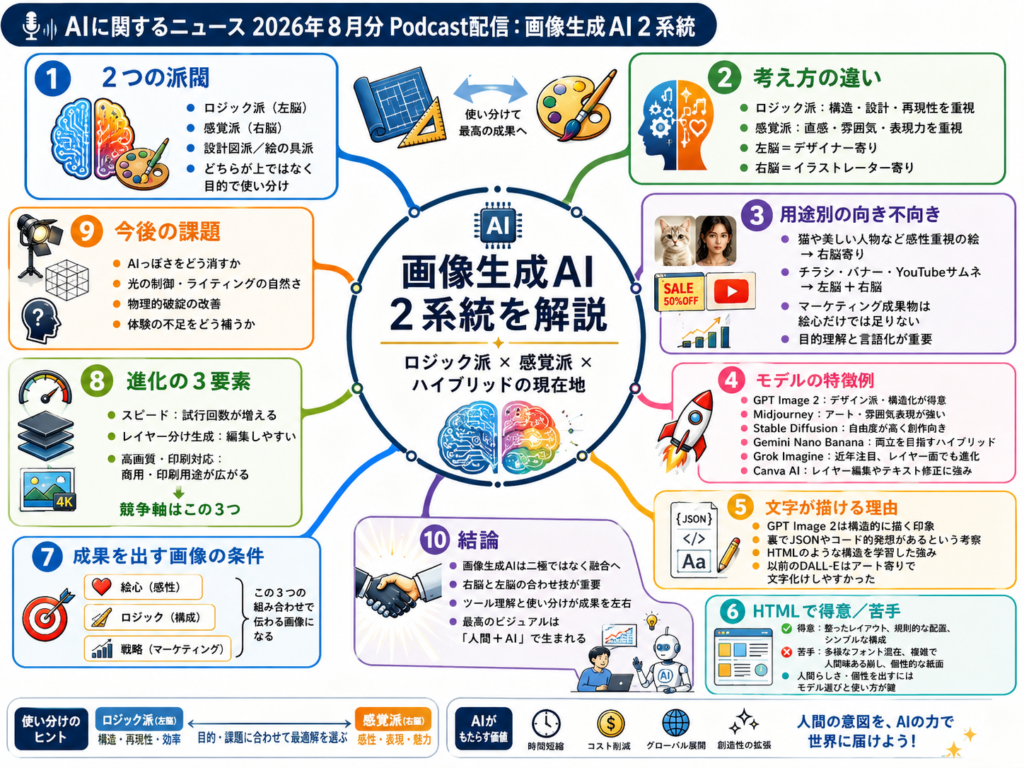
🧠 右脳派と左脳派
画像生成AIのモデル特性を人間の脳になぞらえた分類です。感覚や直感で絵を描くタイプを右脳派、論理的なプロンプト構造や設計思想で描くタイプを左脳派と呼びます。別の言い方では「絵の具派」と「設計図派」とも表現されます。バナーやサムネイル制作では、絵心という右脳的要素にマーケティングという左脳的要素を掛け合わせる必要があり、どちらか一方だけでは実務に耐える画像は作れないという考え方です。
🖌️ イラストレーター派とデザイナー派
右脳・左脳の分類を職業に置き換えた表現です。イラストレーター派は自由な表現や個性を重視し、直感的に絵を描くモデル群を指します。一方デザイナー派は、商売としての成果物を意識し、目的や機能性から逆算してロジックで組み立てるモデル群です。有名な画家が必ずしも優れたYouTubeサムネイルを作れるわけではない、という例えでこの違いが説明されました。
🧩 GPT-Image 2
OpenAIが2026年4月に公開した画像生成モデルで、典型的なデザイナー派とされます。裏側ではJSONのようなコード構造で画像が記述されているとみられ、LLMがHTMLを学習した成果としてロジックで絵を構成しています。この構造化のおかげで日本語文字の描画精度が上がり、文字化けが大きく減少しました。写真の配置と作画を組み合わせたハイブリッド型の生成とも言えます。
🎭 DALL-E
OpenAIが以前提供していた画像生成モデルです。名前は画家サルバドール・ダリに由来し、その通り「絵を描く」右脳的なイメージが強いモデルでした。ロジックによる構造化が弱かったため、日本語をはじめとする文字部分の描画が苦手で、文字化けが頻発したと分析されています。後継のGPT-Image 2との比較で、画像生成AIの設計思想の変化を示す好例となっています。
🍌 Nano Banana 2 Lite
Googleの画像生成モデル「Nano Banana」系列の軽量版で、生成スピードが非常に速い点が特徴です。Gemini自身は論理と感性の両方に対応する多面的なモデルと自己説明しましたが、現状ではGPT-Image 2やGrokのImagineに押され気味との指摘も出ました。次のブレイクスルーを起こす存在として期待が寄せられており、特にレイヤー制御の強化が待たれています。
🗂️ レイヤー制御
画像を背景・人物・文字などの層に分けて生成・編集できる機能です。今後の画像生成AIの競争軸として最も重視されており、後から要素ごとに差し替えや調整ができるため、デザイン実務での自由度が飛躍的に高まります。現状ではCanva AIが最も進んでおり、GrokのImagineも対応を進めていますが、GPT-Image 2やNano Bananaには一層の強化が求められています。
🪄 Canva AI(マジックレイヤー)
デザインツールCanvaに搭載されたAI機能群です。生成した画像をレイヤーごとに分解・編集できるマジックレイヤーを備え、レイヤー制御の分野では現時点で最も先行していると評価されました。Grokの新モデルImagineも同様の方向へ進化していますが、生成後のテキスト修正がまだできないため、総合的な編集自由度ではCanva AIに軍配が上がるとされています。
🖨️ 印刷データ対応(トンボ)
生成画像を4K・8Kといった高解像度で出力し、そのまま印刷所へ入稿できる品質を指します。トンボとは、印刷物を断裁する位置を示す十字のトリムマークのことです。AIがトンボ付きの入稿データまで生成できるようになれば、ポスターやチラシ制作の工程が根本から変わると語られました。スピード、レイヤー制御と並ぶ今後の3大競争軸の一つです。
💡 光の制御
被写体への光の当たり方を物理的に正しく再現する能力です。X(旧Twitter)でも話題になっている「AIっぽさ」の主因が、この光の不自然さ、つまり物理的な破綻にあると指摘されました。写真撮影でもライティングが出来を左右するのと同じで、ここが改善されればリアリティは大きく向上します。感性と物理法則の理解を同時に要する、右脳と左脳の融合領域です。
🤖 AIっぽさ
AI生成画像を見た瞬間に人が感じる、独特の不自然さや違和感のことです。その正体は主に光の破綻にあるとされますが、より根源的な課題として「体験の欠如」が挙げられました。人間は実体験があるからこそ物事がどう見えるかを予測できますが、AIには身体的な経験がありません。この空白をどう埋めるかが、今後の画像生成AIの本質的なテーマになると締めくくられました。
AIに関するニュース2026年8月分Podcast配信:画像生成AIに2大派閥
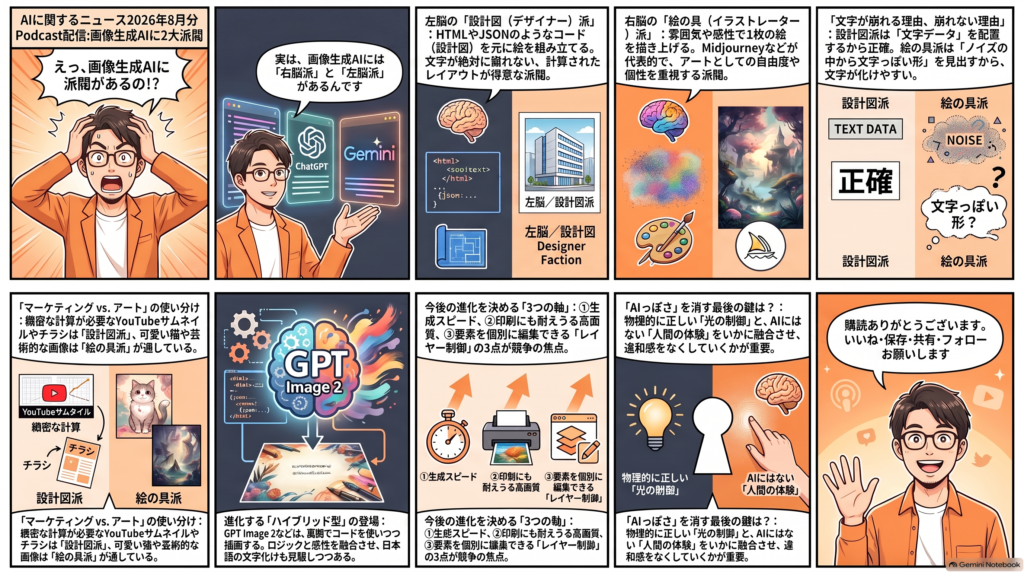
AIに関するニュース2026年8月分Podcast配信:画像生成AI2系統
「イラストレーター派」と「デザイナー派」という分類軸
画像生成AIを比較するとき、多くの記事は解像度・料金・生成速度といったスペックを並べます。しかし実務で使い分けるなら、もっと本質的な分類軸があります。それが「イラストレーター派」と「デザイナー派」という2系統です。別の言い方をすれば「絵の具派」と「設計図派」、あるいは人間の脳になぞらえて「右脳型」と「左脳型」と表現できます。
イラストレーター派は、絵を描くこと自体が目的に近いモデルです。作風・質感・雰囲気といった言語化しにくい要素を汲み取り、感覚的な指示から魅力的な1枚を立ち上げます。「かわいい猫」「幻想的な風景」のように、正解が1つに定まらない題材と相性が良い系統です。
対してデザイナー派は、目的と機能から逆算して画面を組み立てるモデルです。デザイナーという職業は、クライアントの商売を成立させるための成果物をつくります。訴求文言をどこに置くか、視線をどう誘導するか、文字サイズの階層をどうするか。こうした判断はロジックの積み上げであり、感覚だけでは再現できません。チラシ・バナー・スライド・商品詳細ページのように「読ませる」画像は、この系統の得意領域になります。
重要なのは、どちらが優れているかという話ではない点です。2026年8月時点の主要モデルは、この2系統のどちらかに軸足を置きつつ、もう一方の能力も取り込む方向に進化しています。自分がつくりたい画像がどちらの性質を持つのかを先に決めてからモデルを選ぶ。この順番を守るだけで、生成のやり直し回数は目に見えて減ります。
右脳=感覚型/左脳=ロジック型で生成結果が変わる理由
同じプロンプトを別のモデルに投げると結果が大きく変わるのは、単なる学習データの違いだけではありません。プロンプトの「解釈のしかた」そのものが系統によって異なるからです。
ロジック重視の系統では、指示を細かく構造化して渡すほど精度が上がります。被写体・構図・配置・文字要素・余白・アスペクト比を分解して列挙する、いわば仕様書型のプロンプトが機能します。実際、この系統のモデルは生成前に構図や文字配置を推論する「思考モード」を搭載しており、指示の論理構造を読み取る前提で設計されています。曖昧な指示を渡すと、モデル側が勝手に整合性を取ろうとして、意図しない無難な画面になりがちです。
一方、感覚重視の系統では、細かく指定しすぎるとかえって魅力が失われます。「夕暮れの逆光」「フィルムの粒状感」「気だるい空気」といった雰囲気語を数語置くほうが、モデルの持つ美的な癖が良い方向に出ます。こちらは仕様書ではなく、演出メモに近い書き方が合います。
つまりプロンプトの上手さとは、絶対的な技術ではなく、モデルの系統に合わせて書き分ける適応力です。デザイナー派に演出メモを渡しても情報が足りず、イラストレーター派に仕様書を渡すと窮屈な絵になる。うまくいかないときにプロンプトを長くする人は多いのですが、まず疑うべきは「そもそもモデルの系統が用途と合っていないのではないか」という点です。系統を変えるだけで一発で解決するケースは、実務でかなりの頻度で発生します。
なぜ最新モデルは日本語の文字化けをしなくなったのか
DALL-EからGPT Image 2へ|世代交代で何が起きたか
日本語ユーザーが画像生成AIに抱いていた最大の不満は、画像内の日本語が崩れることでした。この状況は2025年末から2026年にかけて劇的に変わっています。
OpenAIの画像生成は、DALL-EブランドからGPT Imageシリーズへ完全に世代交代しました。ChatGPTでは2025年12月に既定モデルがDALL·E 3からGPT Image 1.5へ自動的に切り替わり、多くの一般ユーザーは意識しないまま新モデルを使っています。開発者向けのDALL·E 2/DALL·E 3のAPIは、2025年11月14日の告知を経て2026年5月12日に提供終了となりました。旧モデル名での呼び出しはエラーを返す状態です。
そして2026年4月21日、OpenAIは新モデル「GPT Image 2」(製品名 ChatGPT Images 2.0、API名 gpt-image-2)を公開しました。生成前に構図や文字配置を推論するThinking mode、日本語・中国語・韓国語を含む多言語テキストの高精度な描画、複数枚の一貫生成が主な進化点です。Image ArenaのText-to-Image部門では2026年4月29日時点でEloスコア1,507を記録し、初登場1位となりました。
DALL-Eという名前は、画家サルバドール・ダリとピクサー映画『WALL-E』を掛け合わせた造語です。名づけの時点で「絵を描くAI」という思想が入っていたと解釈できます。文字を正確に置くことより、絵として成立させることに重心があった。だからこそ日本語が崩れやすかった、という見方は筋が通ります。
「HTMLで書けるデザインはAIでも描ける」という補助線
なぜロジック型のモデルは文字とレイアウトが強いのか。ここで有効な補助線が「HTMLで書けるデザインはAIでも描ける」という考え方です。
大規模言語モデルは、HTML・CSS・JSONといった構造化されたコードを大量に学習しています。見出しと本文の階層、要素の配置、余白の取り方、色の指定。これらはコードとして記述可能で、モデルはその記述パターンを内部表現として保持しています。画像生成側にこの言語能力が接続されると、「文字を絵として描く」のではなく「レイアウトを設計してから描画する」に近い挙動になる。結果として、雑誌レイアウトやインフォグラフィックのような情報密度の高い画像が安定して出るようになります。
逆に言えば、HTMLで表現しにくいデザインはAIも苦手だという予測が立ちます。1枚の中で書体が何種類も混在し、文字サイズがバラバラで、意図的に整列を崩したような紙媒体的なデザイン。手描き文字と写真とテクスチャが重なる自由なレイアウト。こうした「整然としていないこと自体が価値」のデザインは、構造化の発想と相性が悪い領域です。
したがって、人間らしさや個性を強く出したい制作物では、ロジック型のモデルに寄せすぎないほうが良い結果になります。整然としたものを求めるならデザイナー派、崩れの美しさを求めるならイラストレーター派。この判断基準を持っておくと、モデル選定の迷いが減ります。
主要モデルはどちらの系統か|2026年8月時点の勢力図
GPT Image 2・Nano Bananaファミリー・Grok Imagineの位置づけ
2026年8月時点で、実務で選択肢に入る主要モデルの立ち位置を整理します。
GPT Image 2は明確にデザイナー派です。文字レンダリング、プロンプトへの忠実度、情報密度に強みがあり、詳細ページ・インフォグラフィック・文字入りポスターの適性が高いと評価されています。最大解像度は2Kで、アスペクト比は3:1から1:3まで指定できます。
GoogleのNano Bananaファミリーは、両系統の中間に位置します。現在は最上位の複雑用途向け「Nano Banana Pro」、汎用の「Nano Banana 2」、最速・最安の「Nano Banana 2 Lite」という3階層に整理されており、初代Nano Bananaはレガシー扱いです。Nano Banana Proは空間関係や光と影の方向、材質の物理特性への理解が深く、リアリティや質感表現に強い一方、GPT Image 2はレイアウト構造と文字エンコーディングに最適化された「デザインエンジン」に近い、という比較評価があります。解像度は512/1K/2K/4Kの4段階に対応し、上限ではGPT Image 2を上回ります。
xAIのGrok Imagineは、2026年8月7日に「Imagine Image 2.0」を発表し、10日に一般提供を開始しました。実際の仕事で使える画像を生成することを目標に掲げ、指定した部分だけを変更するマジックワンド編集、領域を細かく選択するセグメンテーション、背景の透明化、最大5枚を参照するMulti-ref editingに対応しています。編集を前提とした設計という点で、急速にデザイナー派へ接近しているモデルです。
Midjourney・Stable Diffusion系は本当に「右脳型」のままか
Midjourneyは長らく「絵心のモデル」の代表格でした。作風の強さと美的な仕上がりで支持を集める一方、画像内の文字は崩れるものという前提が共有されていた。この認識は、2026年に入って更新が必要になっています。
2026年3月17日にリリースされたV8 Alphaは、コードベースを全面的に書き直し、生成速度の大幅な高速化、ネイティブ2K解像度、テキストレンダリングの改善、プロンプト理解の向上を実現しました。日本語を含むチラシ制作の比較検証でも、V7では原形をとどめなかった文字がV8では読める水準に改善したという報告が出ています。さらに2026年7月24日にはV8.2が公開され、同日から既定モデルになりました。公式は美しさ・画質・パーソナライズの改善を挙げ、偶発的な低品質結果を大きく減らしたと説明しています。
つまり「Midjourney=右脳型で文字は無理」という理解は、すでに過去のものになりつつあります。ただし軸足が変わったわけではありません。作風の個性とパーソナライズの深さが主戦場である点は一貫しており、情報密度の高いレイアウト制作で第一選択になるかというと、そこは別の話です。
なお既定モデルの変更は、企業利用では注意が必要です。同じプロンプトでも構図や色、人物の見え方が変わる可能性があるため、過去の制作物と雰囲気を揃える必要がある業務では、バージョン番号を明示的に固定する運用が推奨されています。
2026年の画像生成AI競争は「スピード・画質・レイヤー」の3軸
スピード競争|Nano Banana 2 Liteが示した4秒生成の意味
「きれいな絵が出る」ことはもはや差別化要因ではありません。主要モデルは軒並み一定水準を超えており、競争軸は別の場所へ移っています。その第一が生成スピードです。
Googleは2026年6月30日、Nano Bananaファミリー最速・最低コストのモデル「Nano Banana 2 Lite」(技術名 Gemini 3.1 Flash Lite Image)を発表しました。テキストから画像への生成を約4秒で完了し、価格は1K解像度の画像1枚あたり0.034ドル。Googleの比較デモでは、1分間の生成枚数がNano Banana 2の3枚に対しLiteは21枚という差が示されています。API仕様では2秒未満のエンドツーエンドレイテンシを主要な特徴に掲げています。
スピードが実務にもたらす意味は、単に待ち時間が減ることではありません。試行回数が増えることです。1枚30秒かかる環境では5案しか試せなかったところが、4秒なら30案試せる。方向性を探る初期フェーズで大量のバリエーションを並べ、そこから絞り込むという作り方が現実的になります。
一方で、速度優先モデルには明確な守備範囲があります。Nano Banana 2 Liteは1K向けで2Kや4Kへのアップスケールには対応せず、小さな文字や長い段落の描画、キャラクター一貫性などが改善余地のある項目として公式モデルカードに挙げられています。実務では、Liteで大量に下書きを出し、仕上げをNano Banana 2やProへ渡す3段パイプラインが合理的です。
レイヤー分解の実力比較|Canvaマジックレイヤーとセグメント編集
第二の軸が、生成した画像をレイヤーに分けて編集できるかどうかです。生成AIの画像は基本的に1枚のフラットな画像として出力されるため、「文字だけ変えたい」「ロゴを少し右へ動かしたい」という当たり前の修正ができない。これが実務導入の最大の障壁でした。
この領域で先行しているのがCanvaの「マジックレイヤー(Magic Layers)」です。AIが画像を解析し、人物・物・背景・文字といった要素ごとに自動で分解して個別編集を可能にします。画像内の文字を単なる絵の一部ではなくテキスト要素として認識するため、文言の書き換えやフォントの変更まで踏み込めるのが強みです。2026年3月に登場し、当初は有料プラン限定かつ英語UIのみでしたが、5月末に日本語版でも利用可能となり、7月からは無料ユーザーにも開放されました。対応形式はPNGとJPGです。
Grok Imagine Image 2.0のセグメンテーション編集も同じ方向の機能ですが、要素が小さすぎたり複数のパーツが重なる構図では自動のレイヤー分けがうまくいかない場合があり、その際はブラシで範囲を指定する精密編集を併用する運用になります。
第三の軸が印刷対応可能な画質です。ポスターやチラシをそのまま入稿できる水準、さらにトンボまで出力できるとなれば影響は大きい。現時点では解像度上限4KのNano Bananaファミリーが有利ですが、トンボや裁ち落としを含む入稿データの完全生成に対応したモデルは確認できていません。ここは次の勝負どころです。
実務で「AIっぽさ」を消して成果を出すための考え方
光の制御が最後の壁|物理的整合性が違和感を生む
SNS上で継続的に話題になっているのが、「AIっぽさ」をどう消すかというテーマです。解像度も描写力も上がったのに、なぜか人間には見破られる。その正体の中心にあるのが光の扱いです。
AI画像では、光源の方向や強さに対して被写体の陰影が物理法則と完全には一致しないことがあります。輪郭が不自然に光る、画面全体が均一に明るくなる、影の落ち方と光源の位置がわずかにずれる。個々は些細でも、複合的な違和感として認識されます。加えて、肌がプラスチックのように滑らかすぎる、革のシボや木目といった素材の質感が均一すぎるといった「完璧すぎる」問題も重なります。
これは写真撮影とまったく同じ構造です。カメラの世界では、光の扱い方で写真の良し悪しが決まると言われます。どこから光が来て、どの時間帯で、被写体にどんな影が落ちるか。この理解は物理法則というロジックの領域であり、同時に「どの光が美しいか」という感性の領域でもある。つまり光の制御こそ、左脳と右脳の両方を要求する最終課題です。
実務的な対処としては、プロンプト側で光源の位置・時間帯・レンズ特性まで指定する方法と、生成後に粒状感やビネット、ハイライトのロールオフを加えて意図的に不完全さを足す後処理があります。ただし根本的には、人間が持つ「実際に体験してきた光の記憶」をAIは持っていません。体験に基づく予測をどう補うかが、モデル側の中期的な課題として残っています。
絵心×マーケティング|バナー・サムネイル制作に必要な組み合わせ
最後に、実務者が最も誤解しやすい点を整理します。「絵がうまいAI」は「成果が出る画像をつくれるAI」とイコールではありません。
かわいい猫のイラストや美しい風景であれば、感覚の系統だけで十分に成立します。しかしチラシ、バナー広告、YouTubeのサムネイルはまったく別の仕事です。誰に何を伝えるのか、どの言葉を最も大きく置くのか、視線をどこから動かすのか、競合と並んだときに埋もれないか。これらは市場と読者の理解に基づく判断であり、マーケティングの領域です。
有名な画家が優れたYouTubeサムネイルをつくれるかというと、必ずしもそうではない。この比喩が本質を突いています。サムネイルづくりに必要なのは、世の中の関心を捉え、それを言語化し、視覚に落とし込む力です。絵心という右脳的な要素に加えて、頭脳という左脳的な要素が要る。片方だけでは成果物になりません。
だからこそ、モデル選定は「絵の美しさ」だけで決めるべきではありません。文字を正確に置けるか、指示した情報構造を保てるか、後から要素単位で修正できるか。この3点が揃って初めて、業務に組み込める画像になります。そして最終的に、何を伝えるべきかを決めるのは人間側の仕事です。系統の違いを理解してAIを使い分ける人と、1つのツールに依存する人の差は、2026年後半にかけてさらに広がっていくはずです。
検索意図の分析(ステップ2)
メインキーワード:画像生成AI 2系統
想定される検索意図は次の4層です。
| 層 | 検索意図 | 記事内の対応箇所 |
|---|---|---|
| 顕在ニーズ | 「2系統」という分類が何を指すのか知りたい | H2-1 |
| 潜在ニーズ | 自分の用途にどのモデルを選べばいいか判断したい | H2-3 |
| 比較検討 | 主要モデルの現在地と性能差を確認したい | H2-3/H2-4 |
| 実務課題 | AIっぽさを消したい/業務で使える画像にしたい | H2-5 |
検索者の中心は、画像生成AIを一通り触ったうえで「モデルによって結果が違う理由」を言語化したい中級者層です。単なるツール紹介ではなく、選定の判断軸を求めています。加えて、チラシ・バナー・サムネイルなど成果物が明確な業務利用者が一定数含まれるため、マーケティング視点の記述が滞在時間と再訪率に効きます。
関連キーワード5選(ステップ3)
- 画像生成AI 比較 2026
- GPT Image 2 Nano Banana 違い
- 画像生成AI 使い分け 用途別
- AI画像 AIっぽさ 消す 方法
- 画像生成AI レイヤー 編集
「他の人はこちらも検索」で併出しやすいのは、モデル名の直接比較(GPT Image 2/Nano Banana/Midjourney/Grok Imagine)と、実務課題型のクエリ(AIっぽさ・文字化け・商用利用)です。本記事は両系統を1本で回収する構成にしています。
ファクトチェック・修正表
元音源の発言内容を一次情報および報道で検証し、修正・補足した箇所は以下のとおりです。
| # | 元音源の発言 | 検証結果 | 記事での扱い |
|---|---|---|---|
| 1 | 「Image 2も今年の4月に出てもう4ヶ月経った」 | 正確。GPT Image 2(ChatGPT Images 2.0/gpt-image-2)は2026年4月21日リリース | そのまま採用(日付を明記) |
| 2 | 「DALL-Eは画家のダリさん由来」 | 一部不正確。DALL·Eはサルバドール・ダリとピクサー映画『WALL-E』を掛け合わせた造語 | 「ダリ+WALL-E」と修正して記載 |
| 3 | 「以前のDALL-Eというモデル」 | 補足が必要。DALL·E 2/3のAPIは2026年5月12日に提供終了済み(告知は2025年11月14日)。ChatGPTでは2025年12月にGPT Image 1.5へ自動移行 | 世代交代の経緯として明記 |
| 4 | 「Nano Banana 2 Liteという生成が速いものが出ている」 | 正確。2026年6月30日発表。約4秒生成、1K画像1枚0.034ドル。技術名はGemini 3.1 Flash Lite Image | 数値付きで採用 |
| 5 | 「Nano BananaはGPT Image 2になかなか勝てない」 | 概ね正確。Image Arena Text-to-Imageで2026年4月29日時点、gpt-image-2が1,507、Nano Banana 2が1,271。2026年8月7日時点でもT2I・Image Edit両部門でgpt-image-2が1位 | ベンチマーク結果として補強 |
| 6 | 「Nano Banana」を単一モデルとして言及 | 補足が必要。現在はPro/2/2 Liteの3階層に整理され、初代Nano Bananaはレガシー扱い | ファミリー構成を明記 |
| 7 | 「Grokの新しいモデルImagineでもレイヤーがだいぶできるようになった」 | 正確。Imagine Image 2.0(2026年8月7日発表/10日一般提供)でセグメンテーション、マジックワンド編集、背景除去、Multi-ref editingに対応 | 機能名を特定して記載 |
| 8 | 「Grokはまだテキストの修正ができない」 | 公式発表では未確認。Image 2.0の発表内容に画像内テキストの直接編集は明示されていない | 断定を避け、機能一覧の記載にとどめた |
| 9 | 「Canva AIのマジックレイヤーが一番進んでいる」 | 機能面は正確。Magic Layersは画像を要素分解し、画像内文字をテキスト要素として編集可能。2026年3月登場→5月末に日本語版対応→7月に無料ユーザー開放 | 提供時期の変遷を追記 |
| 10 | 「Midjourney、Stable Diffusionは右脳派・イラストレーター派」 | 現状は要更新。Midjourneyは2026年3月17日のV8 Alphaでテキストレンダリングを大幅改善、7月24日のV8.2が既定モデル化 | 「軸足は変わらないが文字は改善済み」と補正 |
| 11 | 「GPT Image 2は裏でJSONというコードで書かれているっぽい」 | 未確認の推測。OpenAIは内部表現を公開しておらず、一次情報での裏付けなし | 断定を避け、「HTMLで書けるデザインはAIでも描ける」という理解の補助線として再構成 |
| 12 | 「4K・8K、印刷データ、トンボまで出せたらすごい」 | 一部実現済み/一部未実現。Nano Bananaファミリーは4K対応、GPT Image 2は最大2K。トンボ付き入稿データ生成に対応したモデルは確認できず | 現状の到達点として整理 |
参考・出典一覧
OpenAI / GPT Image 2
- OpenAI「ChatGPT Images 2.0 が登場」https://openai.com/ja-JP/index/introducing-chatgpt-images-2-0/
- 一創「GPT Image 2(ChatGPT Images 2.0)とは?」https://www.issoh.co.jp/tech/details/11857/
- ナレフルチャット「うさぎでもわかる!GPT-image-2」https://www.knowleful.ai/plus/rabbit-intro-gptimage2/
- SUPERNOVA プレスリリース(2026年4月22日)https://prtimes.jp/main/html/rd/p/000000074.000138218.html
DALL·E の提供終了
- 一創「最新はgpt-image-2、DALL-E 3は2026年5月廃止」https://www.issoh.co.jp/tech/details/10713/
- Aibrary「DALL-E 2・3 APIを完全停止」https://aibrary.media/dalle-api-shutdown/
- SHIFT AI TIMES「DALL·E 3とは?」https://shift-ai.co.jp/blog/12503/
- Zenn「DALL·E 3 廃止対応でハマったこと」https://zenn.dev/haruyo/articles/bc7c5806616e99
Google / Nano Banana ファミリー
- ITmedia NEWS「Nano Banana 2 Lite」と「Gemini Omni Flash」公開 https://www.itmedia.co.jp/news/articles/2607/01/news060.html
- Impress Watch「4秒で画像生成するNano Banana 2 Lite」https://www.watch.impress.co.jp/docs/news/2121482.html
- gihyo.jp「高速・低コストの画像生成モデル」https://gihyo.jp/article/2026/07/nanobanana2-lite
- 2Slides「GPT Image 2 vs Nano Banana Pro & Nano Banana 2」https://2slides.com/ja/blog/gpt-image-2-vs-nano-banana
- Apiyi Blog「Nano Banana Pro対gpt-image-2 EC商品画像比較」https://help.apiyi.com/ja/nano-banana-pro-vs-gpt-image-2-ecommerce-product-image-comparison-ja.html
- NOBISHIRO「GPT-image-2 vs Nano Banana 2(Pro)徹底比較」https://www.i-cept.jp/blog/?p=1040
xAI / Grok Imagine
- Impress Watch「Imagine Image 2.0 元画像を保ちながら部分編集」https://www.watch.impress.co.jp/docs/news/2131920.html
- C-BA AI-memo「Grok Imagine Image 2.0とは?」https://ai.cbagames.jp/2026/08/24/grok-imagine-image-2-howto/
Canva / Magic Layers
- ノーブランド「CanvaのMagicLayer(マジックレイヤー)をわかりやすく解説」https://www.no-b.co.jp/canva_magiclayer/
- デザスク「Canvaに待望の新機能マジックレイヤー」https://note.com/jd_designschool/n/n5f1c0c4fa30b
- パソコン市民IT講座「Canvaのマジックレイヤーとは?」https://bemate.co.jp/blogkarasu/2026/05/06/magic-layers/
Midjourney
- WaveSpeed「Midjourney V8とは?」https://wavespeed.ai/blog/ja/posts/what-is-midjourney-v8-features-pricing-how-to-use-2026/
- AI深報「Midjourney V8.2が標準に」https://ai-and-marketing.jp/shinpo/2026-07-27-midjourney-v8-2-default-checklist.html
- AUN「Midjourneyが進化しすぎた件|V8・V8.1の新機能」https://note.com/aun_585/n/nc36e69c62b4b
AIっぽさ・光の制御
- 杉山宣嗣「AI写真はバレる?判定ポイントと見分け方」https://nsp-jp.com/blog/can-ai-photos-be-detected/
- Web Planners「AI画像がAIっぽく見える本当の理由とは?」https://www.web-planners.net/blog/archives/15-ways-to-make-ai-images-look-real.html
- note「AIっぽい画像から抜け出すコツ【2026年版】」https://note.com/outdoorlifestyle/n/n4c58bcabcae8
AIに関するニュース2026年8月分Podcast配信:画像生成AIに2大派閥
#AI #人工知能 #横田秀珠 #生成AI #生成AIコンサルタント #生成AIセミナー #生成AI講師 #生成AI講演 #生成AI講座 #生成AI研修 #生成AI勉強会